DeepSeek Harness で研究データ分析:10 万行の前処理・統計・図表をワンセッションで
22 分のスクリーン録画を全コマ確認した図解ガイド。101,766 行の糖尿病 EHR データセットを dsh に渡せば、前処理・品質監査・Cox 生存時間分析・ジャーナル級図表・整形済み Results 章をひとつのセッションで——API 費用は 3.10 元。
最終更新: 2026-10-01
実際の研究データは扱いにくいもの:符号化された列、混在する型、10 万行単位のボリューム。このガイドは 22 分のスクリーン録画(出典はページ末)をなぞったものです。研究者が実在の公開データセット——10 万行の US Hospitals Diabetes EHR 入院テーブル——を DeepSeek Harness に渡すと、ひとつのセッションでデータ把握・前処理・品質レポート・Cox 生存時間分析・論文級の図表・整形済み Results 章が揃い、費用はペットボトル 1 本ほど。
以下の各ステップはすべて全コマ確認済みのスクリーンショットで、元動画の該当秒へのディープリンク付き。まだ dsh を導入していない方は、まずこちらから: DeepSeek Harness とは?dsh プラグインとは?
TL;DR
- ▸実在の 101,766 行 EHR テーブルにプロンプト 1 つ:常時「No」の 2 列(examide・citoglipton)を除外し、特徴量は 50 → 48、型変換でメモリ 91% 圧縮——248.7 MB → 21.5 MB。
- ▸エージェントは自分で自分を監査:監査スクリプトのバグ 2 件を検出し、4 回の Edit で修正して再実行、データ品質レポートを提出——6 ラウンド 98 ステップ、手書きコードはゼロ。
- ▸中国語の Cox プロンプト(「変数の選択はお任せ」)に「Nature 級の図表」を追加するだけで、lifelines / R survival のコードと dpi=300 の PNG+SVG 図表が手に入る。
- ▸Results 章は整形済み Word 文書として出力——数値はすべて実計算、三線表ルール準拠——録画全体の API 費用は 353 リクエスト合計 3.10 元。
10 万行の生テーブルから Results 章まで
パート 1 · 初回セットアップ
- 1
自分の DeepSeek API キーをつなぐ
すべて自分のキーで動きます。録画では作者がまず開発者プラットフォームの利用状況ページを開き——残高 5.67 元、累計消費 14.32 元、それまでの 254 リクエスト・3,255,296 トークンを確認——新しいキーを作成して dsh の「API キーを追加」ダイアログに貼り付けます。このページは最後のステップで明細確認に使うので、開いたままに。
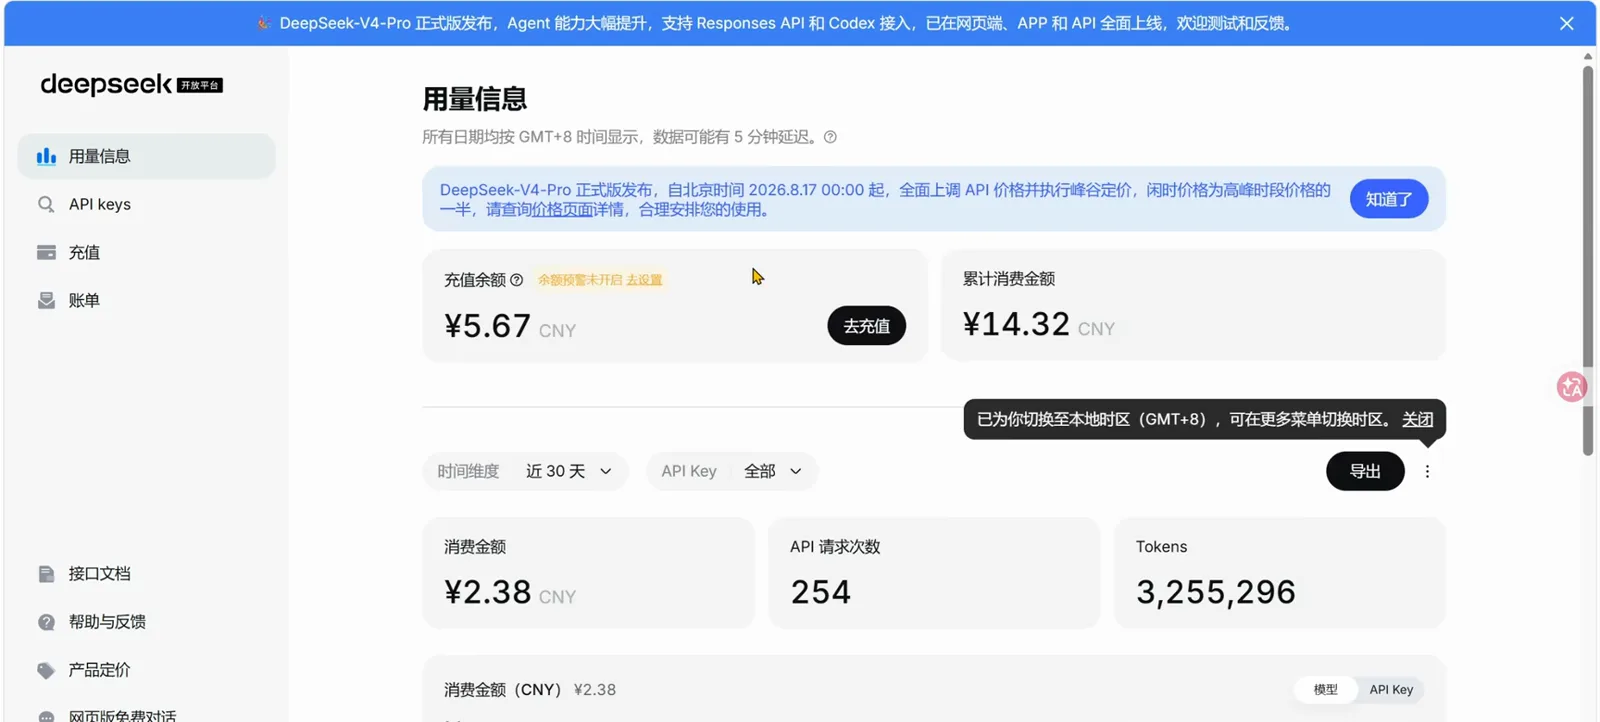
まず DeepSeek 開発者プラットフォームでキーを取得——このページは最後の明細にもなります2:45 から見る - 2
モデルを選ぶ:V4-Flash か V4-Pro か
07_医学与健康医療(Medical & Health)ワークスペースで新規セッションを開くと、モデルピッカーには 2 つだけ:デフォルトの DeepSeek-V4-Flash(High 推論設定)と DeepSeek-V4-Pro。前処理・統計・図表・Word 作成までの 22 分間はすべて V4-Flash で走りきります。Pro は重い処理向け。
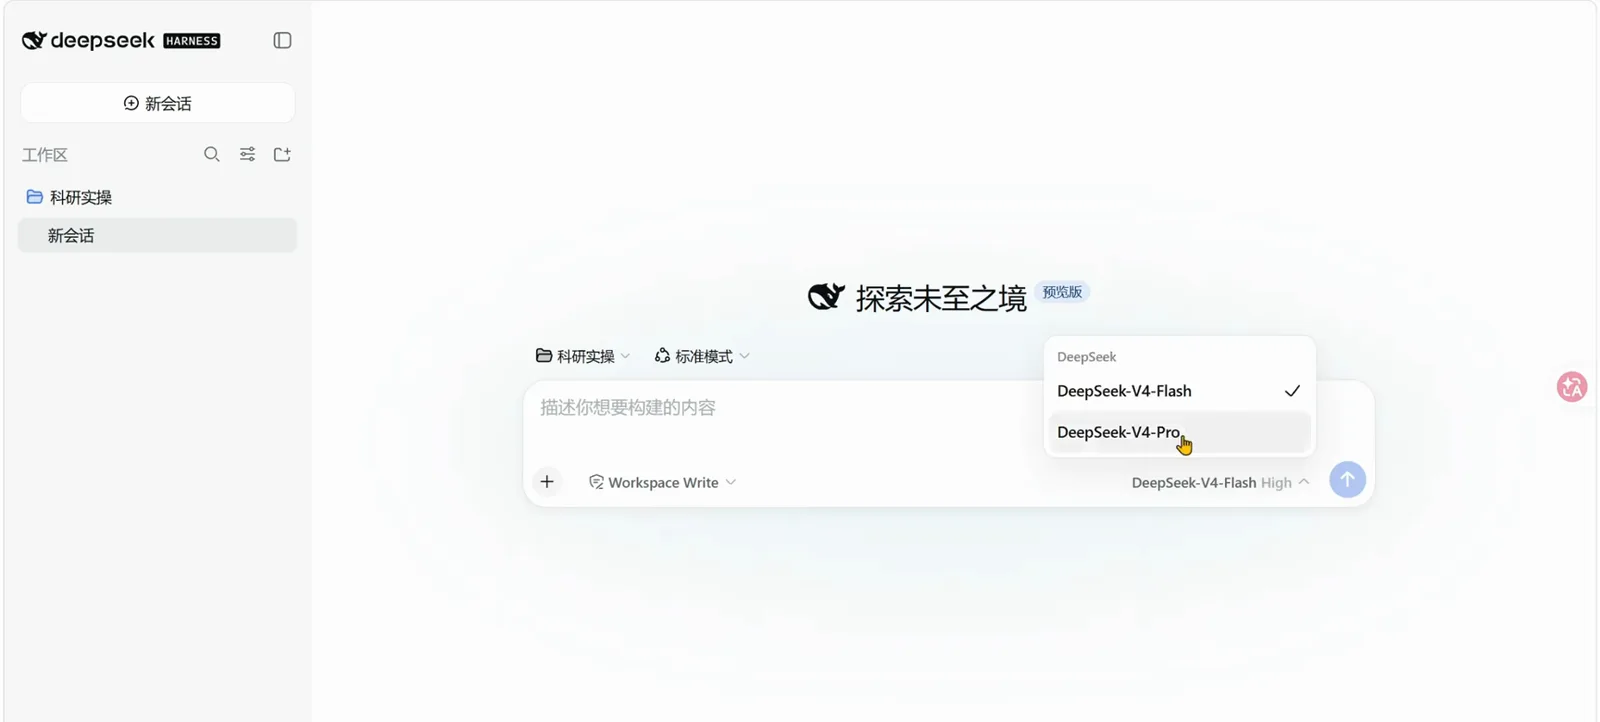
ピッカーに選択肢は 2 つ:全行程 V4-Flash(High)で走りきる3:45 から見る - 3
生の 10 万行テーブルをそのまま渡す
デモデータは実在の公開データセット US_Hospitals_Diabetes:101,766 件の入院レコードを持つ 10 万行 EHR テーブルです。Excel で開くと意図的に「扱いにくい」状態——数式バーには符号化された race の値、薬剤列は No / Steady / Down / Up だらけ、1 行ごとに型が混在。そのまま dsh に渡せば OK。デコードはエージェントの仕事です。
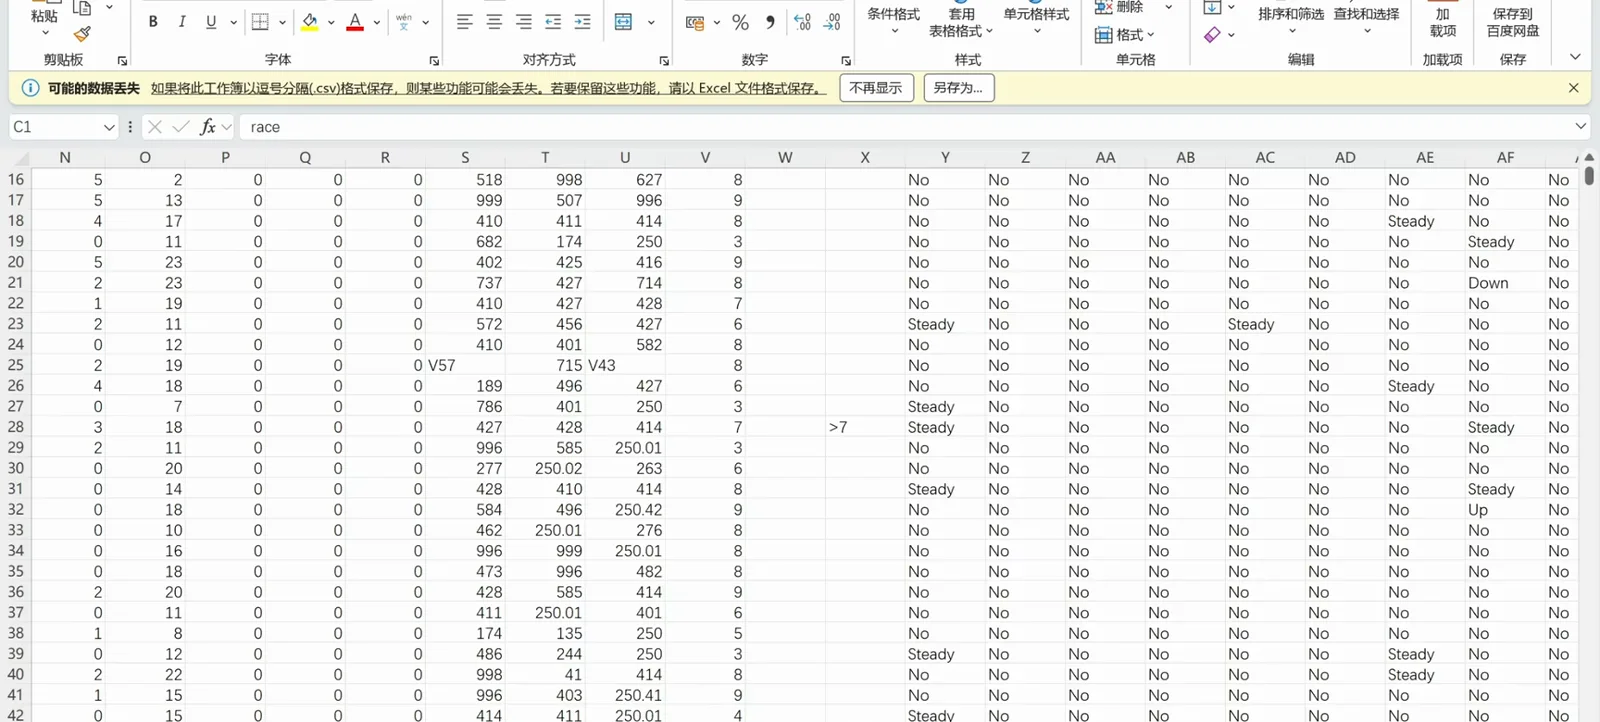
生テーブルはこう見えます:符号値と混在型のままそのまま渡す5:00 から見る
パート 2 · 前処理・監査・統計
- 4
プロンプト 1 つで前処理開始——エージェントが自分自身を点検
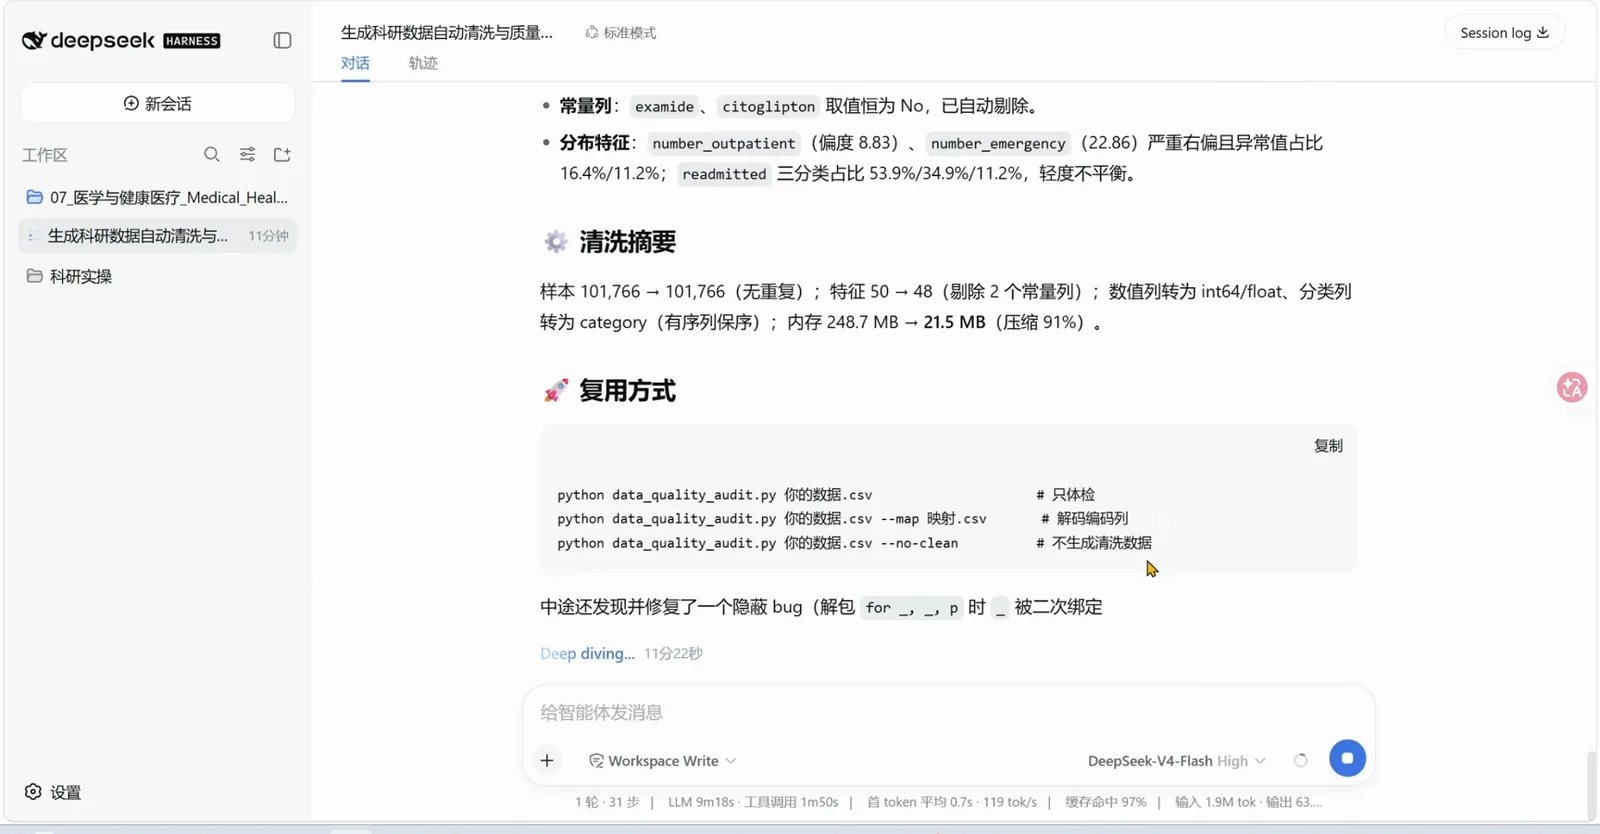
中国語の一文——データ把握・クリーニング・品質監査——でパイプラインが動き出します。セッションは data_quality_audit.py を書き、さらに自分のコードのバグ 2 件を検出:型推論の順序が age/weight 区間列で to_datetime 警告を出す問題と、欠損辞書のタプル取得ミス。4 回の Edit、PowerShell での再実行、01_Diabetes_EHR_data_quality_report.md の読み返し——6 ラウンド 98 ステップ、LLM 24分07秒、キャッシュヒット 99%。残されたスクリプトは再利用可能:
$python data_quality_audit.py 你的数据.csv # 只体检$python data_quality_audit.py 你的数据.csv --map 映射.csv # 解码编码列$python data_quality_audit.py 你的数据.csv --no-clean # 不生成清洗数据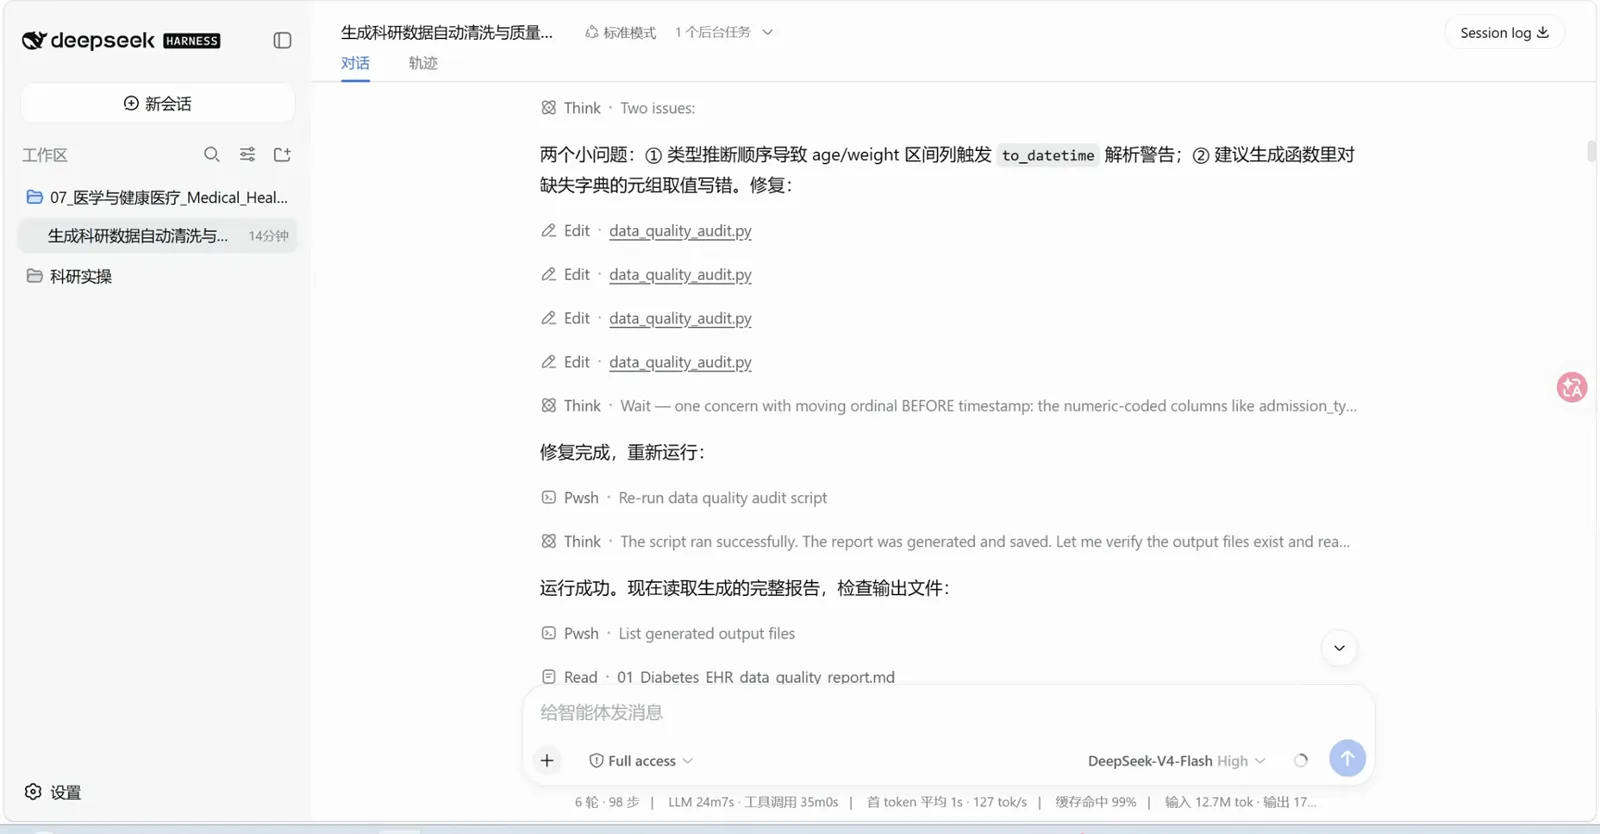
自己点検:4 回の編集・再実行・レポート読み返し、人手はゼロ1:00 から見る - 5
ペルソナプロンプトで統計検定を追加
統計も同じやり方。録画では「あなたは腫瘍と慢性疾患の生存時間分析統計家です……Python lifelines / R survival で Cox 比例ハザード回帰コードを書いてください」というペルソナを入力し、追跡時間・イベント変数・層別化・共変量はあえて空欄(「必要な変数はあなたが決めて」)、最後に「あなたは Nature 級の研究図表ビジュアライザーです」を添えます。この時点で入力ボックスの上では、レポート検証が examide の除外とクリーニング後 CSV の構造確認を済ませています。
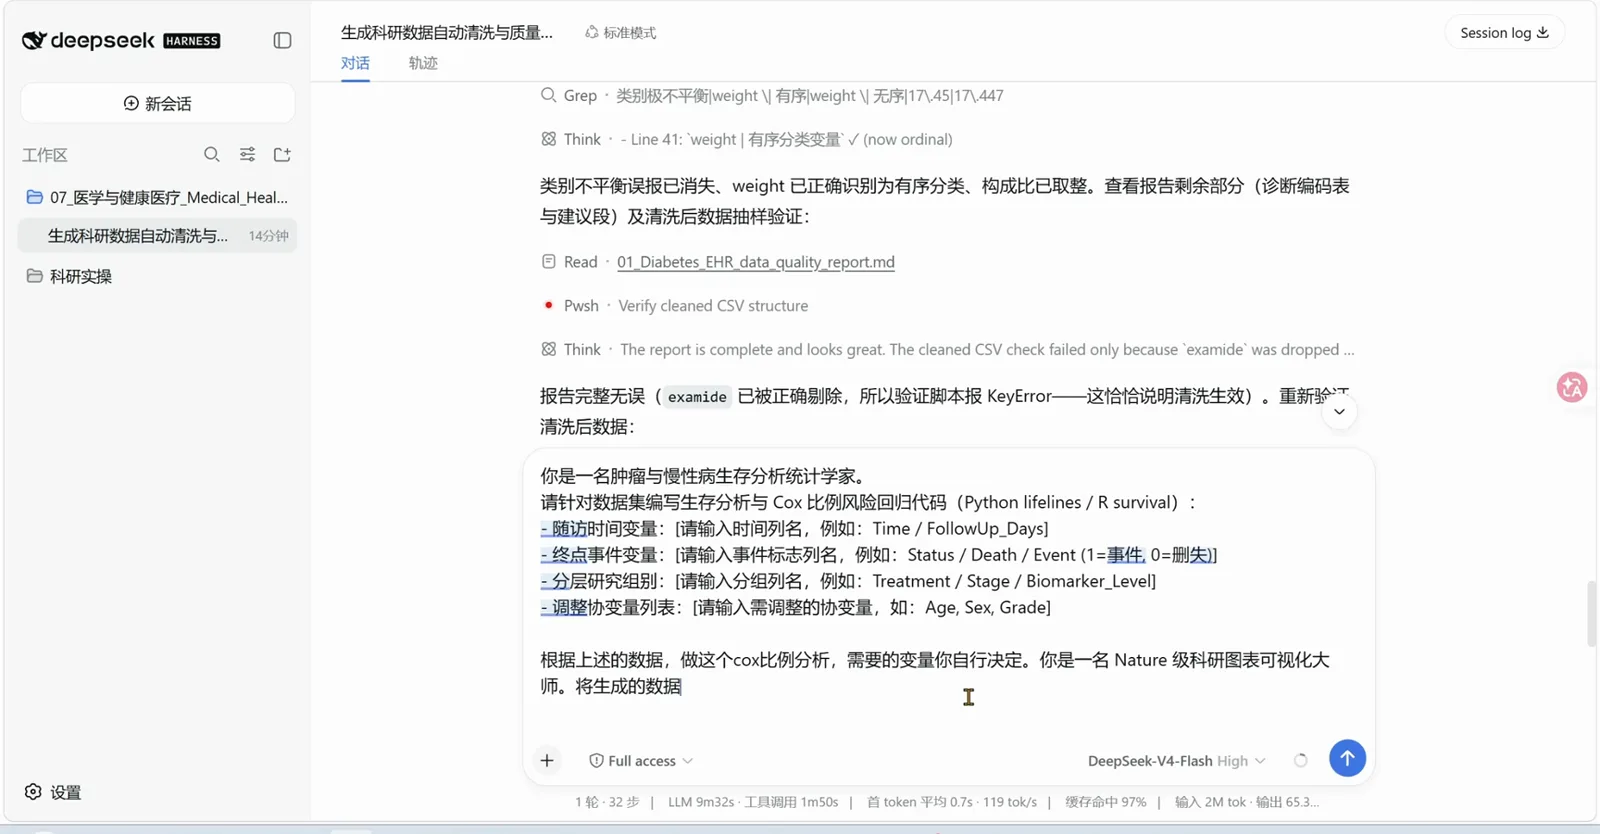
中国語のプロンプト 1 つで:Cox 回帰の変数選択はエージェントに、図表も一緒に依頼10:15 から見る
パート 3 · 図表・論文・明細
- 6
ジャーナル級の図表は成文化された仕様どおり
図表がきれいなのは運ではありません。作者は 16 ページのプロンプトマニュアル(出典を参照)を保守していて、11 ページ目に raincloud 図のレシピを固定しています:半分バイオリン KDE + 箱ひげ図 + ジッター散点(alpha=0.6)、有意差ブラケット(p<0.05 / 0.01 / 0.001)、Nature/Lancet パレット #4DBBD5 #E64B35 #00A087 #3C5488、上部・右側軸の削除(sns.despine)、さらに dpi=300 の PNG とレイアウト用 SVG の保存をハードルールに。
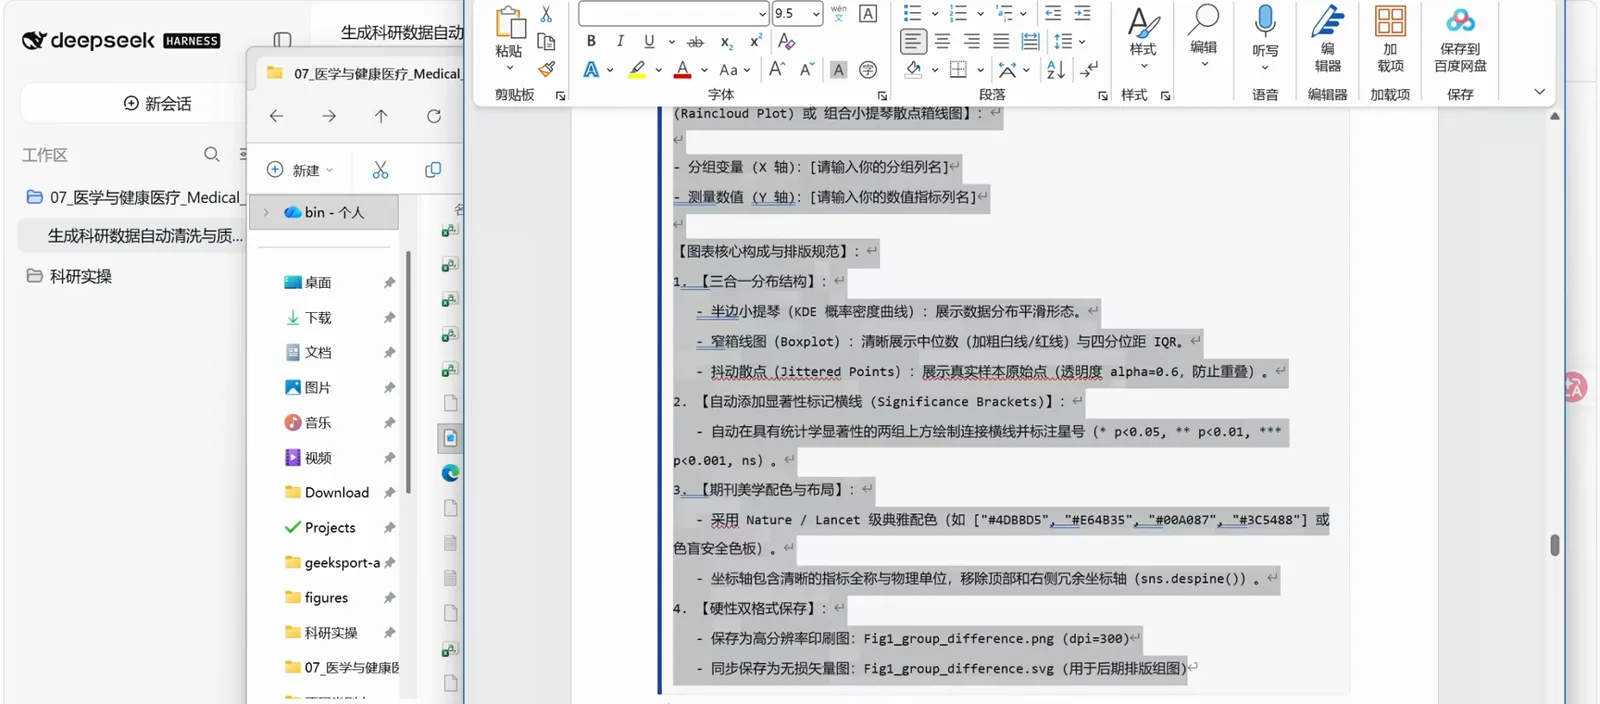
マニュアル 11 ページ目:raincloud のレシピ・配色・有意差ブラケット・dpi=300 の規則15:00 から見る - 7
Results 章は自動執筆——数値は全部実計算
generate_results_docx.py が output_results.docx を生成し、統計量は「でっち上げ」ではなく計算されたもの——セッションの言葉そのまま「統計量はすべて 1,000 行の実データから計算」。デモ版の Results は 1,000 件の入院サブセット:投薬あり 796 例 vs なし 204 例、年齢 59.86±17.54 vs 64.41±17.24(Welch t = 3.35、P < 0.001)、救急入院 21.0% vs 9.8%。Table 1 は標準的な三線表(頂線・底線 1.5 pt、欄頭線 0.75 pt、縦線なし)に整形され、セッションはさらに XML レベルのレイアウト検証(122 個の Run すべてフォント適合)まで実行します。
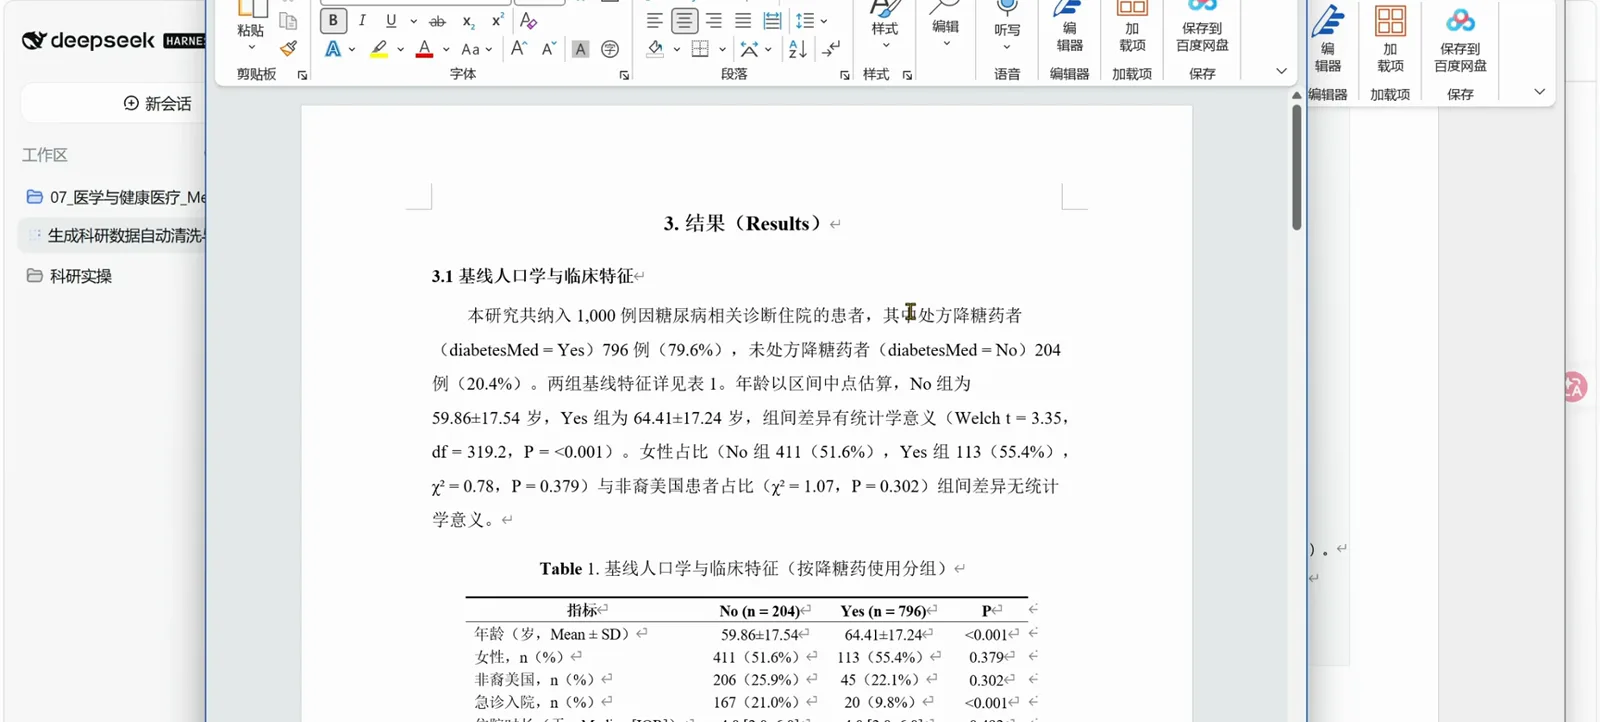
Word 版 Results 章:数値は実計算、Table 1 は標準三線表16:00 から見る - 8
成果はチャットではなくフォルダに全部残る
実行後、ワークスペースフォルダには 23 個のアイテムが:両フォーマットの図表(Fig1_group_difference.png 146 KB + .svg 204 KB)、4 本のスクリプト(raincloud_plot.py、survival_cox_analysis.py、data_quality_audit.py、verify_and_explore_medical_data.py)、survival_analysis_report.md、クリーニング済みの survival_dataset.csv、Word レポート。データを変えて再実行すれば同名ファイルは上書き——成果はセッションの中だけに生きていません。
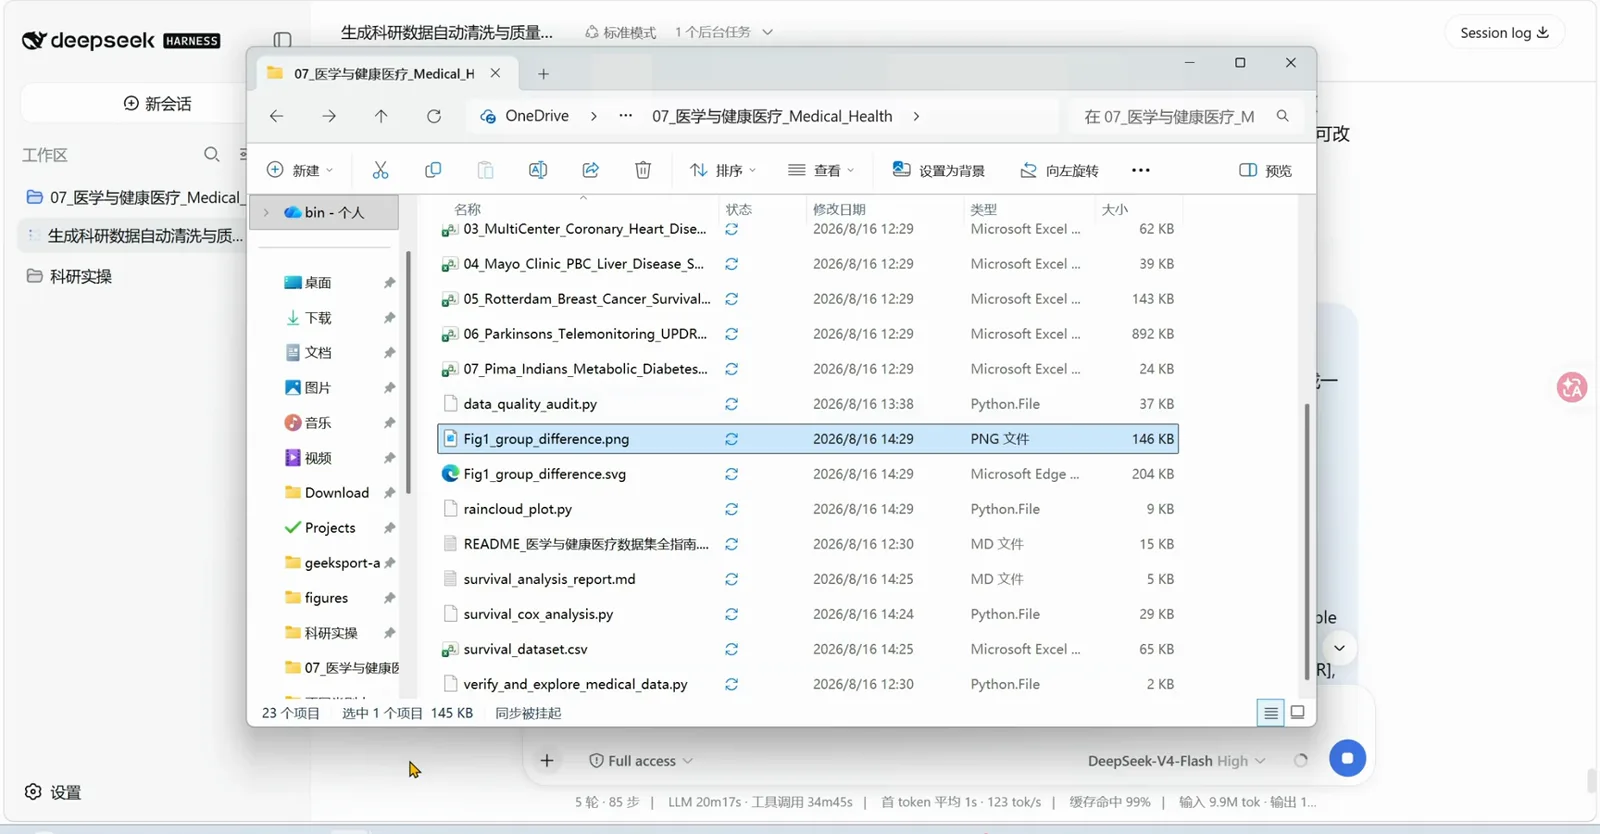
実行後:図表・スクリプト・レポート・クリーニング済みデータ、すべて普通のファイル15:30 から見る - 9
自慢する前に明細を確認
動画は DeepSeek の利用状況ページで締めくくられます:前処理・統計・図表・Word 作成の全体で、表示月の消費は 3.10 元、353 リクエスト、16,137,371 トークン、8 月 16 日のピークは 0.73 元(deepseek-v4-flash)。自分の初回実行後も、同じページで明細を確かめましょう。
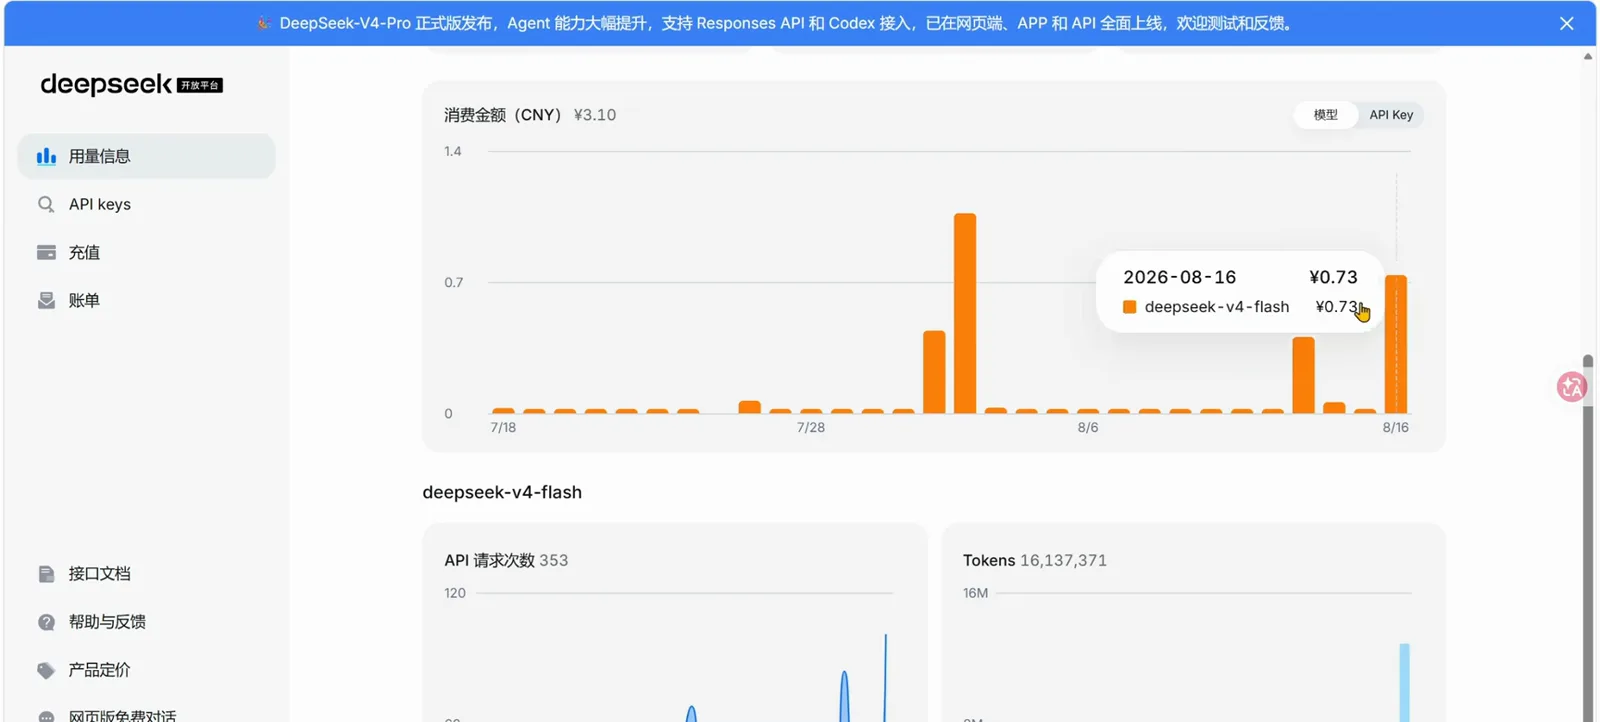
明細:録画された全ワークフローで 3.10 元・1,613 万トークン21:00 から見る
FAQ
研究データを dsh に渡す前に、よく聞かれる質問。
Python も統計もわからなくても大丈夫?
大丈夫です。録画内のプロンプトはすべて普通の中国語。コードはエージェントが書き、デバッグし、再実行します——監査スクリプトのバグ 2 件を自発的に修復したほどです。ただし公開前の統計の妥当性判断はあなた自身の仕事:動画の作者も最後に自分でコードと表を見直しています。
糖尿病データセット専用?
いいえ。US_Hospitals_Diabetes は公開のデモにすぎません。録画のワークスペースには冠動脈疾患・ロッテルダム乳がん生存・パーキンソン遠隔モニタリング・Pima インディアン糖尿病など他の公開データもあり、残されたスクリプトはパラメータ化済み——data_quality_audit.py を任意の CSV に向ければ動き、--map で符号化列をデコード、--no-clean で検査のみ実行できます。
10 万行のテーブルでマシンが悲鳴を上げませんか?
録画は逆の結果を見せています:数値列を int64/float へ、カテゴリ列を順序付き category へ変換した時点で、テーブルのメモリは 248.7 MB から 21.5 MB へ——分析開始前に 91% やせました。プロファイリングを先に済ませるので、数値に触れる前にデータの形が見えます。
Results 章はそのまま論文に使えますか?
「検証可能な初稿」と扱ってください。セッションはデータから統計量を実際に計算し(デモのサブセットは 1,000 件の入院)、docx の XML レベル検証(フォント・行間・三線表の罫線)まで行いますが、作者自身もコードと表を目視確認してから信じています。自分の環境で数値を再現し、統計の専門家にレビューを——このページは手法のデモであり、医学的助言ではありません。
関連ガイド
同じエンジン、隣のワークフロー。
プロンプト 1 つで Excel を統合
ひと回り小さい兄弟ワークフロー:経費シート 3 枚・1,800 行を、ルールとマッピングと受け入れ基準でワンセッション統合。
ガイドを読むひと文でプレゼン資料を作る
Results 章をスライドに仕立てるときに役立つ office プラグインファミリー。
ガイドを読む長文執筆ワークベンチ
章立てと文体ロック——研究パイプラインの執筆側を担うワークフロー。
ガイドを読むDeepSeek モデルを使い分ける
ステップ 2 のピッカーの裏側:V4-Flash と V4-Pro、推論設定——安く済ませる局面と、コストを払う局面。
ガイドを読むトラブルシューティング事典
インストール失敗・起動クラッシュ・更新エラー——自分の実行前に実際の修正事例を確認。
ガイドを読む学術系プラグインコレクション
文献・引用・データ方向の研究向けプラグインで、この分析ワークフローを拡張。
ガイドを読む出典とクレジット
スクリーンショットと画面上の数値はすべて 1 本目の動画から、フル解像度で再読したもの。研究プラグインのリストは 2 本目の動画で裏取り、図表と三線表のルールは作者公開のプロンプトマニュアルから引用しています。データセットは作者が公開データと明示しているもので、表示された統計結果はワークフローのデモであり医学的助言ではありません。