给 dsh 装记忆:meow-memory 安装与记忆机制实操
8 步图文攻略:一条命令装好跨会话记忆插件,看懂首轮整块注入、memory_* 工具自动调用与 dream 空闲整理;全部画面帧检并深链回源视频。
最近更新: 2026-10-03
meow-memory 是 Phant0Meow 为 DeepSeek Harness(dsh)写的跨会话记忆插件(MIT,GitHub 实查 ★140):每个工作区一份 SQLite 记忆库(.dsh-meow/memory.db),记忆分七层存放;静态手册进 system prompt、动态记忆作独立快照注入,KV 缓存友好、零运行时依赖(Node ≥ 22.13)。装好之后,dsh「换个窗口就失忆」的问题就此打住——它是谁、你是谁、你定过的规则,新会话开场一次带上。
这篇攻略跟着实机录制走完 安装 → 重启开新会话 → 首轮注入 → 工具自动调用 → 反思与 dream 整理 全流程,8 张截图全部帧检并深链回源视频。想先看看生态里还有哪些同类插件,去跨会话记忆合集逛一圈。 跨会话记忆插件合集
太长不看
- ▸安装一条命令:dsh plugin --profile web add github:Phant0Meow/dsh-meow-memory,自动编译自动挂载,重启 dsh web 新会话即生效(pnpm ≥ 10 首次可能要按提示放行构建脚本)。
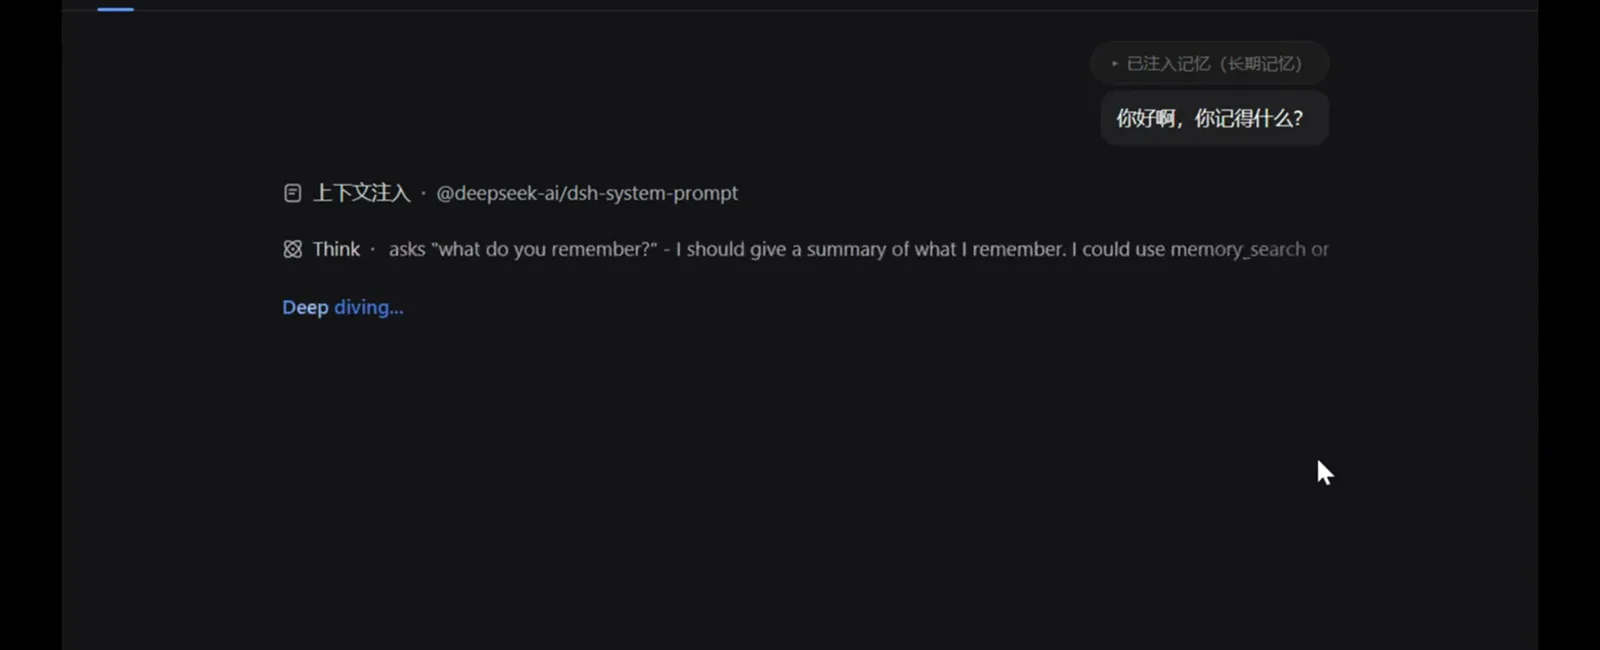
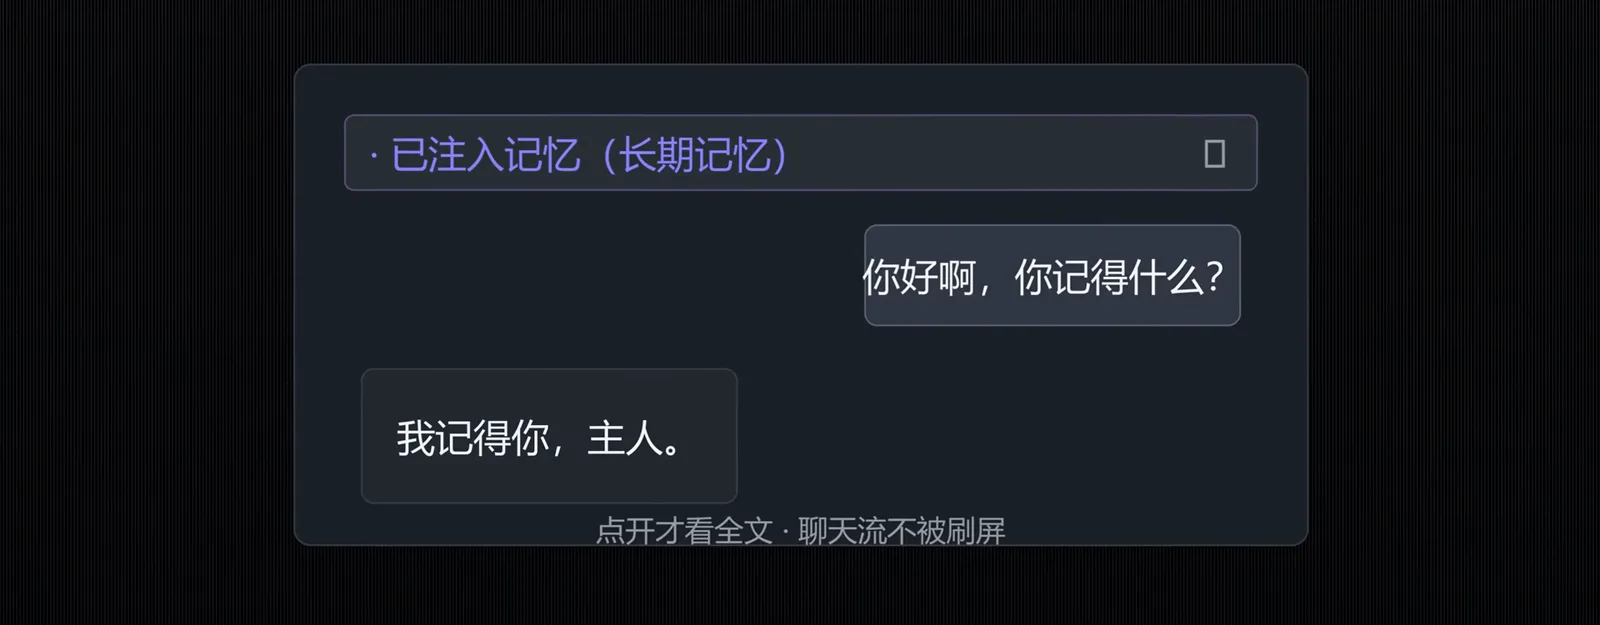
- ▸首轮把长期记忆整块注入(它是谁/你是谁/规则),聊天流里折叠成一条「已注入记忆」小横条,点开才看全文,不刷屏。
- ▸第二轮起每条消息做关键词命中(top-2),memory_remember/search/project 由 AI 自主调用;记忆分 soul/user/project/fact/lesson/topic/rules 七层,按项目隔离。
- ▸空闲 ≥ 180 分钟窗口自动 dream 整理(峰时抑制),连续 7 轮工具调用后触发反思;怕整理烧钱,可用 delegate.model 给整理轮配便宜模型。
从安装到看懂 dream:全程 8 步
装上并第一次对话
- 1
安装 meow-memory
在终端跑下面这条命令(推荐路径):安装时自动编译、自动挂载进 web profile,不用手改 bundles。pnpm ≥ 10 默认拦构建脚本,首次 add 若提示 allowBuilds,按提示把键加进 profile 的 pnpm-workspace.yaml 再跑一次即可。顺手确认 promptLang(zh / en / pt-br)——它决定记忆条目和工具描述用哪种语言写。
$dsh plugin --profile web add github:Phant0Meow/dsh-meow-memory - 2
重启 dsh web,开一个全新会话
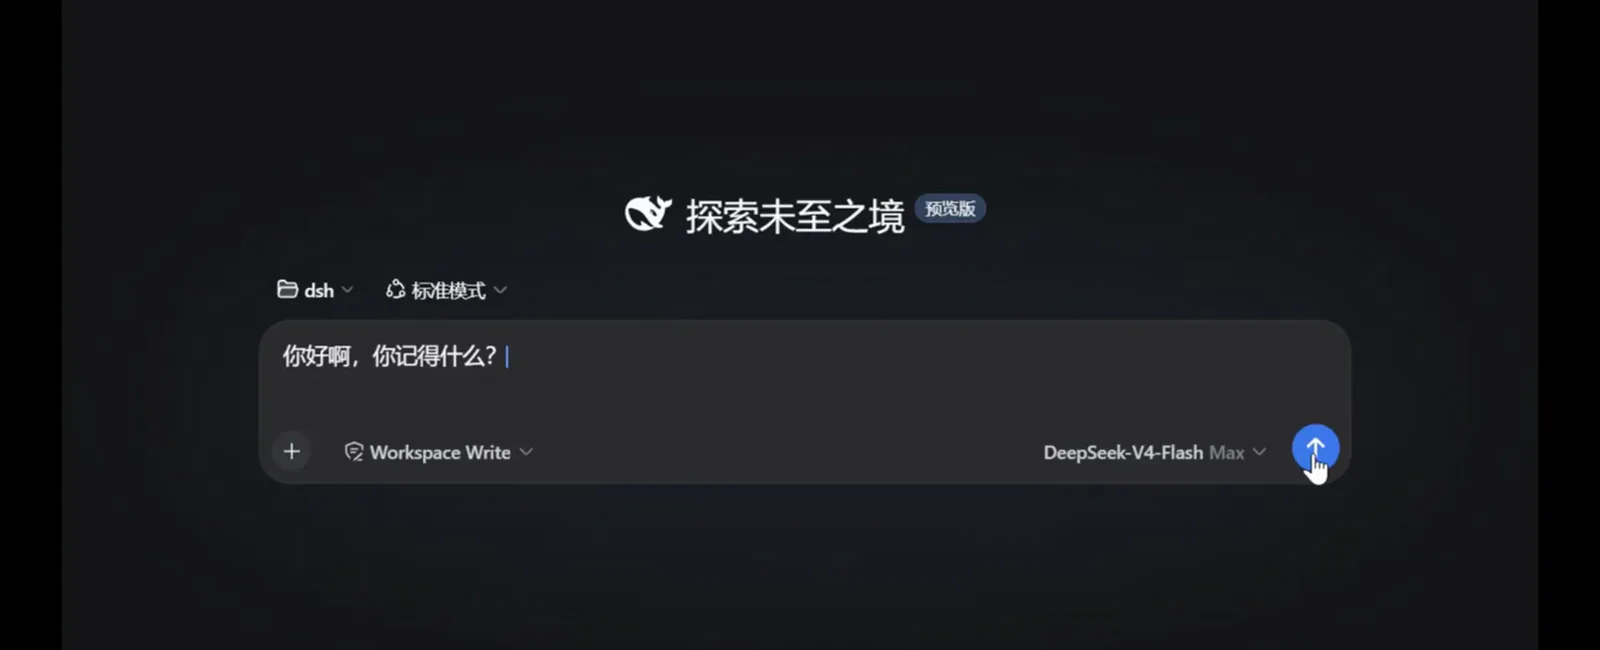
重启后新会话自动加载插件,没有任何要点的按钮。画面里是录制者的全新会话:标题「探索未至之境」,权限档 Workspace Write,模型 DeepSeek-V4-Flash Max,第一句话已经打好——「你好啊,你记得什么?」,正好考验它的记性。
重启之后没有任何配置界面,插件已经在默默待命。看源视频 0:39
看懂记忆怎么转
- 4
第二轮起:关键词命中 + AI 自主调记忆工具
从第二条消息起,每条消息都对 fact/lesson/rules/topic 做关键词命中,最相关的 top-2 垫进上下文;AI 还会不请自来地用 memory_project 拉项目全景——录制里它把 meow-memory、dsh 两个项目接连查了一遍,全程没人工插手。躺在它库里的第 7 条规则「绝不删除任何文件,记忆整理也只标 archived」正在原样生效。
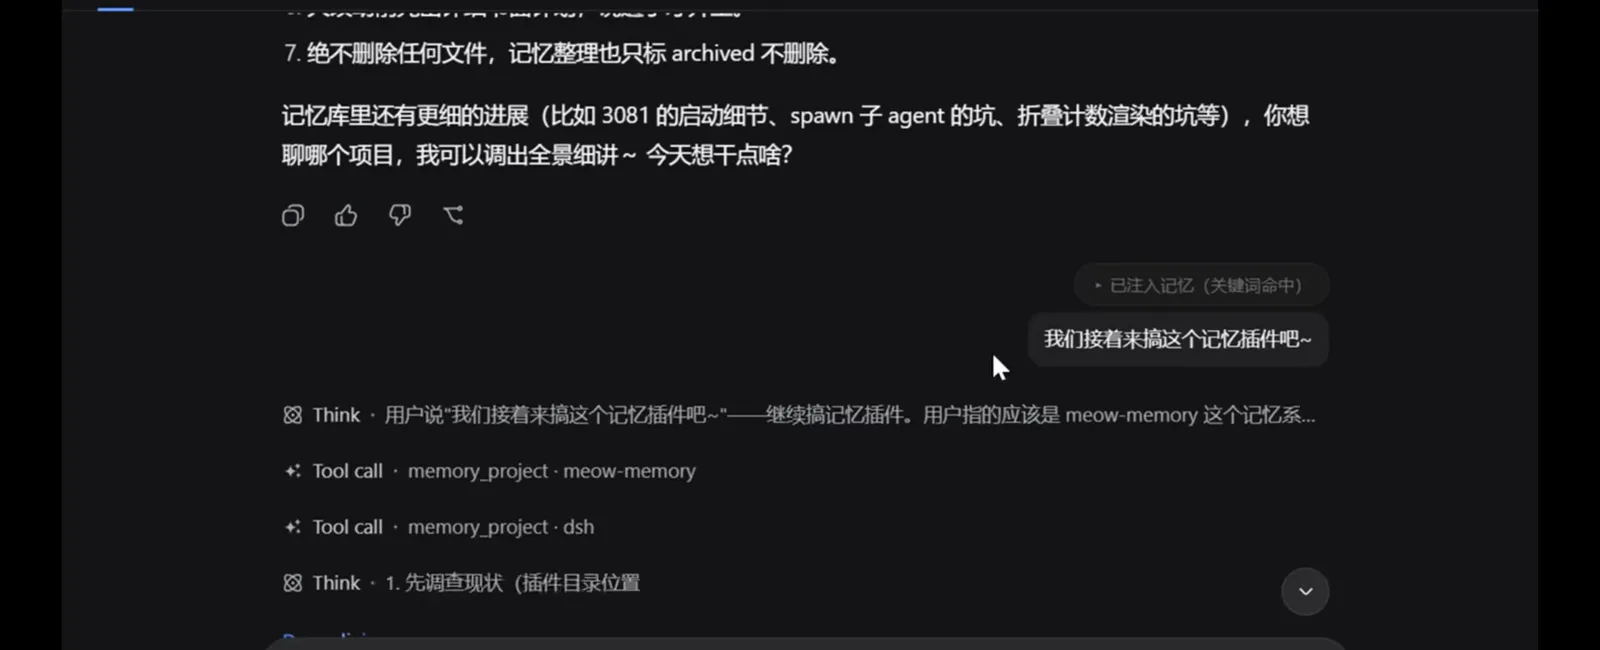
没人为它下指令——模型自己决定把两个项目的全景都查一遍。看源视频 0:54 - 5
考它一个细节:agent 自己去查证
问一个记忆库深处的细节问题,AI 会自己组合工具核实再回答。录制里它甚至纠正了自己上一轮的误判:跑完 shell 检查后确认 meow-memory 是带完整历史的嵌套独立 git 仓库,而不是没纳管的目录。这就是「有记忆」和「硬编」的差别。
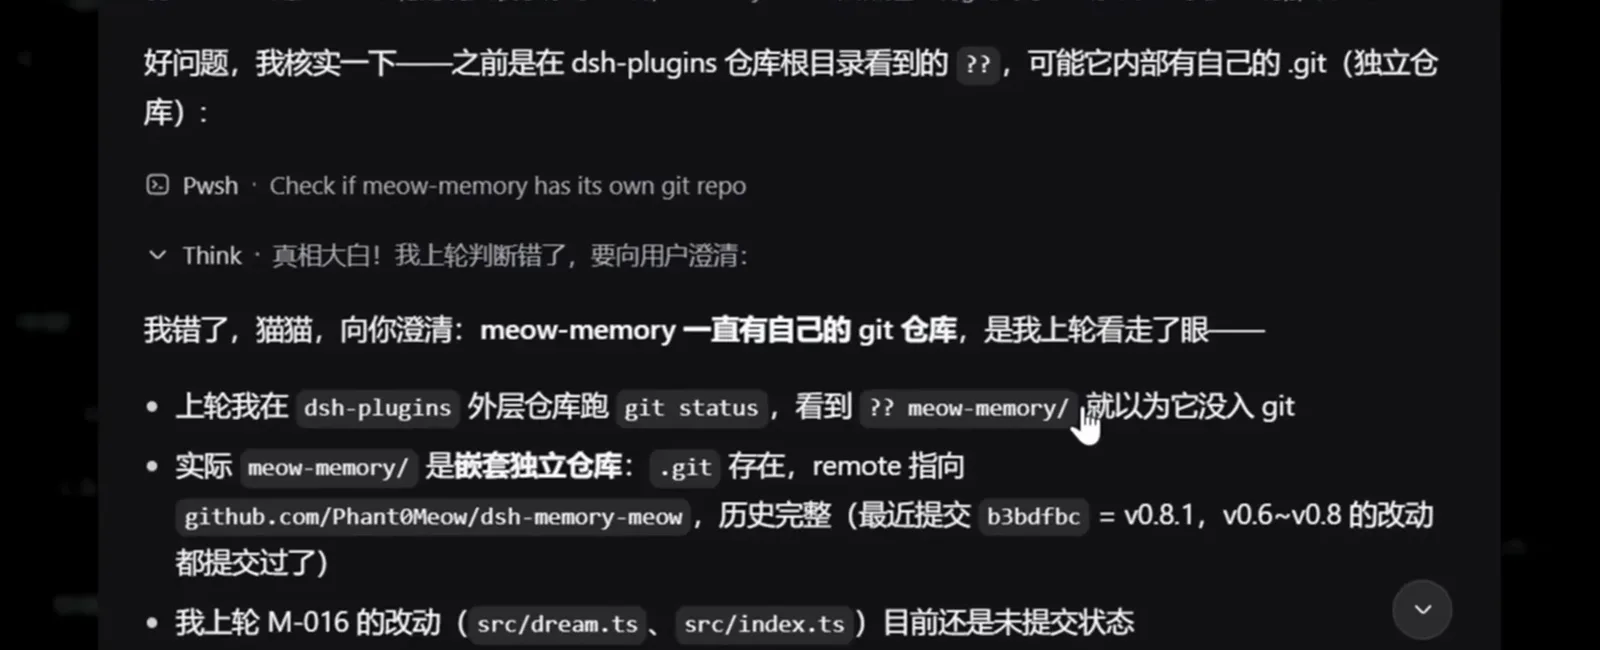
先查证、再回答、错了当面认——有记忆的 AI 不硬编。看源视频 1:12 - 6
反思任务:AI 主动沉淀新记忆
连续 ≥ 7 轮工具调用后,插件会问模型「有没有值得记的」。画面里这轮反思做了三件事:给停在 0.5.1 的旧版本号标 stale(已核实 package.json 是 0.9.0)、更新「v2 重构与迭代」话题、新记一条 README 收尾 todo——每件事都有据可查。
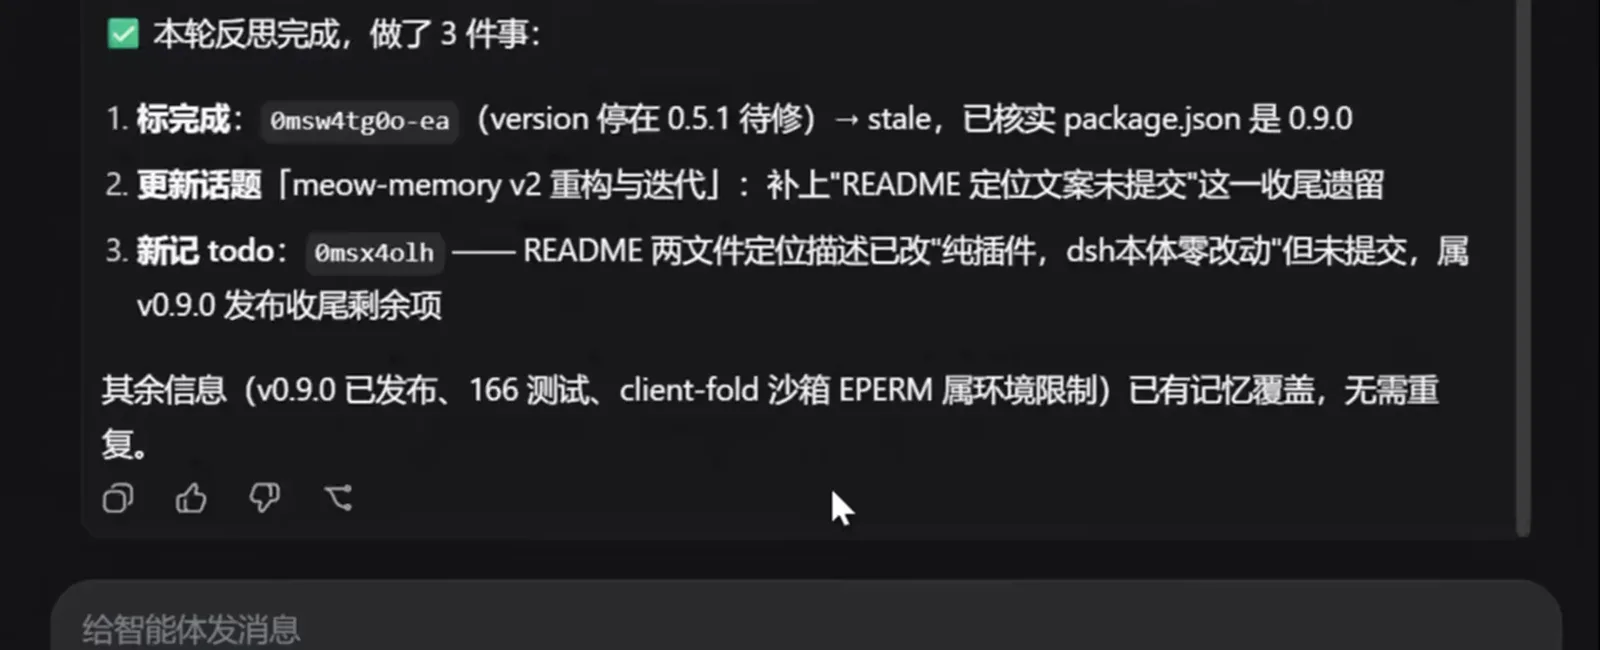
反思轮把散落的进展归档成可检索的条目,事后随时可查。看源视频 1:30
dream 整理与沉淀
- 7
dream:空闲窗口自动整理记忆
窗口空闲 ≥ 180 分钟(默认)就由该窗口自己的主 agent 整理记忆,共三轮(原子记忆 → 话题 → 项目总结);峰时抑制默认按北京时间 09:00–12:00、14:00–18:00 跳过。画面里四条梦境任务折叠横条连成一排:分别更新了 13、10、9、1 条,产物 dream.ts、index.ts、test.mjs 挂在会话里。
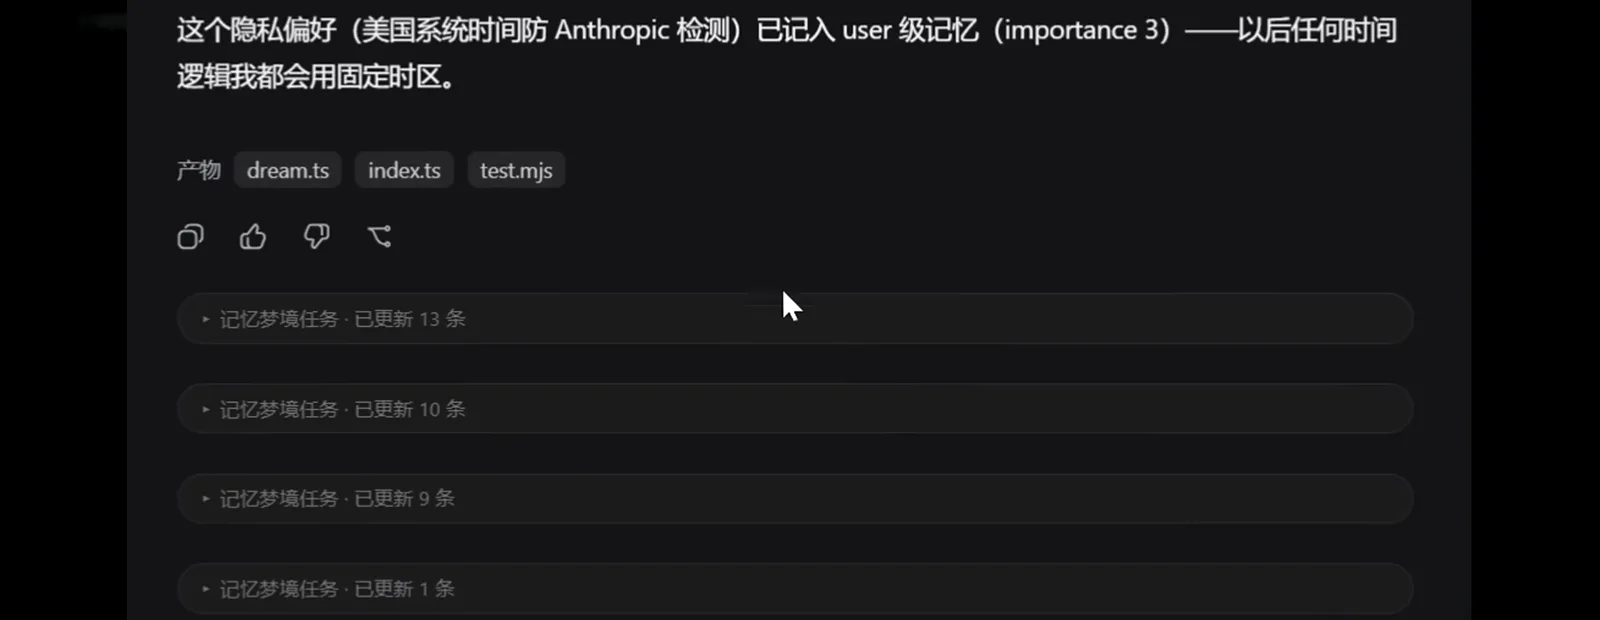
梦境整理挑空闲时段跑,折叠得像后台任务一样不打扰你。看源视频 1:36 - 8
点开梦境条:每条改动都标了去向
展开一条「记忆梦境任务 · 已更新 7 条」:整理对象是 femwa 项目的 13 条记忆,memory_update 逐条调用,每条注明 过时/保留/归档 的处置和理由,最后一句「本组整理完成」。记忆库越用越干净,而不是越堆越乱。
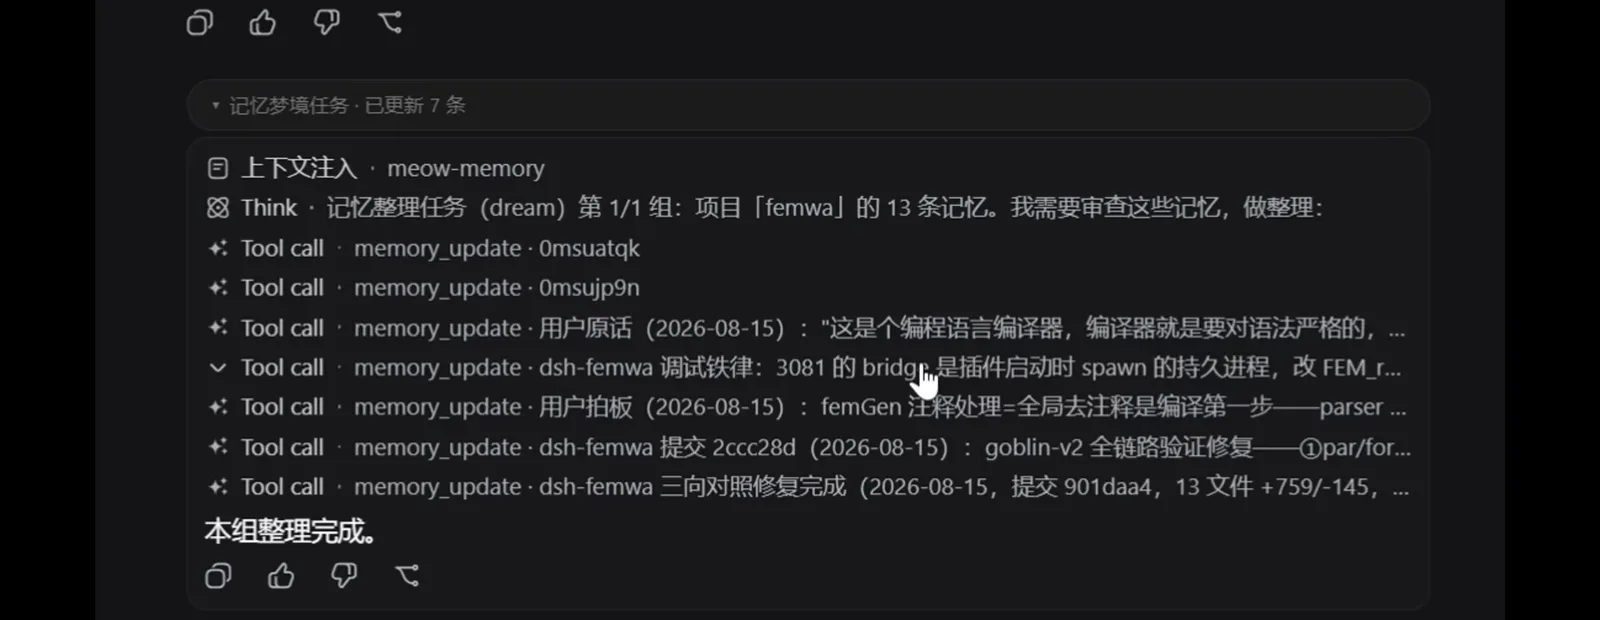
整理不删数据:过时、保留、归档逐条标清去向。看源视频 1:42
七层记忆:分门别类,按项目隔离
meow-memory 把记忆分成七层,每层一张 SQLite 表;project 层还分 overview/structure/decisions/quotes/ops/todo 子类。录制里主库挂着 83 条记忆,与 dsh、meow-eyes、femwa 各自的项目库互不串味。
- ▸soul —— AI 自己是谁:人设、自我介绍、行为边界
- ▸user —— 你是谁:基本信息与偏好,连「固定时区」这种隐私偏好都记成 user 级(importance 3)
- ▸project —— 项目信息,按 overview/structure/decisions/quotes/ops/todo 子类分档
- ▸fact —— 原子事实:一条一事,方便检索与过时标记
- ▸lesson —— 教训与纠正:同一个坑不踩第二遍
- ▸topic —— 进行中的话题,带目标句,跨会话接着聊
- ▸rules —— 设计原则与行为准则,importance ≥ 2 的进首轮注入
记忆插件解决的是「跨会话记住什么」;如果问题反过来——当前窗口塞不下、要砍上下文——那是另一门功课,见上下文压缩指南。 上下文压缩指南
选型:记忆插件怎么挑,坑在哪里
按 ChHsich 的四款速览口径:生态外的通用记忆层(EverOS、MemOS、memsearch、mem0)都是「自动捕获+自动召回」,功能重合度高,装一个就够;memsearch 还能和 Claude Code、Codex、OpenClaw 共用一份记忆。dsh 原生的 meow-memory、mnemon、mindmemos、graph-memory 机制各异,完整目录在跨会话记忆合集。
两条原则请带走:同类记忆层不要叠装;以及这句原话——「安装插件,等于在你的机器上运行第三方代码,权限和你本人相同。安装前先查源码,再决定给不给它这个权限。」
费用坑:整理任务也会烧 token
换个RM 的实录拍下了真实翻车:mnemon 的 idle checkpoint review 以「一次性任务」形态反复触发,整屏十余条,旁边状态栏躺着 73.9M token——「频繁整理记忆费用暴增」的机制一目了然。meow-memory 的对策是峰时抑制与 delegate.model 换便宜模型跑整理轮;花销走势可以盯会话用量追踪。 会话用量追踪
常见问题
关于 dsh 记忆插件安装、开销与选型的六个高频问题。
怎么装?要改配置文件吗?
一条命令搞定:dsh plugin --profile web add github:Phant0Meow/dsh-meow-memory,自动编译并挂载,重启 dsh web 后新会话自动加载,不用手改 bundles。pnpm ≥ 10 首次可能提示 allowBuilds,照提示把键加进 profile 的 pnpm-workspace.yaml 再跑一次即可。想卸载就下 dsh plugin --profile web remove meow-memory。
会不会记忆爆炸、把聊天流刷屏?
两头都有节制:聊天流里注入内容折叠成「已注入记忆」小横条,反思与 dream 轮折叠成单条任务条,点开才看全文;记忆库靠 dream 三轮整理与 archived/stale 标记控制规模,关键词命中只取 top-2,不会把整库倒给模型。
记忆存在哪?会不会上传?
只存本地:工作区内的 .dsh-meow/memory.db(SQLite,基于 node:sqlite,零运行时依赖,Node ≥ 22.13),会话已读记录也在本地 .dsh-meow/sessions/。不依赖任何第三方记忆服务,数据不出你的机器,备份就是拷个文件夹。
dream 整理会不会偷偷烧钱?
dream 默认空闲 ≥ 180 分钟才触发,峰时(默认北京时间 09:00–12:00、14:00–18:00)抑制,不做夜间盲跑;仍介意的话,用 delegate.model 给整理轮配一个便宜模型,或对不重要的会话点「跳过梦境整理」。反面教材见上文 mnemon 费用坑。
和知识库、上下文压缩什么区别?
分工不同:记忆插件存「AI 对你和项目的认识」并自动注入;知识库存文档、按需检索引用;上下文压缩解决当前窗口塞不下的问题。三者可叠加,meow-memory 自己也适配压缩——会话被压缩后下一轮自动重注入长期记忆,不会突然失忆。
记忆插件那么多,到底装哪个?
先分两类:通用记忆层(EverOS/MemOS/memsearch/mem0)功能重合,装一个就够;dsh 原生的 meow-memory/mnemon/mindmemos/graph-memory 机制各异,照目录逐一比较。本页主角 meow-memory 胜在七层结构清晰、整理可控(MIT,★140);无论装哪个,装前先读源码。
相关攻略
把 dsh 玩出花样的其他路子。
来源与署名
全部画面取自 B 站 UP 渐行渐远的烟火的实机录制(片头片尾包装段未取帧,仅取中段 t≈36–120 的 webui 实录);功能事实逐条与 GitHub README 互证(Phant0Meow/dsh-meow-memory,MIT,★140,2026-10-03 实查;仓库名以 GitHub 现名为准——录制片中出现的旧名 dsh-memory-meow 已重定向)。选型对比依 ChHsich 四款速览,费用坑依 换个RM 实录;Hindsight 相关口径来自 全栈二把刀 与 AI产品狙击手——其中「39,000+ stars」是其上游通用项目的数据,dsh 侧适配插件最高仅 ★4,请勿当成 dsh 插件的 star 数引用。每张截图均可点回源视频对应时间点。