DeepSeek Harness 上下文压缩机制:13 帧图文拆解
跟着源码级拆解视频逐帧看懂 dsh 压缩:什么时候触发、裁什么、摘什么,日志又怎么在替换后重建整个会话。
最近更新: 2026-10-15
这页图文基于一支源码级拆解视频,逐帧讲清 DeepSeek Harness 的上下文管理与压缩机制。先说清画面属性:原片是旁白讲解的机制示意动画——作者用幻灯片把压缩流水线一步一步画出来,不是产品界面实录。也正因为是示意,每个机制都被干净地隔离在一页里,适合当架构课本来读。
文中关键数值——80% 默认触发阈值、8192 码点裁剪(保留开头 4096 + 结尾 1024)、16% 近期原文保留——已对照 deepseek-harness 官方仓库文档核验一致(thresholdRatio 0.8、thresholdChars 8192、retainRatio 0.16,2026-09-23 查证)。官方文档没有展开的细节(如检查点的八类信息划分)来自作者小木头对源码的解读,文中已标注。
一分钟版本
- ▸压缩在 dsh 里是插件能力而非内置逻辑:ctx.compaction 是能力接口,compaction-basic 是默认实现;上下文占用接近窗口 80%、服务端报超窗、或你手动输入 /compact,都会触发整理。
- ▸摘要之前先裁剪:超过 8192 码点的工具结果只保留开头 4096 和结尾 1024;裁完若压力达标,连摘要这步模型调用都省了。
- ▸被压缩的历史变成结构化检查点,最近约 16% 窗口原文保留;持久日志完整记录每个事件,模型视图随时可以靠重放重建。
压缩流水线,12 步走完
压缩在架构里的位置
- 1
先看位置:DeepSeek 的请求链里多了压缩一段
视频开场对比请求结构:Codex 式请求是输入 + 上下文 + 模型请求,DeepSeek Harness 在上下文和模型调用之间插入了一个专门的压缩阶段。这页就是整支视频的地图——压缩是请求流水线里的正式一环,不是事后补救。
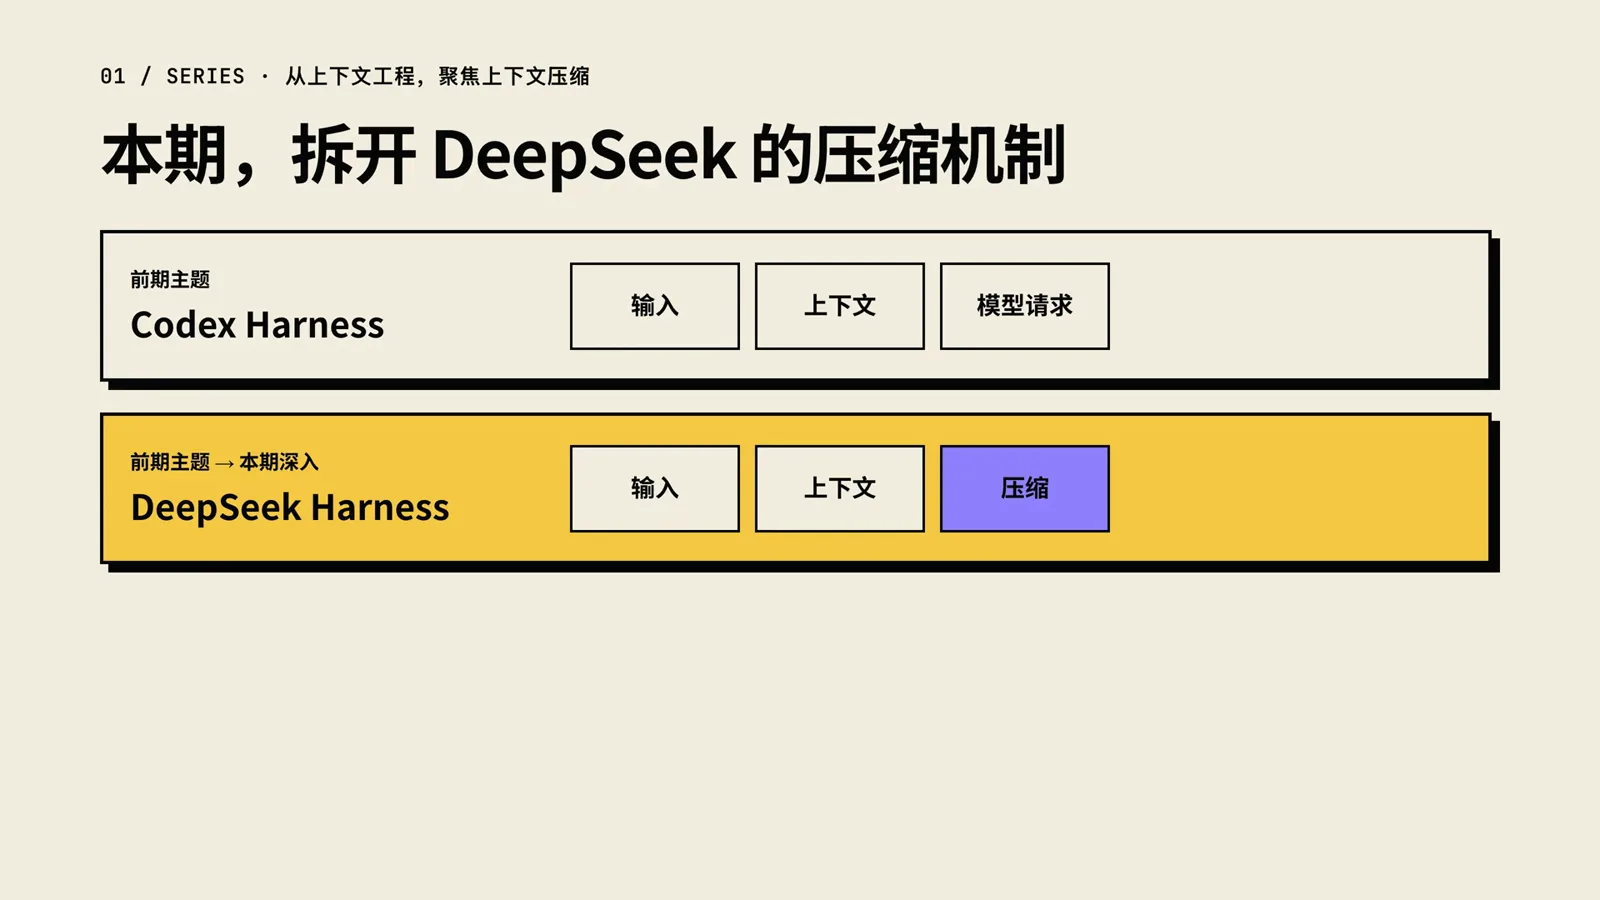
请求流水线在上下文和模型调用之间多出压缩一段。去视频 0:32 处看 - 2
认角色:一项能力,多个插件协作
压缩被拆成一条能力缝:/compact 命令是人工入口,ctx.compaction 是能力接口,compaction-basic 是接口背后的默认实现;旁边还有两个可选搭档——负责计量压力的 token meter 和负责裁剪工具结果的 tool result pruner。把 compaction-basic 换掉,其余照常工作。
$ctx.compaction$dsh-compaction$compaction-basic$command-compact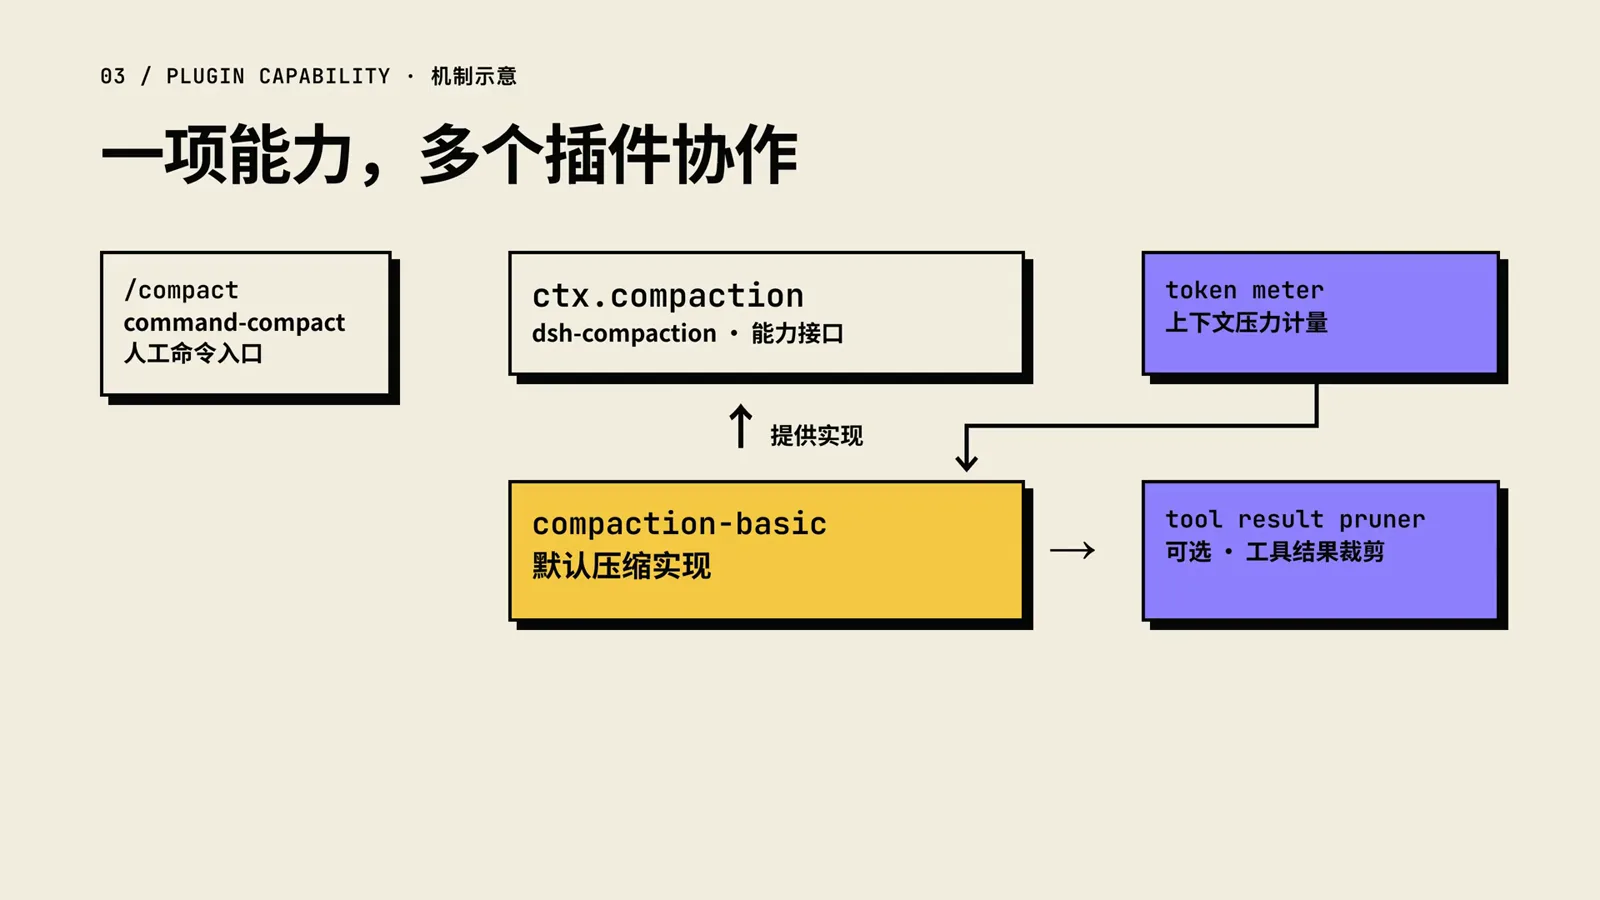
一条能力缝、五个角色:命令、接口、默认实现加两个可选搭档。去视频 2:18 处看 - 3
记住三个触发入口
压缩从三个地方启动。每次请求前的 pre-step 检查会把估算压力和默认 80% 阈值(可按模型配置)比较;服务端已经报超窗时,恢复流程跳过常规阈值、先修复现场;你在 agent 空闲时输入 /compact,则不等 80% 直接按需整理。
$agent/pre-step$context-overflow$/compact · agent idle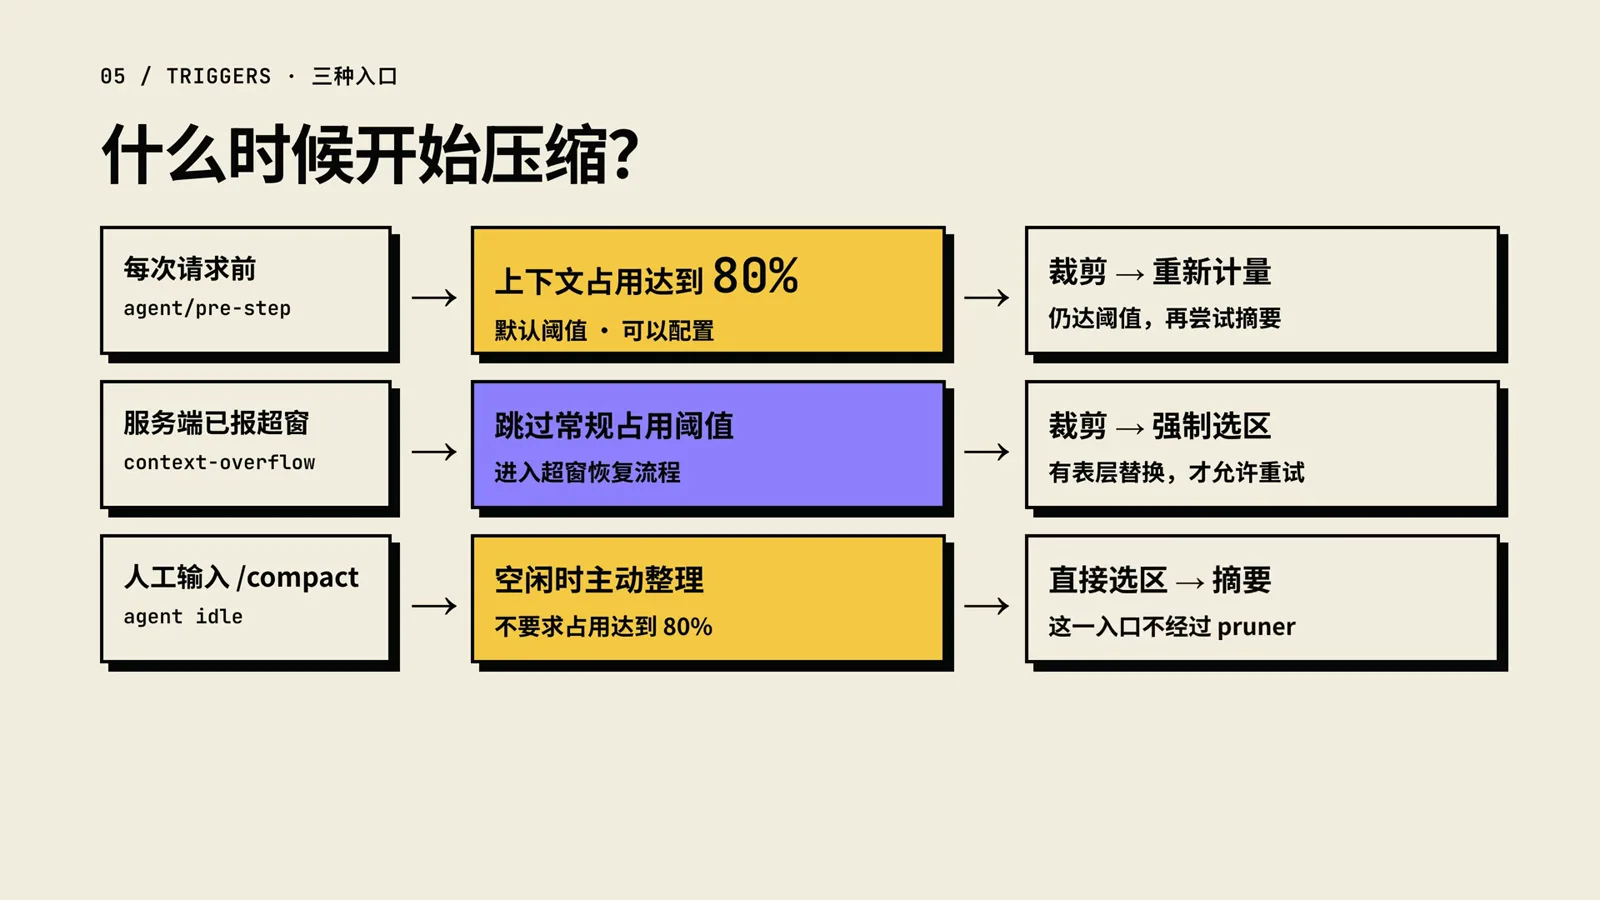
三条启动路径,只有第一条真的等 80%。去视频 3:50 处看 - 4
看懂计量表:提供商读数 + 变化估算
token meter 对自己的定位很诚实:它以最近一次成功调用的提供商用量为锚点,再估算这之后模型可见内容的变化——新增消息往上加,替换可能往下减。片中的进度条是定性示意,不代表实测比例。
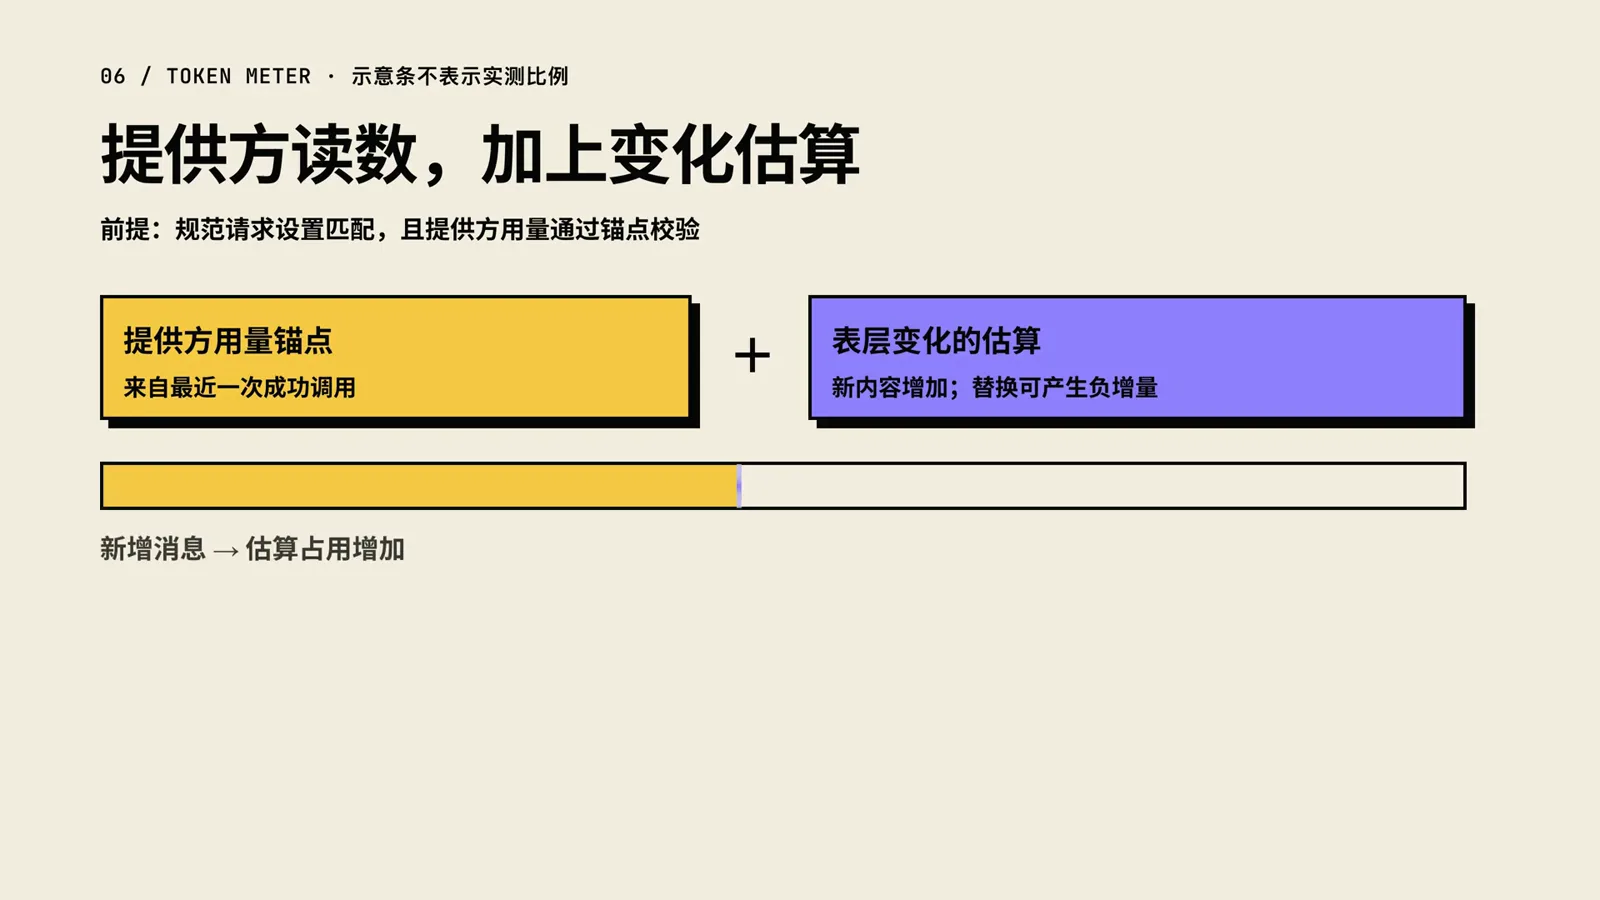
计量表是估算:上次官方读数,加上之后的漂移。去视频 4:20 处看
裁剪、选区与摘要
- 5
先裁日志,再谈测量
第一个杠杆不是摘要,是删除。一条超长工具结果就能占满大半个上下文,把它的中段裁掉,压力可能直接回落到阈值以下。后面几章的机制,都默认这道最便宜的工序已经跑过。
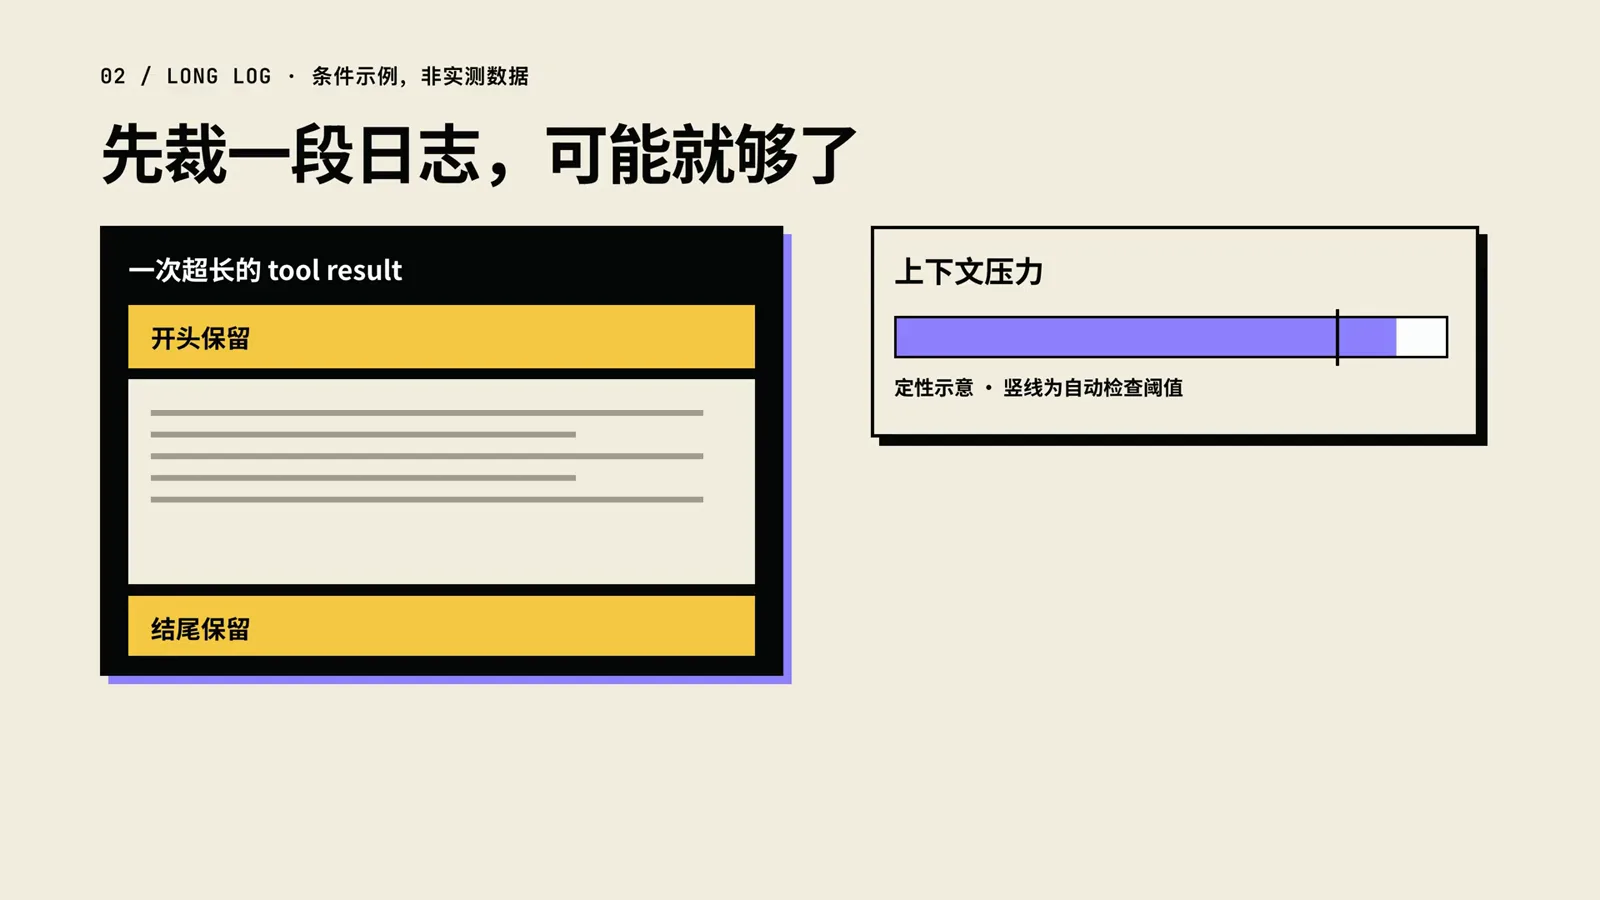
先裁再说——一条巨大的工具结果可能就是全部问题。去视频 1:15 处看 - 6
拆裁剪器:8192 码点,保留 4096 + 1024
工具结果文本超过 8192 个 Unicode 码点(三个 Web 预设当前的配置)就会被重写:保留开头 4096 码点、一条裁剪标记、结尾 1024 码点。计量单位是码点不是 token,而且这一步完全不调用模型。这两个数值与官方 compaction-tool-result-pruner 默认值(thresholdChars 8192、headChars 4096、tailChars 1024)一致。
$threshold: 8192 code points$keep head 4096 + tail 1024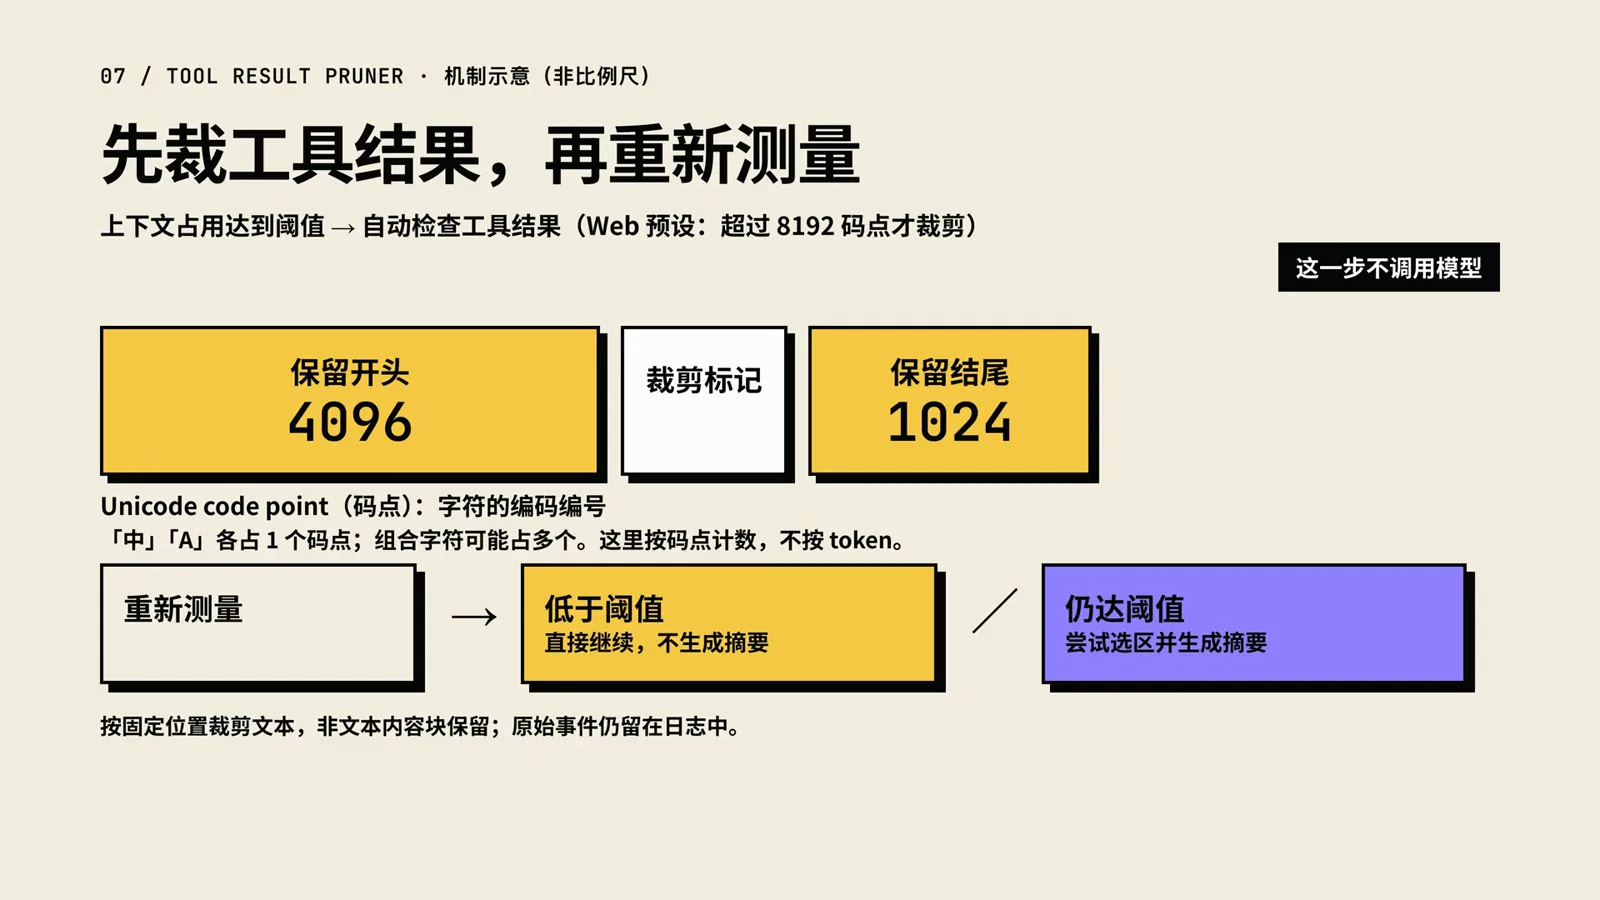
8192 码点是门槛;开头 4096、标记、结尾 1024。去视频 5:40 处看 - 7
选区:近期 16% 原文保留,切线避开配对
裁完压力还超,compaction-basic 就开始选区:从最新消息向前累计,原文保留到大约 16% 窗口预算为止(即官方 retainRatio 默认值),并且切线永远落在工具调用和它的结果之外——配对不拆散。按完整消息节点累计,实际保留量可能略超 16%;此时只是选定区间,还没有生成任何摘要。
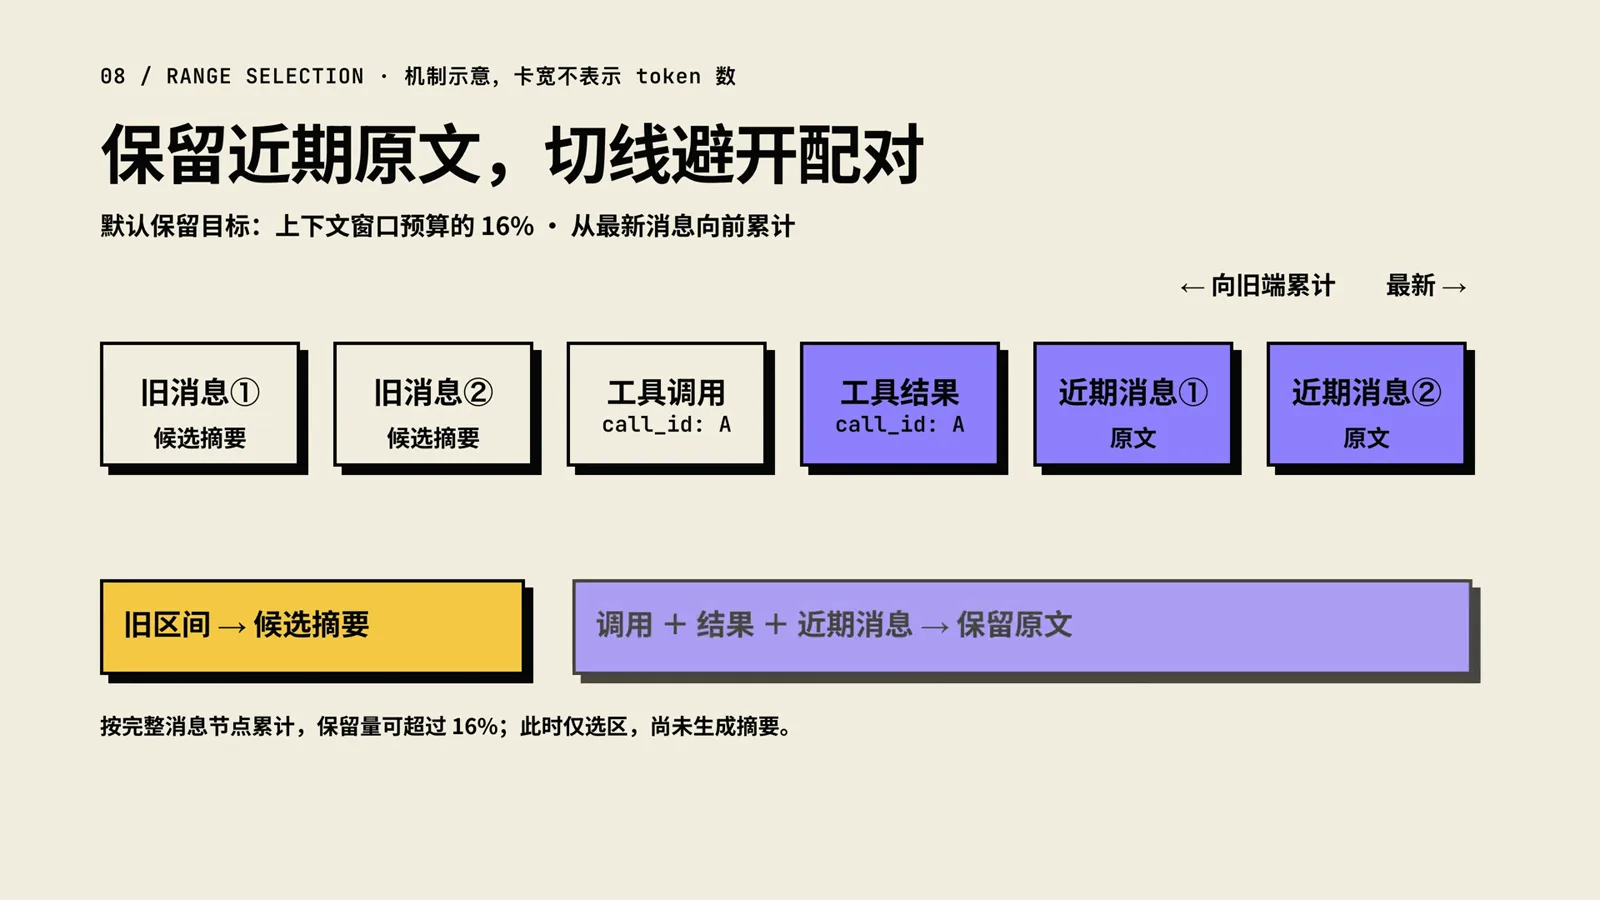
从最新往前走,切线永不落在调用与结果之间。去视频 6:00 处看 - 8
生成检查点:compaction/start 与八类信息
摘要以追加指令的方式运行:请求保留原 system、原 tools 和选定的旧消息,末尾追加一条 user 消息,要求把对话整理成结构化检查点。视频把它画成八类信息——用户目标与意图、关键技术概念、文件与代码、错误与修复、待完成工作、当前工作、下一步行动、关键背景与约束。官方文档确认存在检查点前言,八类的具体划分是作者的示意解读。
$compaction/start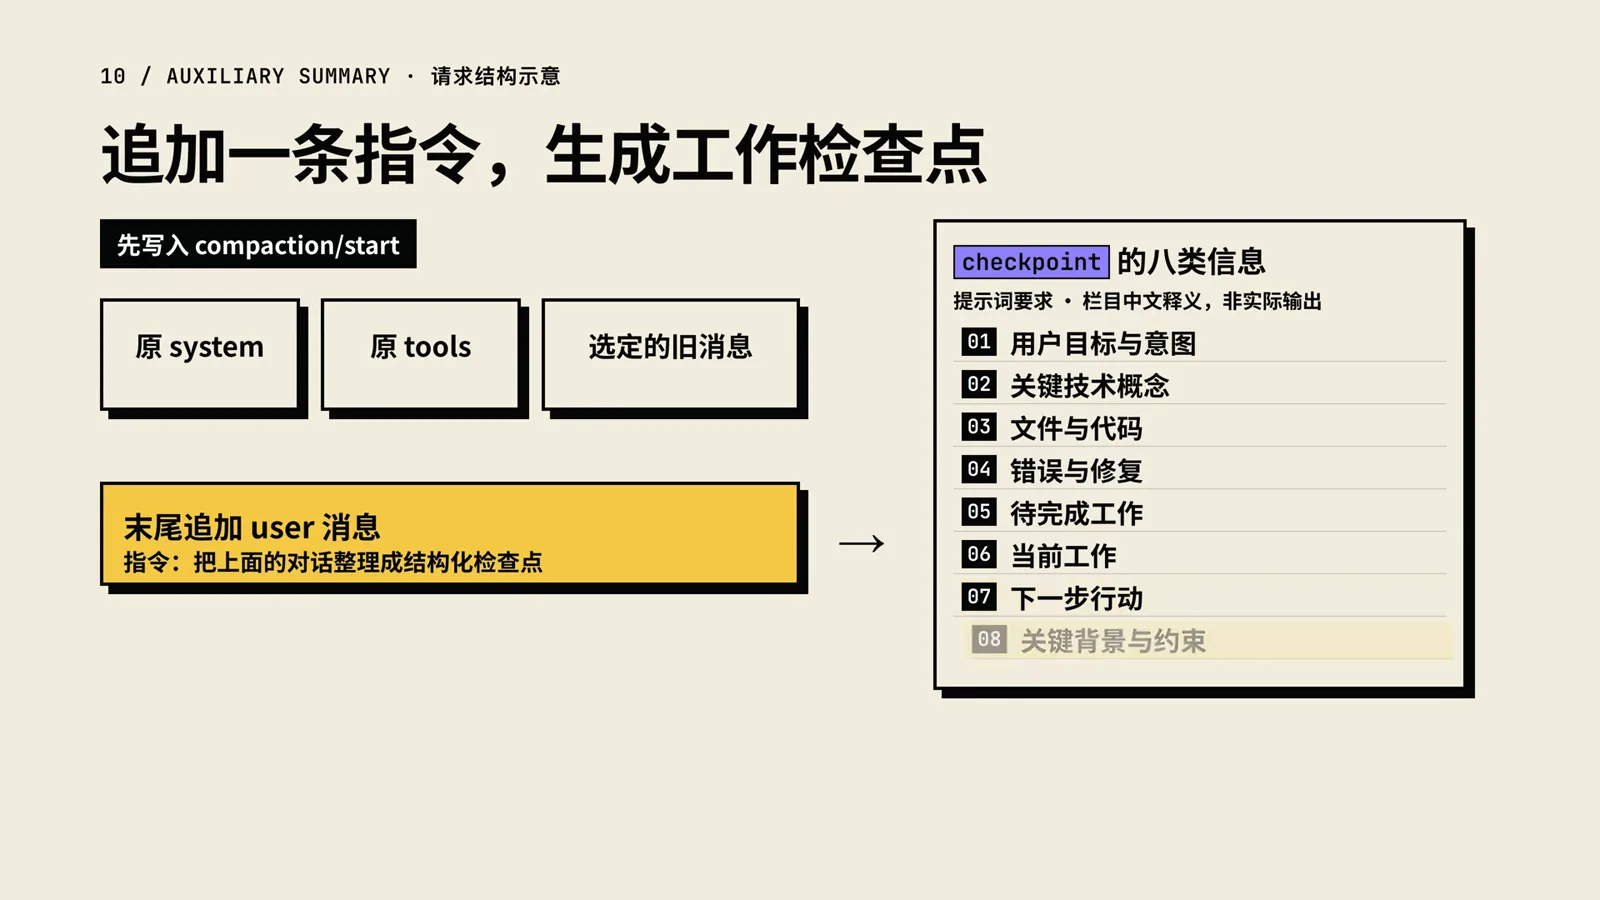
摘要指令要求产出结构化检查点——八类是作者的示意画法。去视频 7:05 处看 - 9
摘要合格,才准替换
摘要要过三道关才能顶替历史:模型完整结束并给出非空文本(报错、中断、达到输出上限截断都算失败);只保留 text 内容——reasoning 和 tool calls 不写入检查点,图片输出直接拒绝;含包装的摘要估值必须小于被替换旧区间的估值。
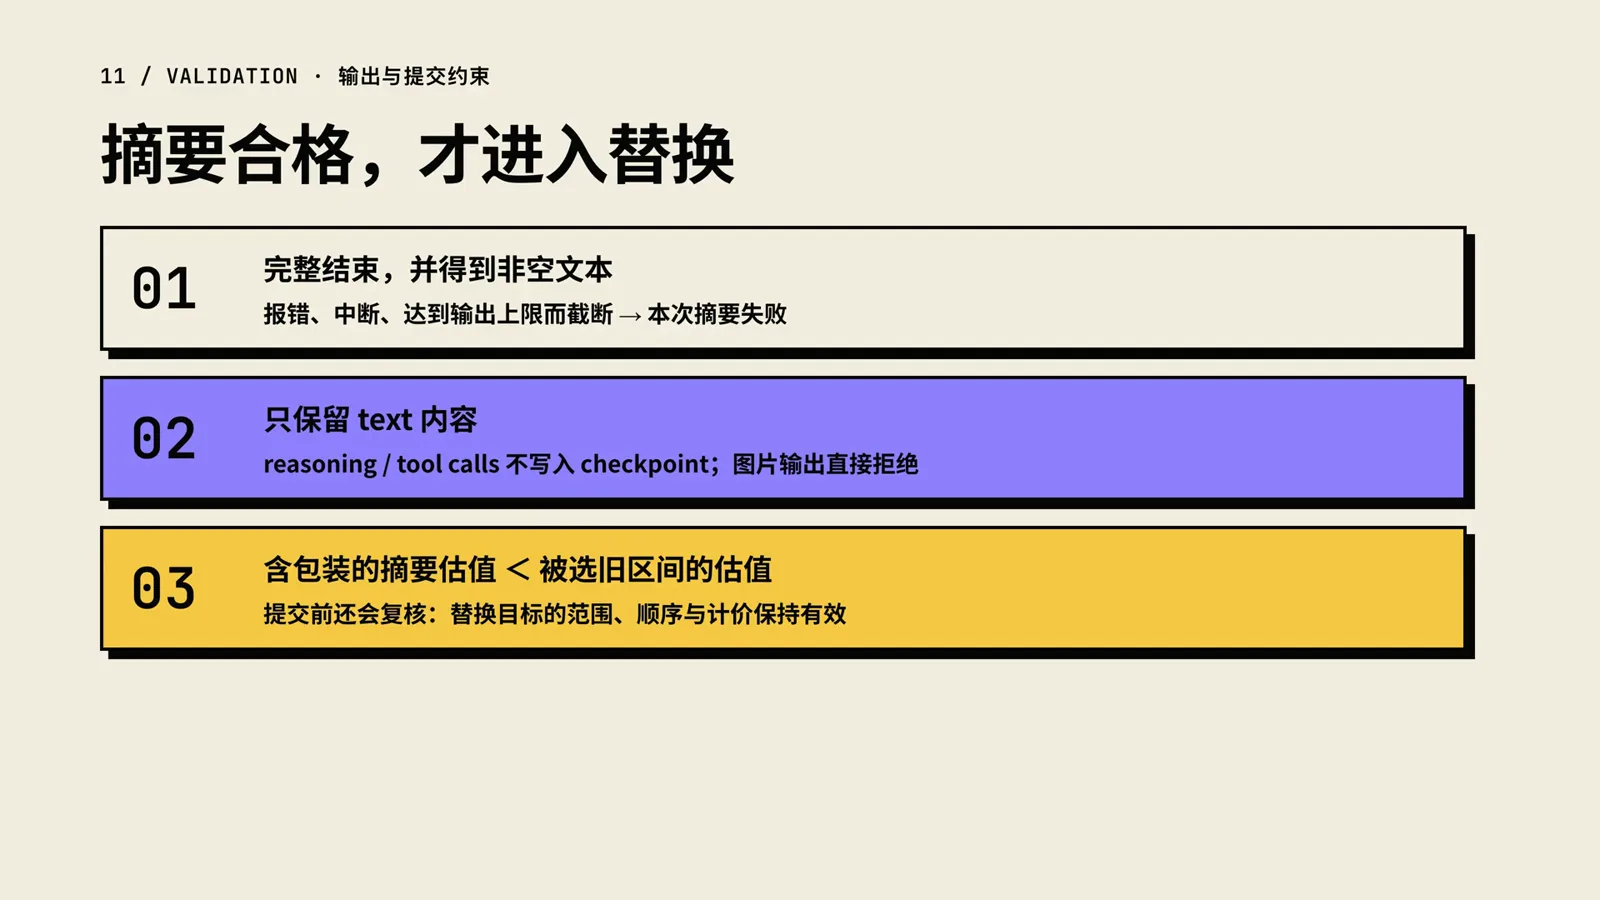
任何一关不过,摘要都到不了模型面前。去视频 7:56 处看
替换、重放与边界
- 10
日志只追加,模型视图被替换
成功之后,持久日志追加 start、summary、checkpoint、end 一串事件,而模型可见历史通过一次表层替换换新——画面里画的是 surfaceOp 的替换操作:检查点在前,保留下来的近期原文在后。上游什么都没删,日志仍是完整记录。
$surfaceOp: { op: 'replace' }$compaction/start · summary · end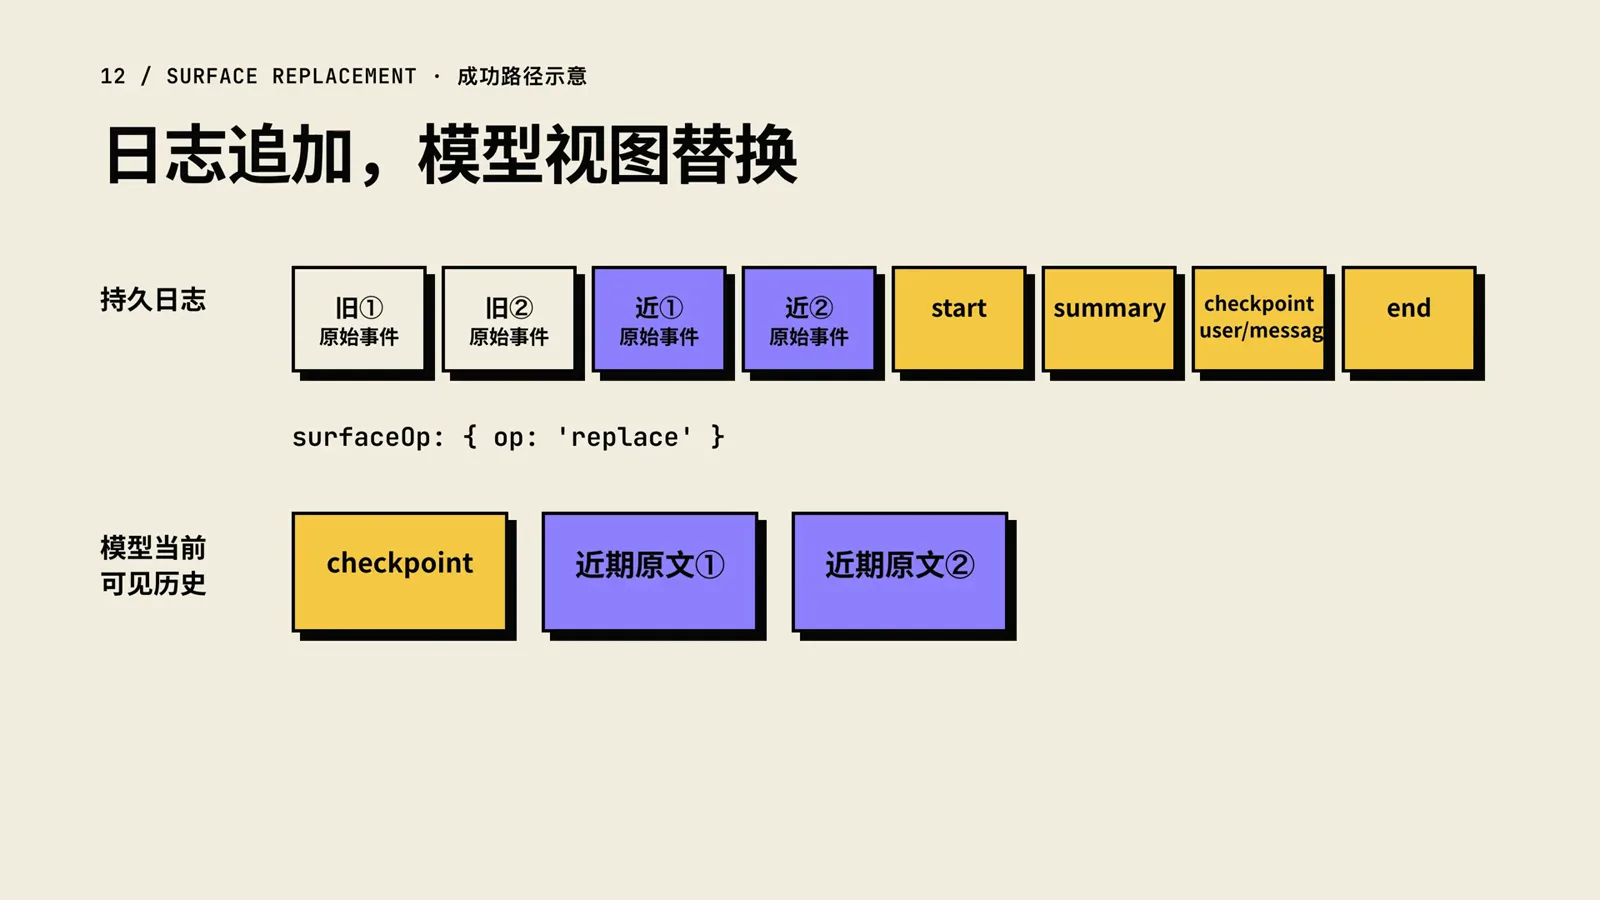
日志只增不减,被换掉的只是模型视图。去视频 8:48 处看 - 11
恢复靠重放日志
因为日志只追加且完整,恢复从不需要原始上下文:按事件顺序读回,逐条应用 surfaceOp 的 append 或 replace,模型视图就重建出来了——旧内容、检查点、近期原文各归其位。被压缩过的会话能挺过重启,靠的就是这个。
$surfaceOp: append / replace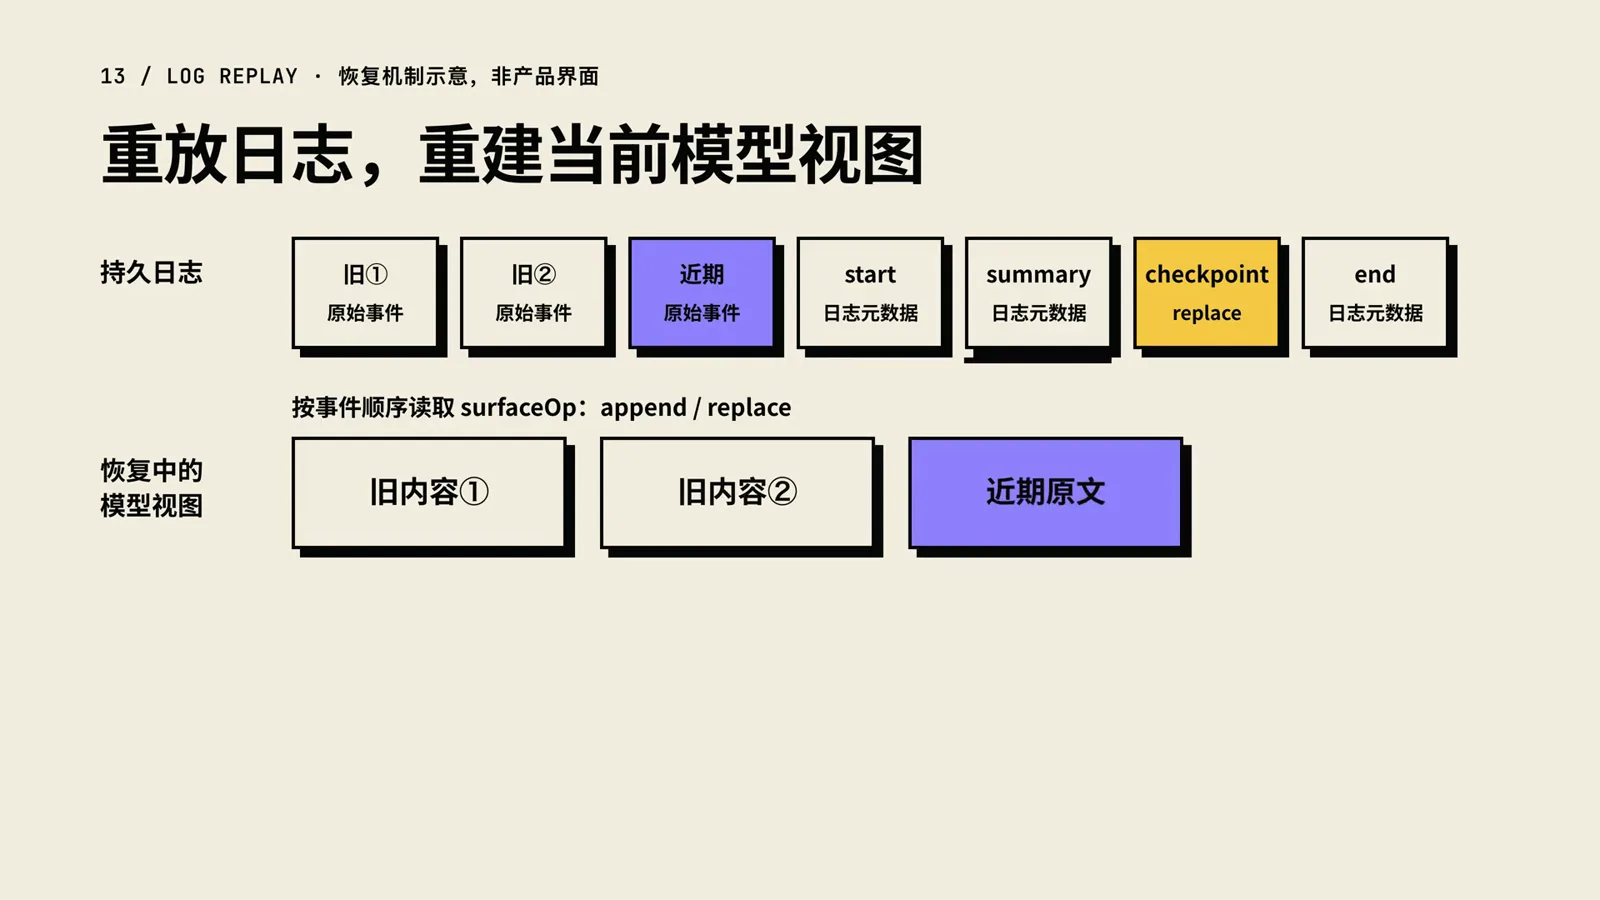
恢复就是对只追加日志的确定性重放。去视频 9:05 处看 - 12
收束:接口稳定,实现可换
结尾页把整条流水线收成四个动作——测量压力、裁剪工具结果、按需摘要、替换模型视图——并划清分工:ctx.compaction 保持稳定,compaction-basic 是当前默认实现,agent loop、token meter 和 /compact 入口环绕在外。每一块都能独立演化而不牵连其他。
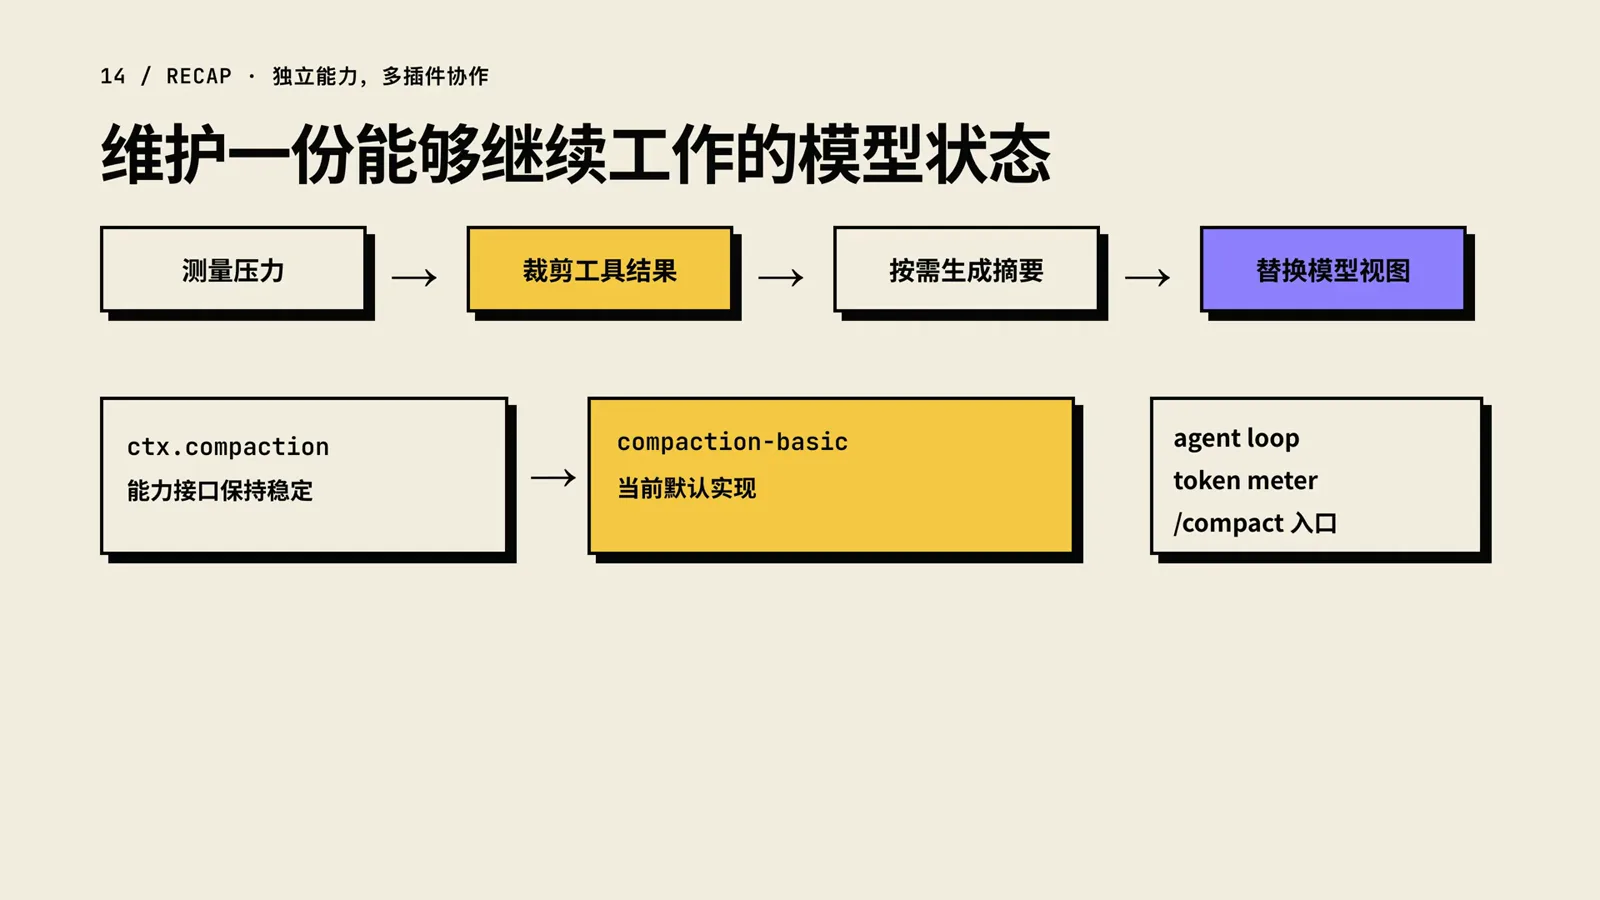
四个动作、一个稳定接口、一个可替换实现。去视频 10:00 处看
看仪表:实际界面里的 Token usage
前面讲的都是机制,这里是它落地后的样子。下面两张截图取自 AISeeKing 的周更实测(录制时为 0.1.5-rc.1 开发者预览版,界面文案可能与当前版本略有出入):一次累计 300 万 token 的运行结束后,Token usage 弹窗列得清清楚楚——缓存命中 99%、未命中输入 33,671、命中输入 2,931,968、输出 50,350。窗口保持稳定、只追加不重写,重复前缀就会持续命中缓存——压缩机制在这块仪表上兑现回报。
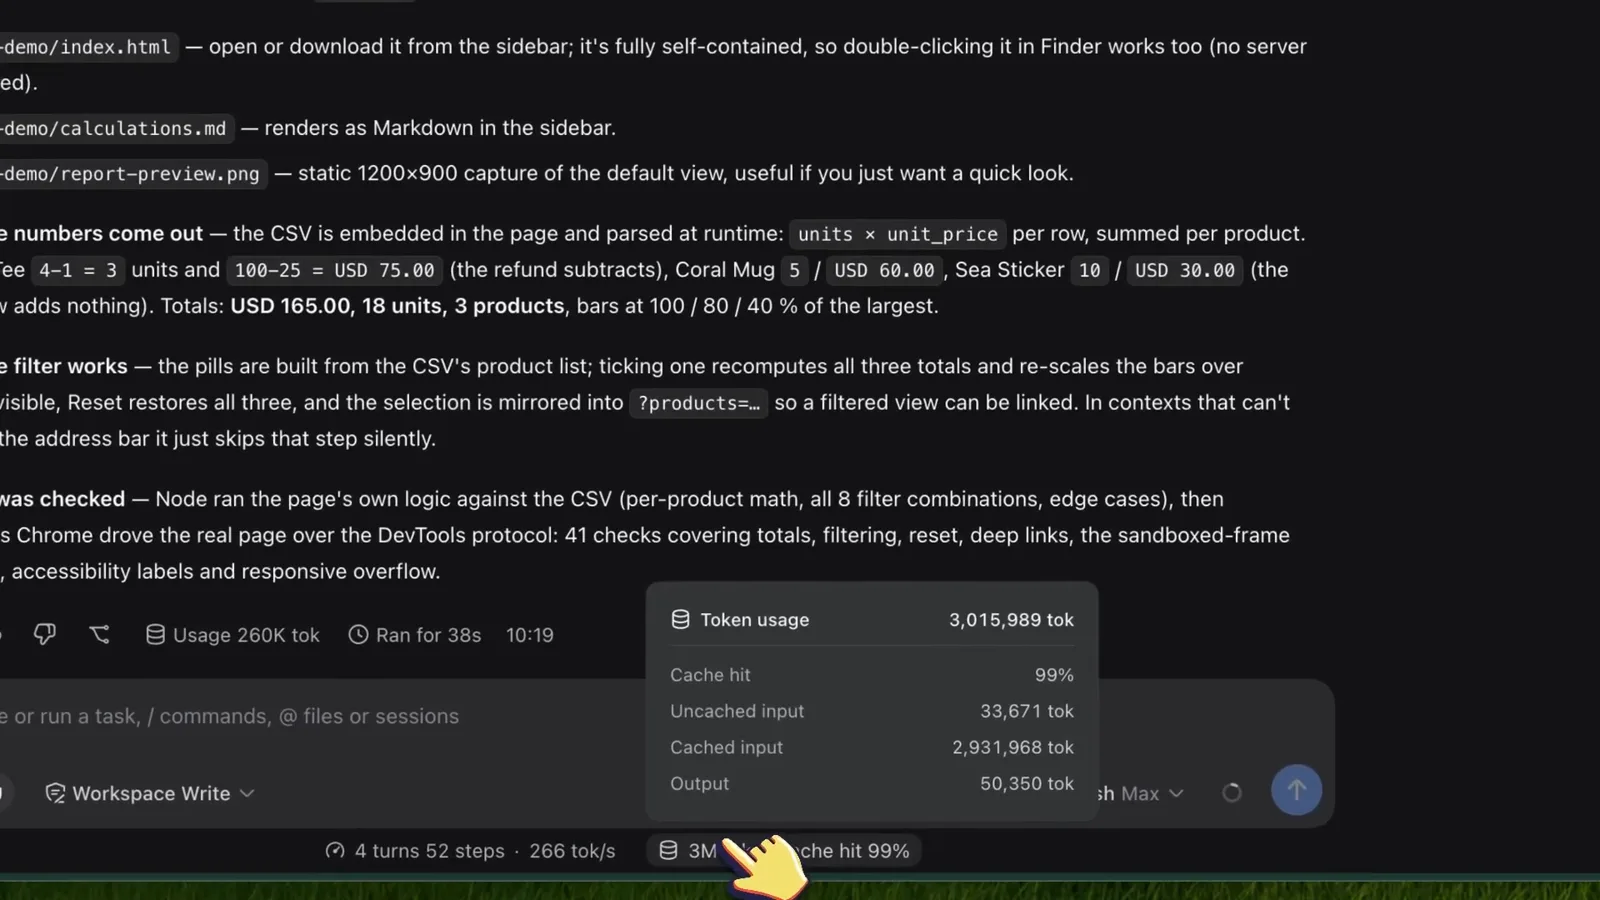
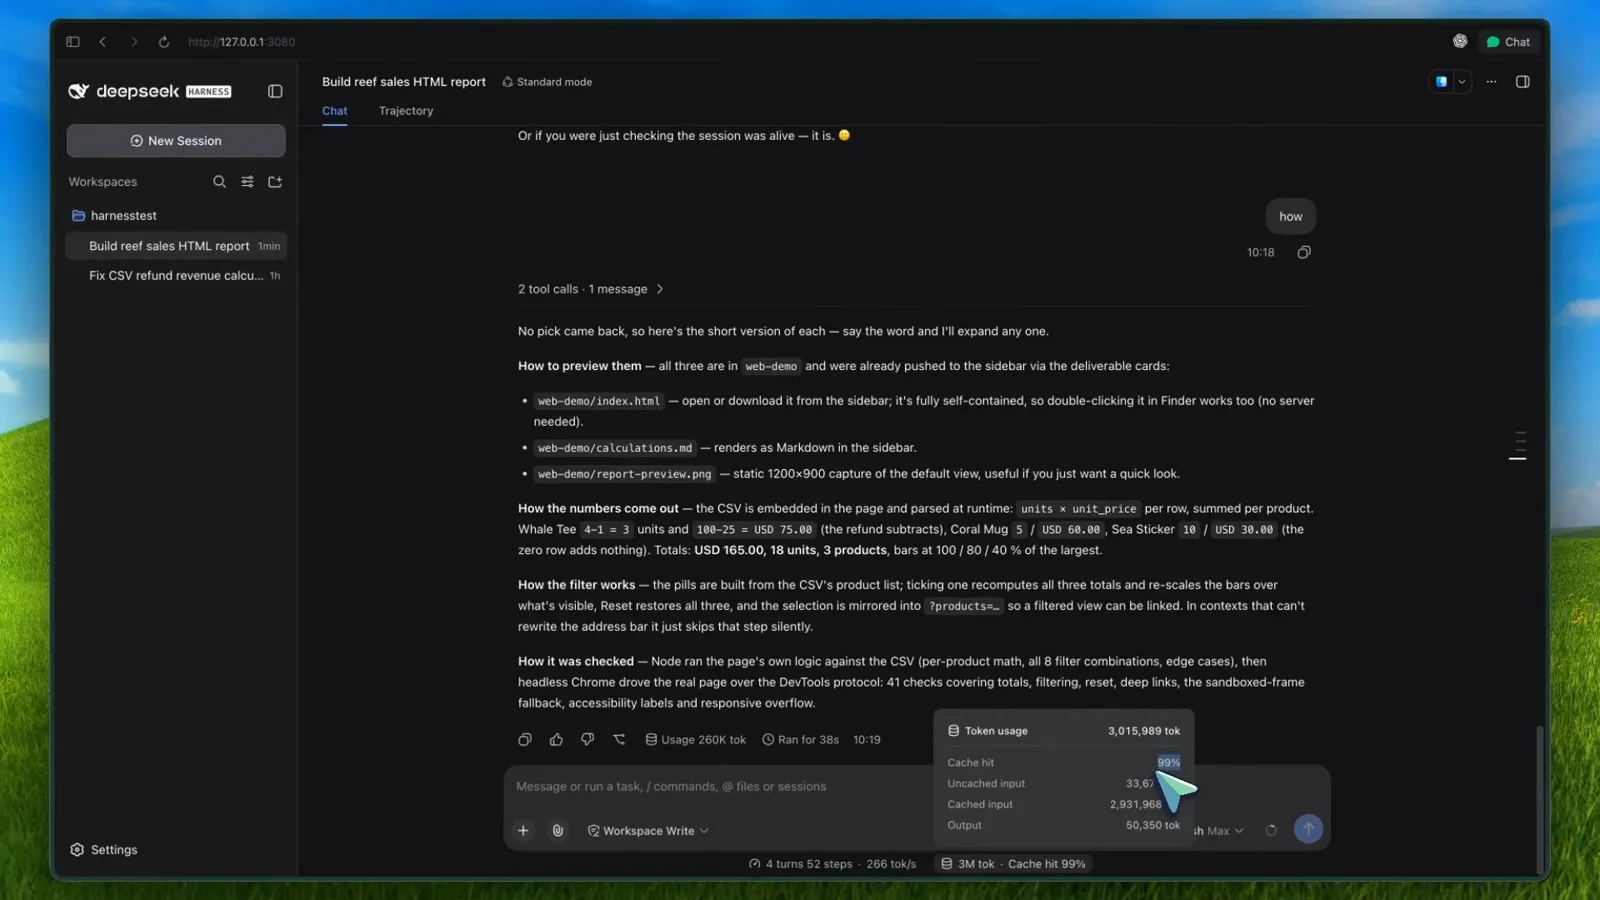
对应官方 0.1.7 的部分
这页拆的是插件流水线,而官方 0.1.7 版本线正从产品侧打磨同一处接缝——alpha 更新说明写明为主动压缩预留输出容量与上下文余量,长命令超时后可转入后台继续跑。想算清这些长任务的真实开销, 看这份 token 用量与成本追踪指南.
内置 compaction-basic 包与 headroomTokens
0.2.x 线把压缩做成了内置包——packages/compaction/compaction-basic——这个官方包名本身也成了搜索词。两个旋钮最关键。先是自动开关:按官方讨论 #8774 里给出的配置名,后台触发器是 compaction-basic.auto,把它关掉就停用自动摘要,/compact 仍可手动随时用。
第二个旋钮是 headroomTokens,即为摘要预留的空间。官方讨论 #8785 记录了它的毛边:默认值 65,536 不会随窗口缩小而缩放,在短上下文模型上,这笔预留本身就可能挤占它要保护的历史——小窗口请显式设置。如果你更想抬高天花板而不是调预留,tyan66666/billion-context-dsh(★124)是社区给出的答案。
上下文管理与压缩工具:内置与社区三支横评
前文拆的压缩流水线是内置机制。围绕它长出了一小圈上下文管理插件:把窗口构成看清楚的仪表盘、替代压缩引擎,还有硬天花板守卫。下方星数于 2026-10-08 经 GitHub API 实查——每一支都请对照它们所扩展或替代的内置 compaction-basic 来衡量。
基线:内置 compaction-basic
就是本页拆掉的默认实现:三触发(80% 预检、服务端溢出、手动 /compact)、8192 码点工具结果裁剪、16% 近期原文保留、检查点替换加重放。它随 dsh 自带、无需安装——把它当参照系,下方每支社区工具都是对它做的调整;先确认它工作正常,再往上叠东西。
bowenliang123/dsh-context(★1,892)——先看见上下文
断层领先的簇头牌:Context 面板、浏览器与侧边栏加一条 context 命令,把窗口的真实构成拆开看——统计、组成,以及压缩与剪枝事件的演进。它自己不做压缩,是观测层,告诉你内置压缩干得怎么样。这一节只装一支的话,装它。
yoza10635/dsh-argp(★9)——可审计的压缩
另一台引擎、另一份契约:LLM 只提议,确定性守卫裁决。逐原子收缩带逐字守卫、零模型调用的惰性引用图剪枝、追加式日志逐字节召回——承诺的压缩率精确兑现,历史永不销毁。当你对摘要的怀疑多过信任时,选它。
AllShadowAnan/dsh-context-compressor(★0)——绝对天花板
三支里最年轻的一支:在专属设置页设一个上下文绝对上限,会话一碰到这条线就自动压缩——一个不依赖 80% 默认阈值的硬停。为「真实窗口比标称小」的模型而生,这正是下面 FAQ 拆解的那类故障。
记忆与上下文一侧的更多精选——知识图谱、跨会话召回、上下文工程——见 记忆与上下文合集.
dsh 压缩的两种触发:自动压缩与手动 /compact(0.2.1-alpha.3)
0.2.1-alpha.3(alpha 通道,2026-10-14 发布)把压缩升级成一等命令:Web 与桌面端可用 /compact 手动压缩当前对话,极简模式还会自动压缩长对话(并支持读取图片)。底下跑的还是本页拆过的那条管线——同样的裁剪、同样的检查点、同样的替换重放——只是触发权从压力计交到了你手里。
版本核对:alpha.3 挂在 npm 的 alpha 标签下,stable latest 仍是 0.2.0-rc.2——如果你的 Web/桌面端还没有 /compact 这条命令,原因就在这。本页其余内容(阈值、裁剪、重放)讲的是 stable 已内置的 compaction-basic 包,它在 agent 空闲时的手动触发见第 3 步。
什么时候值得手动压一次:往已经很重的会话里喂长文档之前;一波工具密集、逐字记录已经没用的操作之后;或者用量表早就显示压力不小、而约 80% 的自动触发还遥遥无期的时候。
讨论区实测账本:压缩的真实成本与故障形态
官方讨论区把压缩从一份设计变成了一本账。下面每条就是一个实测发现加帖子编号——原始报告都在 deepseek-ai/deepseek-harness 仓库的 Discussions 标签页里。
#9629 —— 一次压缩白烧约 25 万未缓存 token
压缩摘要请求构造时没带会话的 reasoningEffort,缓存键与前后主请求不同——偏偏是重读整个窗口的这一发打不进缓存。报告者环境(opencode-go 路由、kernel 0.1.7-rc.2)下,等于每次压缩多付约 25 万本可避免的未缓存 token。
#9643 —— 每轮动态注入打穿 KV 前缀缓存
每轮注入的内容(记忆、上下文类插件)排在对话历史之前,提示词前缀永远对不上上一轮请求。本地 LM Studio 引擎实测 KV 前缀复用率恒为 0,每轮对 9 万–14 万 token 全额重算 prefill;报告建议把注入挪到提示词尾部。跑本地模型、疑惑 GPU 时间为何爆炸的,先看这帖。
#9404 —— 窗口才 40% 就开始自动压缩死循环
0.2.1-alpha.2 加本地 llama.cpp 模型(96k 窗口):约 3.79 万 token(约 40%)时自动压缩启动,随后连续重触发,压缩记录刷屏,对话无法推进。
#9544 —— 超过模型窗口的会话就此报废
长跑会话一旦超出模型窗口,之后每一轮都返回 400:重启全量重放表面、压缩陷入死锁、定时任务静默失效——产品内没有任何复活手段。
#9635 —— 上下文溢出且没有手动恢复路径
alpha.2 上的三连故障:token 低估、摘要器自己的重放又撑爆窗口、且没有手动恢复手段——会话永久不可用。加上 #9404 与 #9544,压缩行为异常时先对照这个死循环三连。
常见问题
触发、丢失与上限——画面本身说不清的部分。
压缩是怎么触发的?会不会打断我正在跑的任务?
三个入口:请求前预检(默认 80% 阈值)、服务端超窗恢复、以及空闲时手动 /compact。触发点都在请求之间,不会拦腰打断正在生成的回合;/compact 在 agent 忙碌时会提示暂不可用,你排队发出的消息等它跑完再继续。
压缩之后上下文会不会丢?
旧回合的原文会离开模型视野,但不是凭空消失:它们被整理成覆盖目标、文件、错误、待办的结构化检查点;最近约 16% 窗口原文保留;持久日志里每个原始事件都还在。丢的是模型对旧原文的直接引用,不是记录本身。
8192 码点裁剪,会不会把重要的工具输出砍断?
有可能,这是设计取舍:裁剪器只认位置不认语义,保留开头和结尾,中段一律替换成标记。好处是确定性——绝不把 emoji 之类的代理对切坏;代价是语义上重要的中段内容,要靠你自己在必要时重跑命令取回。
这些数字是写死的吗?
不是。80% 是 thresholdRatio 默认值,16% 是 retainRatio 默认值,都能按提供商和模型分别配置;裁剪器的 8192/4096/1024 码点预算同样可配。本文数值以 2026-09-23 官方仓库文档为准——把它们当当前默认值,不是常量。
长任务还是被截断了,压缩救不了怎么办?
压缩救的是会话太长,救不了单件超大产物:系统提示、工具定义、会话前缀压不动,一条巨大的工具调用也不会被拆开。这种情况把任务拆小,或转给子代理、后台任务去跑,让主会话只收结论。
怎么关闭自动上下文压缩?
把 compaction-basic.auto 设为 false——这是官方讨论 #8774 里给出的配置名,该帖同时提议在 Web GUI 加一键开关。关闭后后台自动摘要停用,/compact 仍可手动触发。顺手检查 headroomTokens:默认 65,536 不随窗口缩小(#8785),在短上下文模型上这笔预留本身就能制造压力。注意代价:没有自动压缩,长会话会更贴近溢出阈值——一旦越过,结束对话的是服务商,不是 dsh。
压缩怎么一发再发——死循环了?
症状:一轮压缩刚结束,下一个请求又压一遍,循环从不停下。机制级报告见官方讨论 #9041:当某条路由声明了异常大的 maxTokens,自动触发的阈值算术会坍缩,每一轮都被判为超压,自动压缩永久重跑。修复落地前的绕行:调低该路由声明的 maxTokens,或把任务挪到数值正常的路由;用 compaction-basic.auto: false 关掉后台触发,需要时手动 /compact;保留追加式日志——无论循环与否,重放恢复照常工作。
压缩压根不触发——然后服务商把会话拒了,为什么?
这是官方讨论 #9022 记录的静默失效:某模型声明的 contextWindow 没有进入 dsh 的模型信息解析器。压力估计永远过不了阈值,自动压缩从不启动,第一个可见征兆是网关的上下文溢出拒绝套着一层笼统的报错。先确认模型的上下文窗口确实注册上了(换模型指南讲了解析链路),应急时手动 /compact,长会话突然 400 时先按溢出读、再按额度读。
上下文满了该怎么办?需要迁移对话吗?
官方讨论 #9071 的原问。短答:不需要迁移。dsh 每个请求前检查压力,逼近上限就会压缩——旧轮次变成结构化检查点,近期尾部逐字保留,追加式日志什么都在,会话原地续命。如果会话已经被上面的死循环或静默失效卡死:趁 Agent 空闲敲 /compact,或者新起会话让检查点把结论带过去;真要把原始会话文件挪走,导出工具随时可用。
Web UI 里的「Cache hit」百分比是什么?
这个胶囊报告你的输入有多少命中了服务商的提示缓存、不用按全价重算——上文 Token usage 截图就是 99% 的例子,输入、缓存读/写、输出分桶列示。缓存读按新鲜输入的一小部分计费,命中率高就是你察觉不到的最便宜提速。各 provider 语义不同:本地 Ollama 端点可能给不出有用数字,DeepSeek 网关则单独列缓存——官方讨论 #9091 正是为这颗胶囊要文档的帖子。压缩与它互相影响:稳定前缀持续命中,重写历史就会清零重算。
什么时候该手动 /compact,而不是等 dsh 自动压缩上下文?
三个时机:往已经很长的会话里塞已知的大块内容(长需求文档、大文件转储)之前;一波工具密集、逐字输出已经没用的忙碌之后;用量表压力早就很高、而约 80% 的自动触发迟迟不来时。手动压缩走的是同一条浓缩管线,不会多丢东西。注意:Web/桌面端的 /compact 命令本身是 0.2.1-alpha.3(alpha 通道)的新功能;stable 上 compaction-basic 仍支持 agent 空闲时的手动触发,见上文第 3 步。
为什么压缩之后费用反而升了?
压缩省的是窗口空间,不一定是钱。两条实测机制在反向发力:#9629——摘要请求的缓存键不同(没带 reasoningEffort),每次压缩把整个窗口按约 25 万未缓存 token 重读一遍;#9643——每轮动态注入排在历史之前,本地引擎的 KV 前缀缓存完全失效,每轮都要全额重算 prefill。账单总在压缩事件附近跳的,先对照这两帖。
相关攻略
DSH 学习路线里的相邻课题。
DeepSeek Harness Token 用量与成本追踪
压缩省了多少,量出来才算数:会话内、日志里、提供商账单页三处对账。
阅读指南DeepSeek Harness 四种模式对比
standard、code(PTC)、cordis 三个 Web 预设共用同一套压缩组合,其余差异看这篇。
阅读指南DeepSeek Harness 故障排查手册
超窗报错、压缩重试这些长会话高发故障,一次给到位的修法。
阅读指南DeepSeek Harness 子代理实战指南
一个上下文不够用时:把长任务拆给子代理和后台任务,别硬撑单线程。
阅读指南dsh TUI 终端上手
ask_user_question 与后台任务同屏的终端,长任务挂后台的理想搭档
阅读指南dsh 系统提示词是怎么拼出来的
上下文的另一半:每一轮系统提示词的组装顺序,以及改写它的插件
阅读指南可视化你的 dsh 上下文窗口
dsh-context 插件实录:构成模态框、逐请求趋势图,以及给上下文每个组成部分标价的请求浏览器。
阅读指南来源与署名
全部 13 帧画面截自同一支视频——旁白讲解的机制示意动画,非官方产品界面、非实机录屏;每张图都可深链回原片对应秒数。同一支拆解在 YouTube 由 01Coder、在 Bilibili 由 五里墩茶社 发布(同一作者:小木头)。