用 DeepSeek Harness 做科研数据分析:10 万行数据清洗、统计、出图全流程
一段 22 分钟屏幕实录的逐帧图文:把 101,766 行糖尿病 EHR 真实数据集丢给 dsh,一个会话里完成清洗、质量审计、Cox 生存分析、期刊级图表和排版好的 Results 章节——API 账单 ¥3.10。
最近更新: 2026-10-01
真实的科研数据都不友好:编码列、混合类型、十万行起步。这篇攻略跟着一段 22 分钟的屏幕实录(来源见文末)走完全程:研究者把真实的公开数据集——10 万行 US Hospitals Diabetes EHR 住院表——交给 DeepSeek Harness,一个会话里拿到数据画像、清洗、质量报告、Cox 生存分析、期刊级图表和排版好的 Results 章节,花费约等于一瓶水。
下面每一步都是逐帧核对过的截图,并带回到原视频对应秒数的深链。如果你还没装 dsh,先看这里: DeepSeek Harness 是什么?dsh 插件是什么?
TL;DR
- ▸一个 prompt 跑通真实 101,766 行 EHR 表:剔除 examide、citoglipton 两个恒定列,特征 50 → 48,数值/分类列转换后内存压缩 91%——248.7 MB → 21.5 MB。
- ▸智能体会自查:它发现自己的审计脚本有两个 bug,连续 Edit 四次修复后重跑,交出数据质量报告——6 轮 98 步,零手写代码。
- ▸一段中文 Cox prompt(「变量你自行决定」)加上「Nature 级科研图表」的要求,拿到 lifelines/R survival 代码和 dpi=300 的 PNG+SVG 图表。
- ▸Results 章节直接排版进 Word——数字全部真实计算、三线表规范——整段实录的全部 API 开销是 353 次请求共 ¥3.10。
从一张 10 万行原始表到 Results 章节
第一部分 · 一次性配置
- 1
挂上自己的 DeepSeek API Key
整个流程跑在你自己的 Key 上。实录里作者先停在开放平台用量页——余额 ¥5.67、累计消费 ¥14.32、此前 254 次请求 3,255,296 tokens——然后新建 Key,粘进 dsh 的「添加一个 API Key」弹窗。这页别关:最后一步还要回来对账。
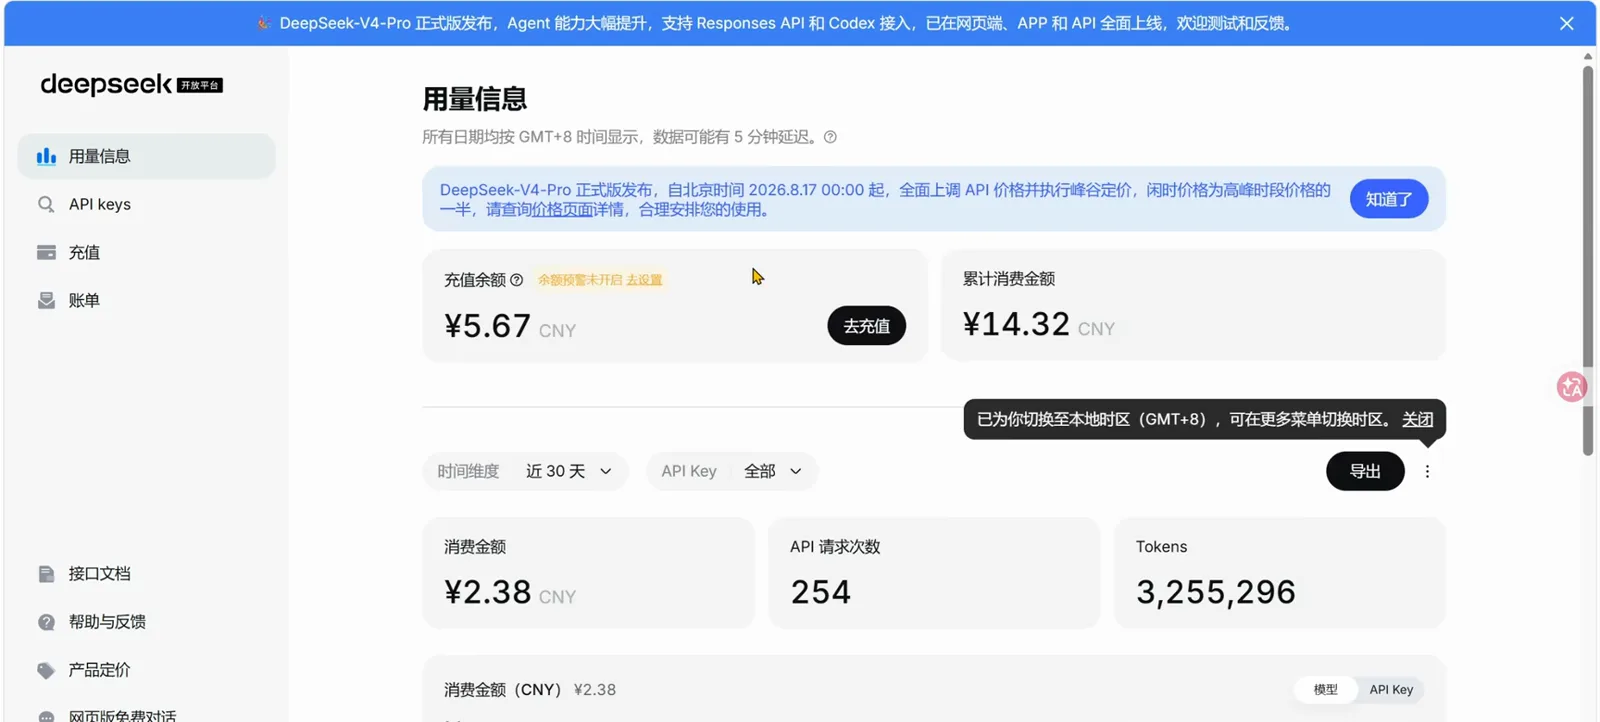
先到 DeepSeek 开放平台拿 Key,这页用量最后还能当对账单看 2:45 处 - 2
选模型:V4-Flash 还是 V4-Pro
在 07_医学与健康医疗(Medical & Health)工作区新建会话,模型选择器只有两个:默认的 DeepSeek-V4-Flash(High 档)和 DeepSeek-V4-Pro。这 22 分钟的清洗、统计、画图、写 Word 全程都跑在 V4-Flash 上,Pro 留给更重的活。
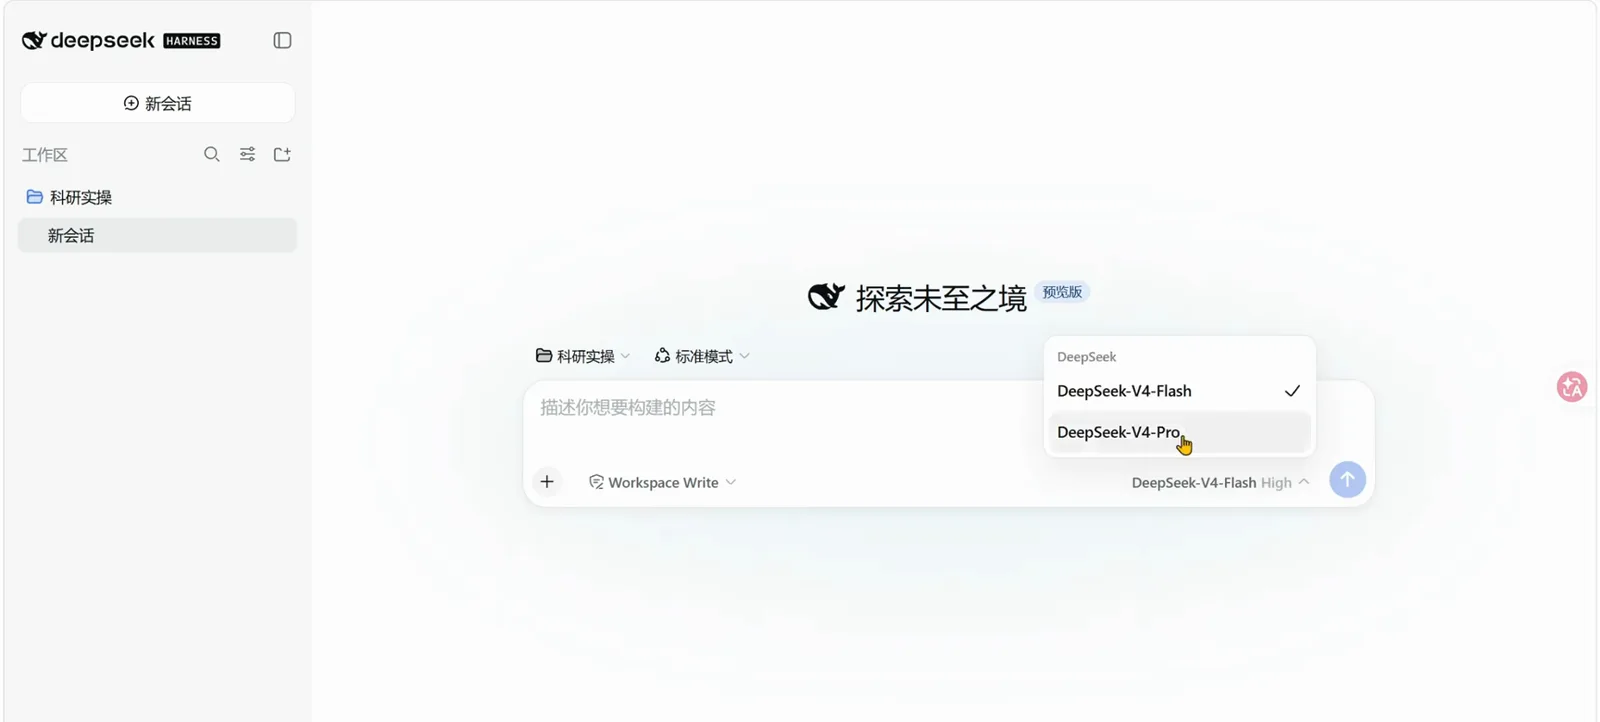
选择器里就两个模型:全程跑在 V4-Flash(High)上看 3:45 处 - 3
把 10 万行原始表直接丢进去
演示数据是真实公开数据集 US_Hospitals_Diabetes:10 万行 EHR 住院表,101,766 例住院记录。Excel 里它刻意「难看」——公式栏里是编码过的 race 值,用药列填满 No / Steady / Down / Up,一行里什么类型都有。原样丢给 dsh 就行,解码是它的事。
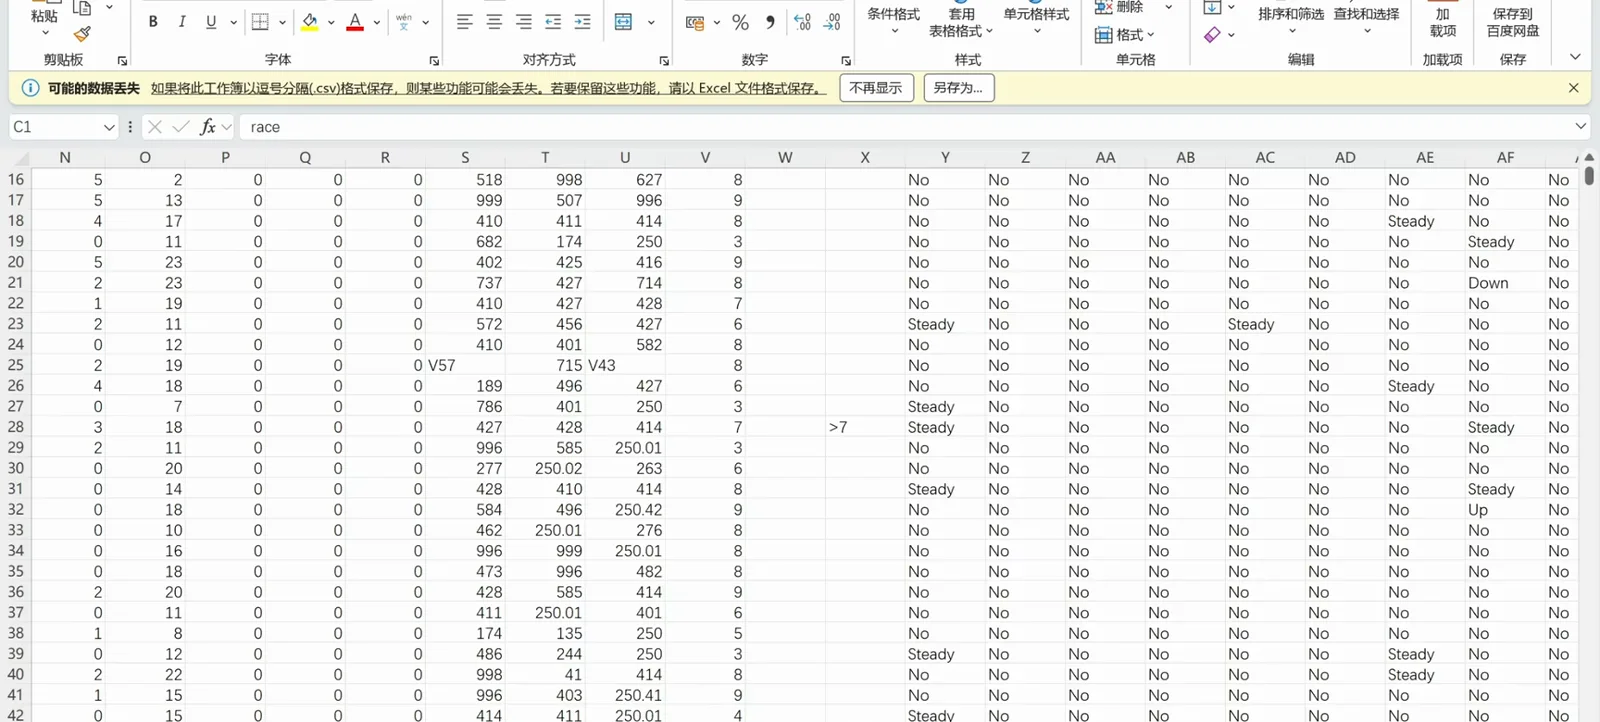
原始表长这样:编码值加混合类型,原样交出去即可看 5:00 处
第二部分 · 清洗、审计、加统计
- 4
一句话启动清洗,智能体自己给自己查错
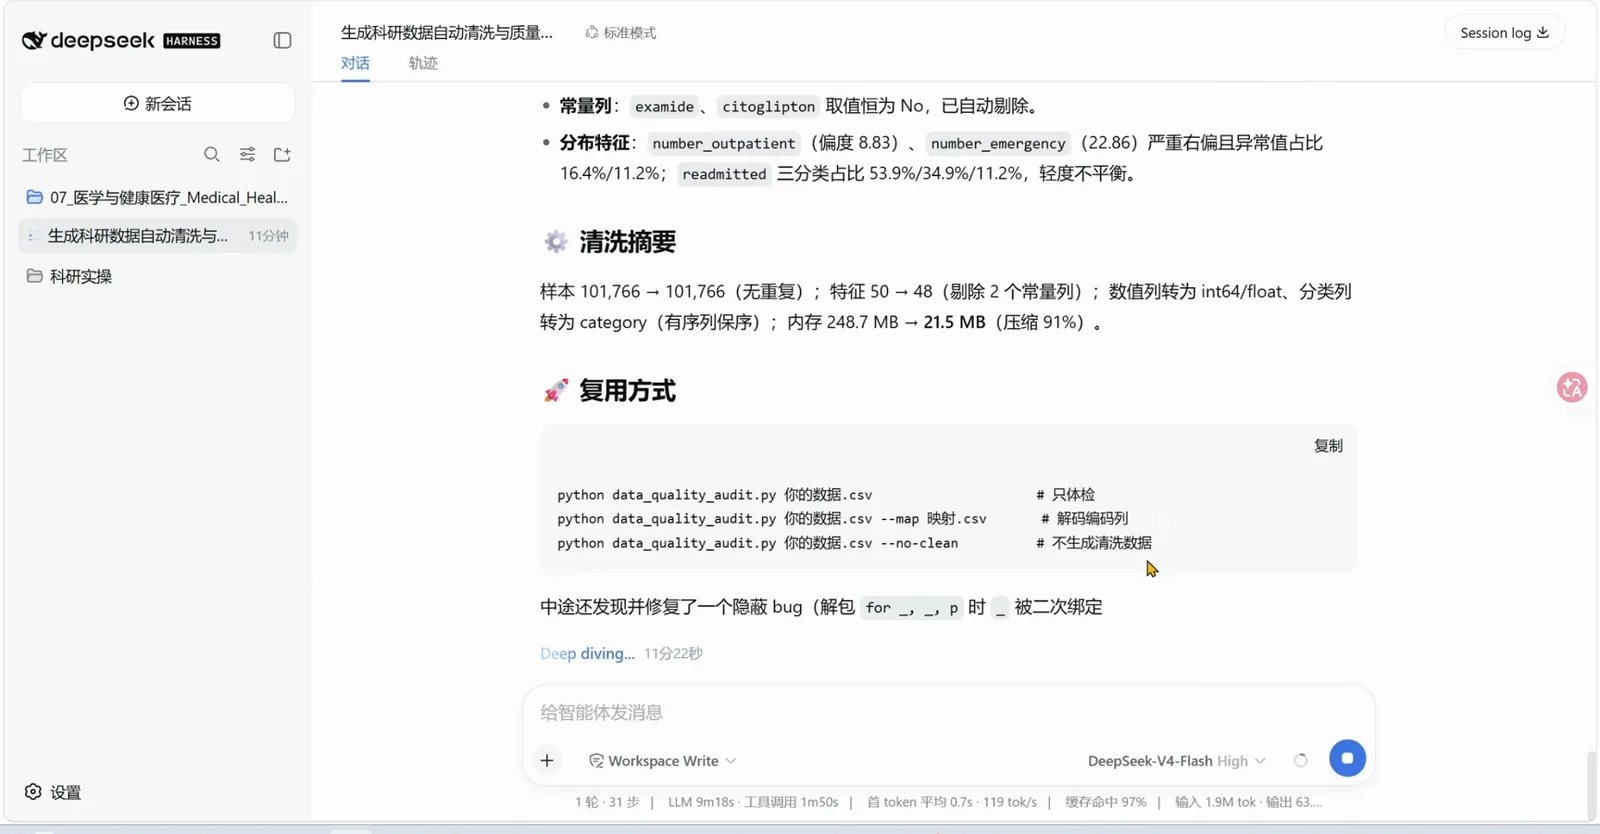
一句中文——做数据画像、清洗、质量审计——流水线就开跑。会话自己写 data_quality_audit.py,又发现自己代码里两个 bug:类型推断顺序让 age/weight 区间列误触 to_datetime 警告、缺失字典的元组取值写错;连续 Edit 四次、PowerShell 重跑、读回 01_Diabetes_EHR_data_quality_report.md——6 轮 98 步,LLM 24m7s,缓存命中 99%。留下的脚本可以复用:
$python data_quality_audit.py 你的数据.csv # 只体检$python data_quality_audit.py 你的数据.csv --map 映射.csv # 解码编码列$python data_quality_audit.py 你的数据.csv --no-clean # 不生成清洗数据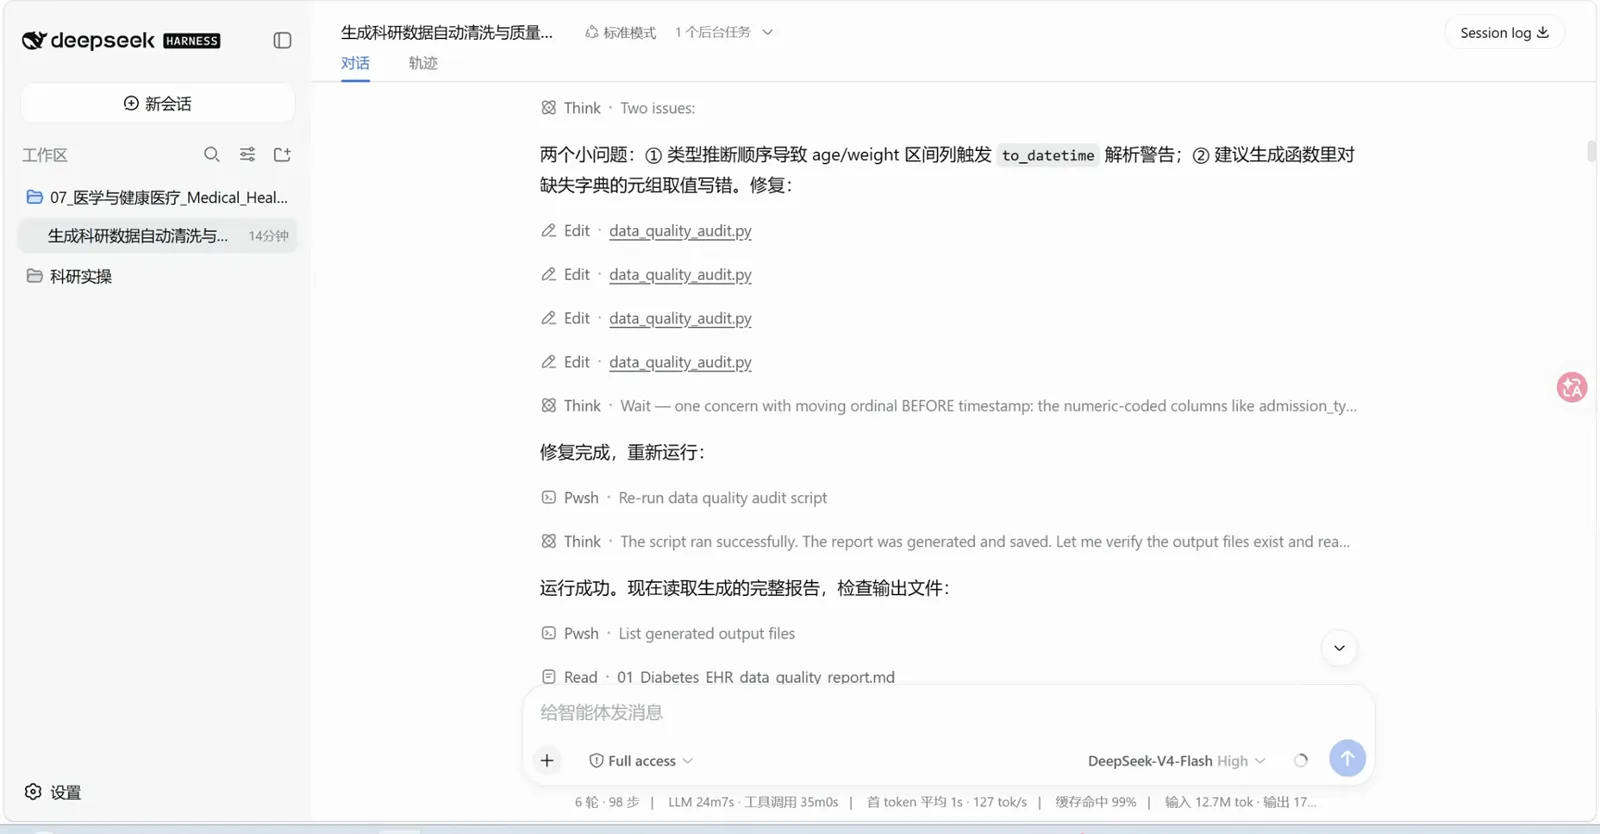
自己查自己:4 次编辑、一次重跑、读回质量报告,全程无人工看 1:00 处 - 5
用 persona prompt 追加统计检验
统计检验也是一句话的事。实录里输入的是生存分析统计家人设:「你是一名肿瘤与慢性病生存分析统计学家……用 Python lifelines / R survival 编写 Cox 比例风险回归代码」,随访时间、终点事件、分组、协变量全部留空(「需要的变量你自行决定」),末尾再加一句「你是一名 Nature 级科研图表可视化大师」。此时输入框上方,报告检查已确认 examide 被正确剔除、清洗后 CSV 结构验证通过。
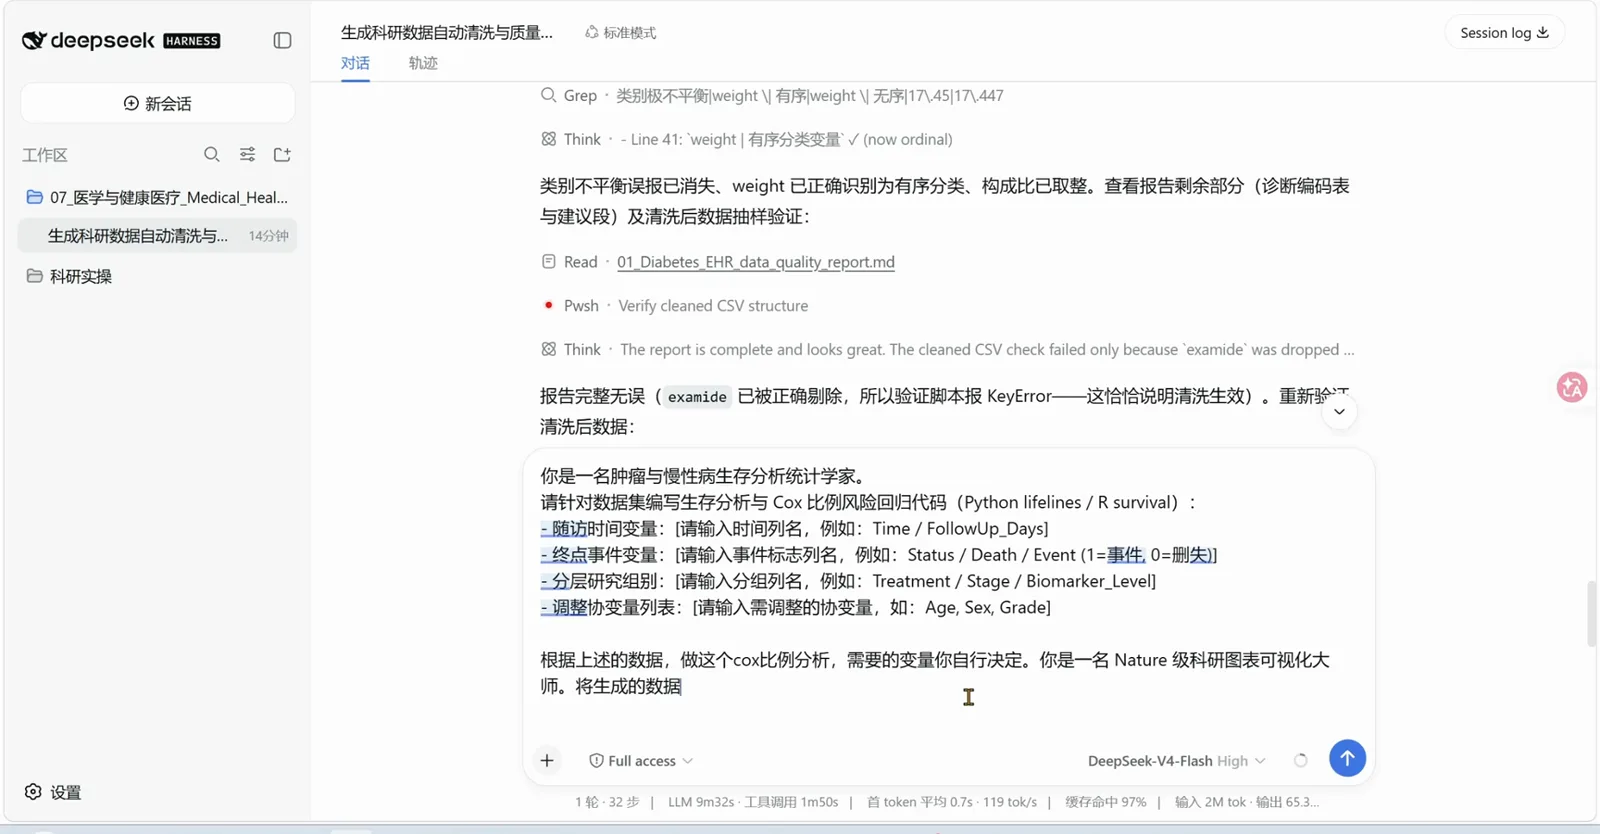
一段中文:Cox 回归变量让智能体自己定,图表一并要看 10:15 处
第三部分 · 图表、论文、账单
- 6
期刊图表按成文规范出图
图表好看不是运气。作者维护一份 16 页的 Prompt 手册(见文末来源),第 11 页规定 raincloud 图配方:半边小提琴 KDE + 箱线图 + 抖动散点(alpha=0.6)、显著性横线(p<0.05 / 0.01 / 0.001)、Nature/Lancet 配色 #4DBBD5 #E64B35 #00A087 #3C5488、去顶右边框(sns.despine),并硬性要求 dpi=300 的 PNG 外加一份 SVG 用于排版。
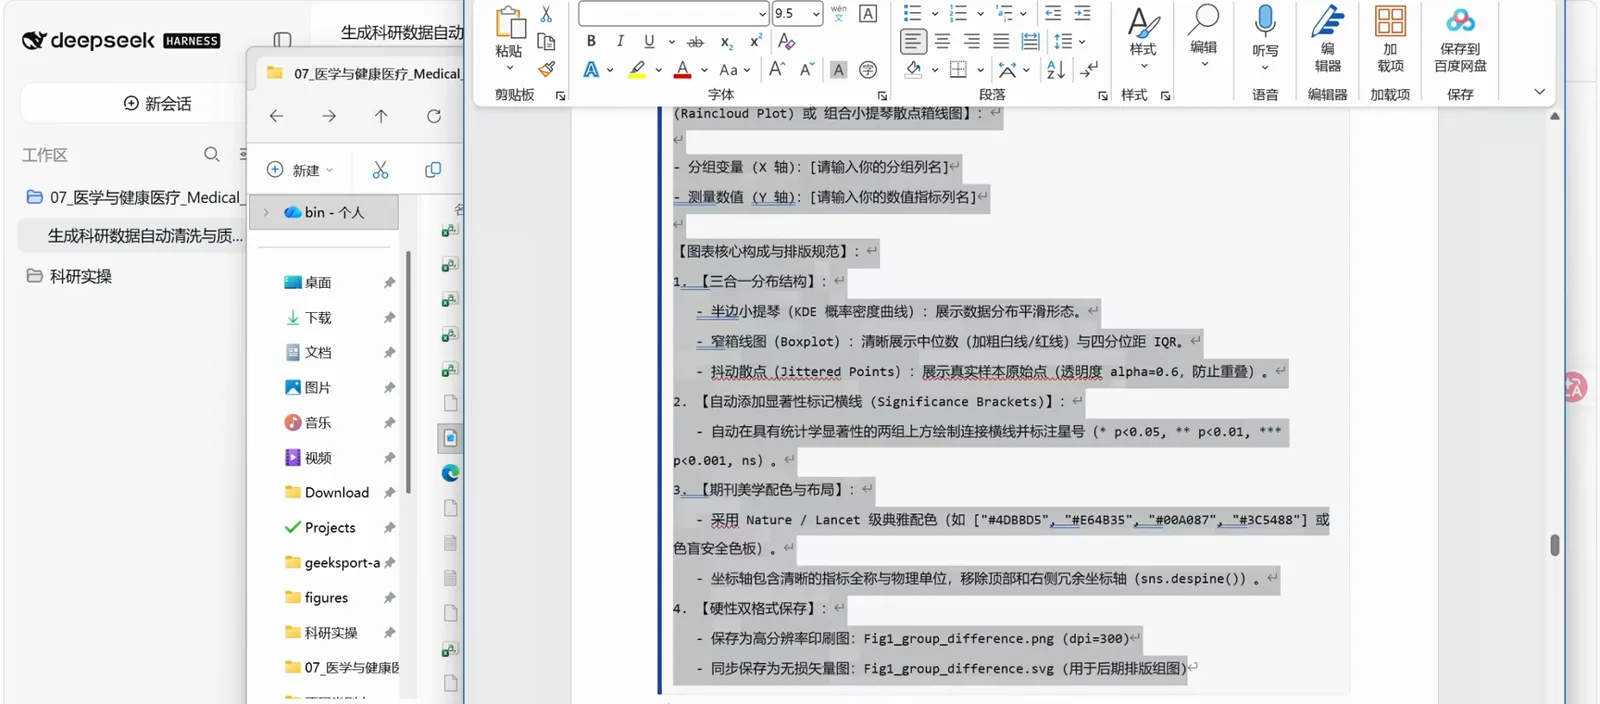
手册第 11 页:raincloud 配方、配色、显著性横线与 dpi=300 硬规矩看 15:00 处 - 7
Results 章节自动成稿,数字全部真实计算
generate_results_docx.py 产出 output_results.docx,统计量是算出来的不是编的——会话原话「统计量全部基于 1000 行数据真实计算」。演示版 Results 覆盖 1,000 例住院子集:用药 796 例 vs 未用药 204 例,年龄 59.86±17.54 vs 64.41±17.24(Welch t = 3.35,P < 0.001),急诊入院 21.0% vs 9.8%;Table 1 排成标准三线表(顶线/底线 1.5 磅、栏头线 0.75 磅、无竖线)。会话还做了 XML 级排版校验:122 个 Run 字体全部合规。
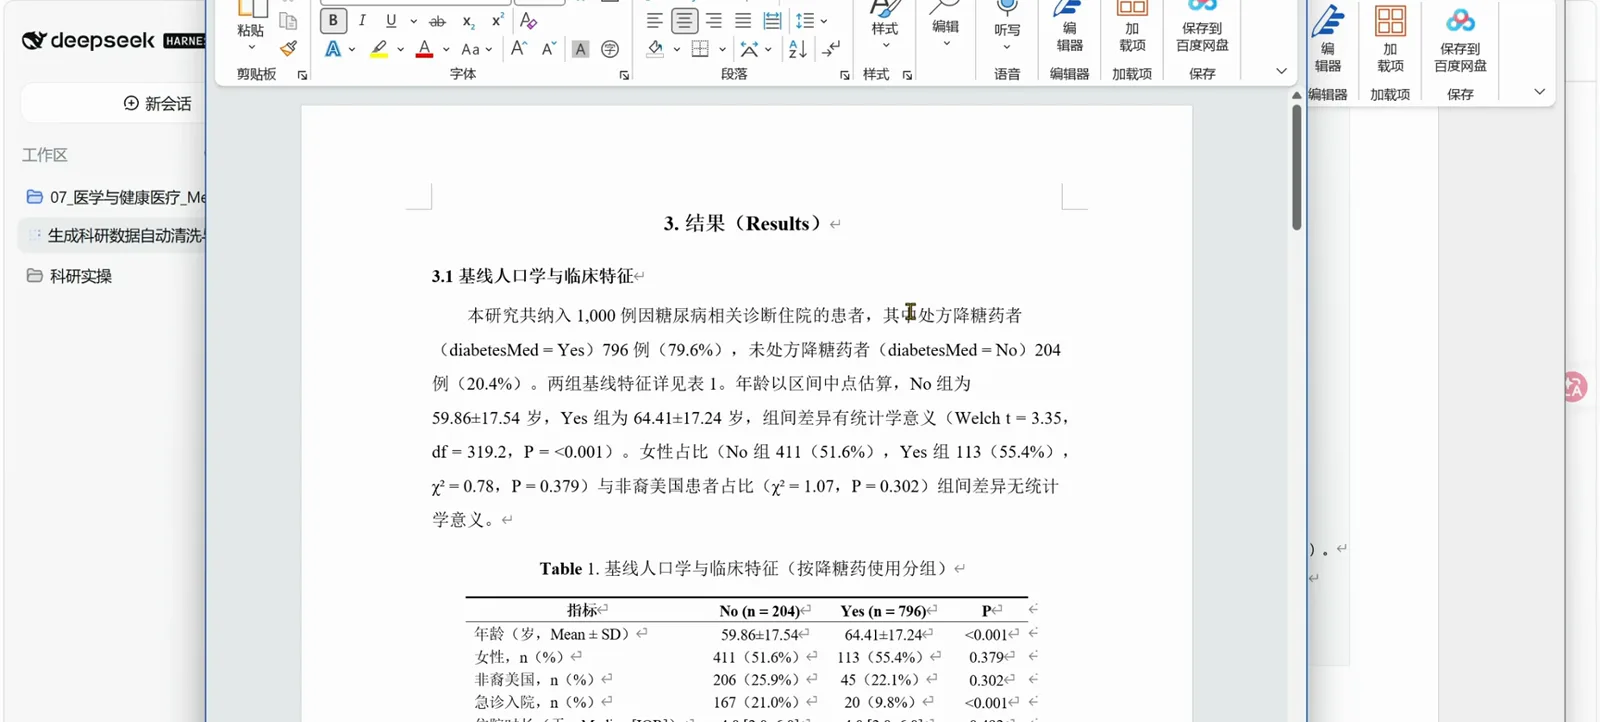
Word 版 Results 章节:数字是算出来的,Table 1 是标准三线表看 16:00 处 - 8
产出全部落盘,不只活在聊天记录里
跑完之后,工作区文件夹里多了 23 个条目:双格式图表(Fig1_group_difference.png 146 KB + .svg 204 KB)、四个脚本(raincloud_plot.py、survival_cox_analysis.py、data_quality_audit.py、verify_and_explore_medical_data.py)、survival_analysis_report.md、清洗后的 survival_dataset.csv 和 Word 报告。换数据重跑会覆盖同名文件,成果不锁在会话里。
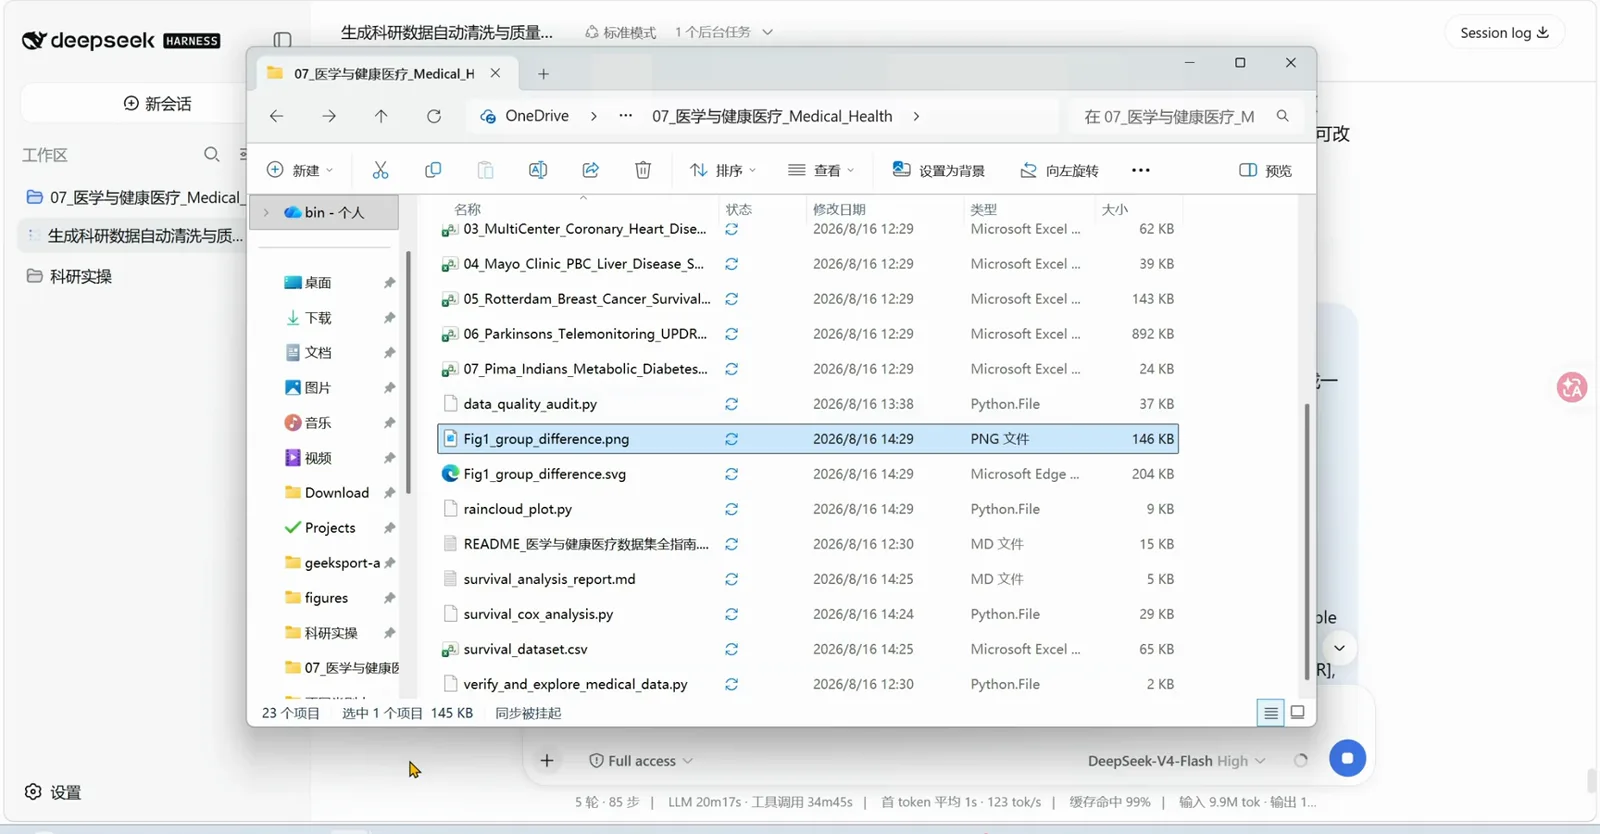
跑完之后:图、脚本、报告、清洗数据,全是普通文件看 15:30 处 - 9
发布之前,先看一眼账单
视频结尾停在 DeepSeek 用量页:清洗、统计、画图、写 Word 全部跑完,可见月份内共消费 ¥3.10、353 次请求、16,137,371 tokens,8 月 16 日当天的高峰是 ¥0.73(deepseek-v4-flash)。你跑完第一次,也来这一页对账。
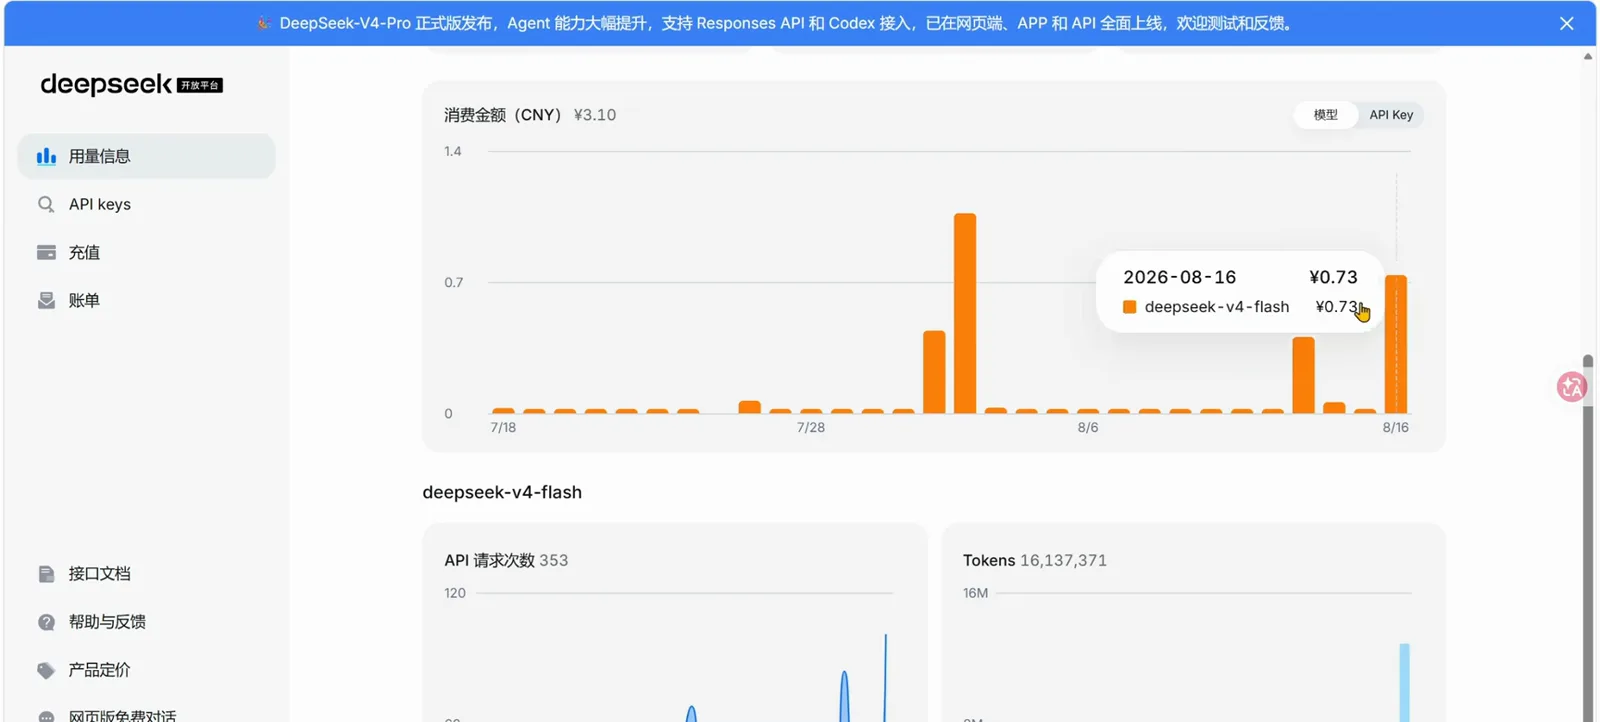
对账单:整段实录 ¥3.10、1613 万 tokens看 21:00 处
常见问题
科研人群把自己的数据交给 dsh 之前,最常问的几件事。
不会 Python、不懂统计,能照着跑吗?
能。实录里所有 prompt 都是普通中文;代码由智能体自己写、自己调、自己重跑——它甚至主动修了自己审计脚本里的两个 bug。但发表前你得自己判断统计对不对:视频作者最后也是亲自审核生成的代码和表格。
只能用这个糖尿病数据集吗?
不是。US_Hospitals_Diabetes 只是公开演示数据,实录工作区里还躺着冠心病、鹿特丹乳腺癌生存、帕金森远程监测、Pima 印第安糖尿病等其他公开集;留下的脚本也是参数化的——data_quality_audit.py 指向任意 CSV 即可,--map 解码编码列,--no-clean 只体检不清洗。
10 万行的表,我的机器扛得住吗?
实录给出的答案是反向的:数值列转 int64/float、分类列转有序 category 之后,表格内存从 248.7 MB 降到 21.5 MB——分析还没开始就瘦了 91%。画像先行,动数字之前你已经看到数据的形状。
生成的 Results 章节能直接投论文吗?
把它当「数字可核验的初稿」。会话从数据里真实计算统计量(演示子集为 1,000 例住院),还做了 docx 的 XML 级排版校验(字体、行距、三线表磅值),但作者本人仍逐段审核代码与表格后才采信。请在你自己的环境里复现数字,并请统计专业的人把关——本页是方法演示,不构成医学建议。
相关攻略
同一台引擎,隔壁的工作流。
一个 prompt 合并 Excel 报表
小一号的兄弟工作流:三张费用表 1,800 行,靠规则、字段映射与验收标准一个会话合并。
阅读指南一句话生成 PPT 演示文稿
Results 章节要变成汇报幻灯片时,用得上 office 插件家族。
阅读指南长篇写作工作台
章节规划与文风锁定,科研写作的另一半流水线。
阅读指南DeepSeek 模型按任务切换
第 2 步选择器背后的 V4-Flash 与 V4-Pro、推理档位——什么时候省着用,什么时候上强度。
阅读指南常见报错与排查百科
装不上、启动崩溃、更新出错——自己跑之前先对着真实修复案例过一遍。
阅读指南科研插件聚合
文献、引用、数据方向的科研插件,给这套分析流程加装备。
阅读指南来源与致谢
全部截图与屏上数字取自第一支视频,并经全分辨率逐一复核;研究插件清单由第二支视频互证;图表与三线表规范引自作者发布的 Prompt 手册。数据集为作者声明的公开数据;文中统计结果均为工作流演示,不构成医学建议。