用 DeepSeek Harness 做科研資料分析:10 萬行資料清洗、統計、繪圖全流程
一段 22 分鐘螢幕錄影的逐格圖文:把 101,766 筆糖尿病 EHR 真實資料集丟給 dsh,一個會話裡完成清洗、品質審查、Cox 迴歸、期刊級圖表和排版好的 Results 章節——API 帳單 ¥3.10。
最近更新: 2026-10-01
真實的科研資料都不友善:編碼欄位、混合型別、十萬行起跳。這篇攻略跟著一段 22 分鐘的螢幕錄影(來源見文末)走完全程:研究者把真實的公開資料集——10 萬行 US Hospitals Diabetes EHR 住院資料表——交給 DeepSeek Harness,一個會話裡拿到資料輪廓、清洗、品質報告、Cox 生存分析、期刊級圖表和排版好的 Results 章節,花費約等於一瓶水。
下面每一步都是逐格核對過的截圖,並帶回到原影片對應秒數的深鏈。如果你還沒裝 dsh,先看這裡: DeepSeek Harness 是什麼?dsh 外掛是什麼?
TL;DR
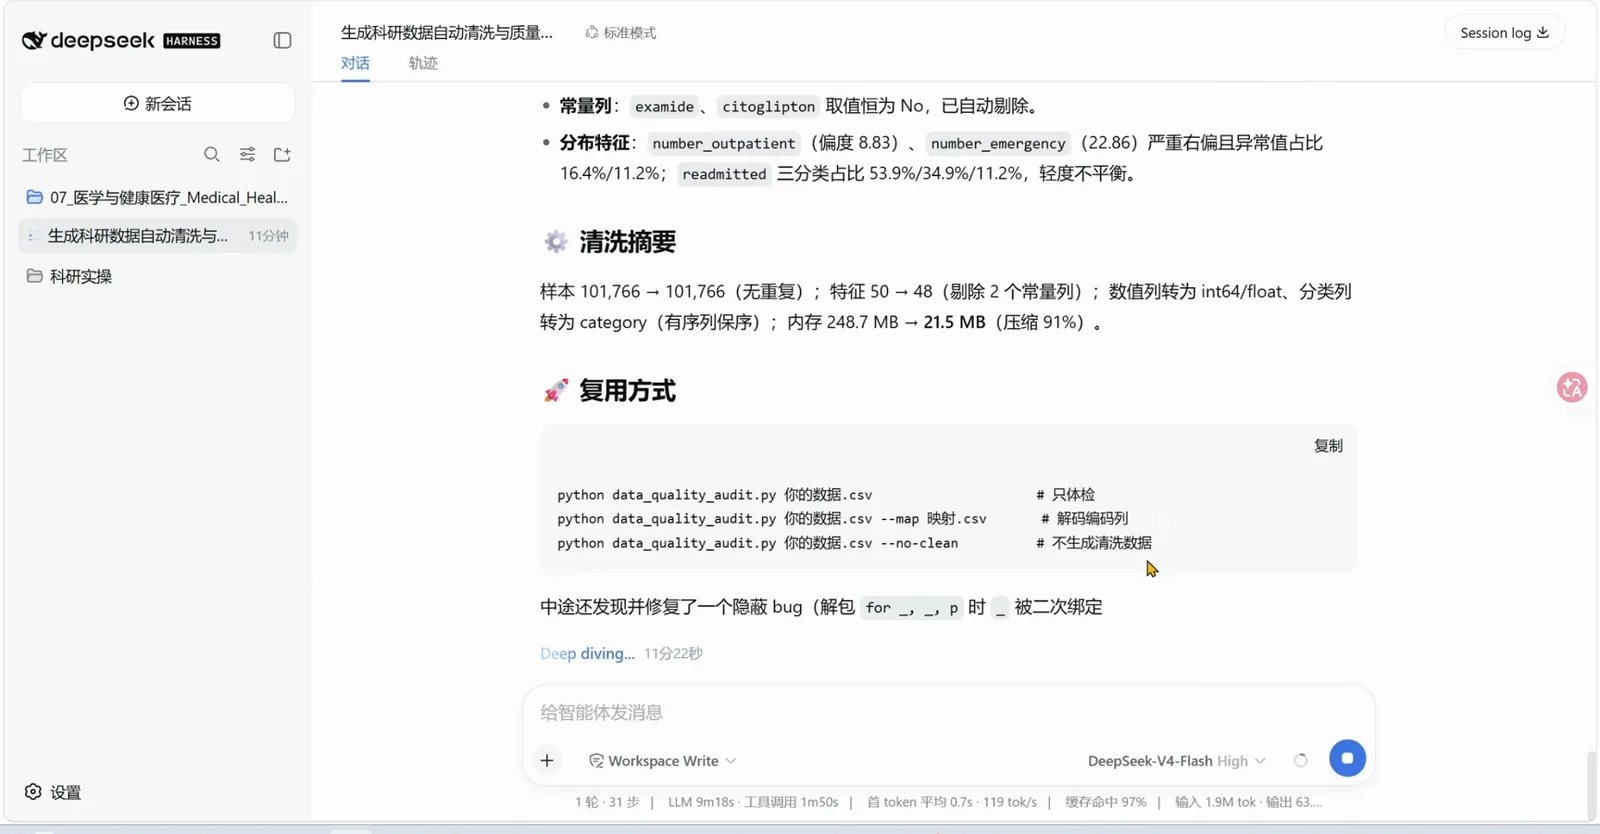
- ▸一個 prompt 跑通真實 101,766 筆 EHR 資料表:剔除 examide、citoglipton 兩個常數欄位,特徵 50 → 48,數值/類別欄位轉換後記憶體壓縮 91%——248.7 MB → 21.5 MB。
- ▸Agent 會自我檢查:它發現自己的審查腳本有兩個 bug,連續 Edit 四次修復後重跑,交出資料品質報告——6 輪 98 步,零手寫程式碼。
- ▸一段中文 Cox prompt(「變數你自行決定」)加上「Nature 級科研圖表」的要求,拿到 lifelines/R survival 程式碼和 dpi=300 的 PNG+SVG 圖表。
- ▸Results 章節直接排版進 Word——數字全部真實計算、三線表規範——整段錄影的全部 API 開銷是 353 次請求共 ¥3.10。
從一張 10 萬行原始表到 Results 章節
第一部分 · 一次性設定
- 1
掛上自己的 DeepSeek API Key
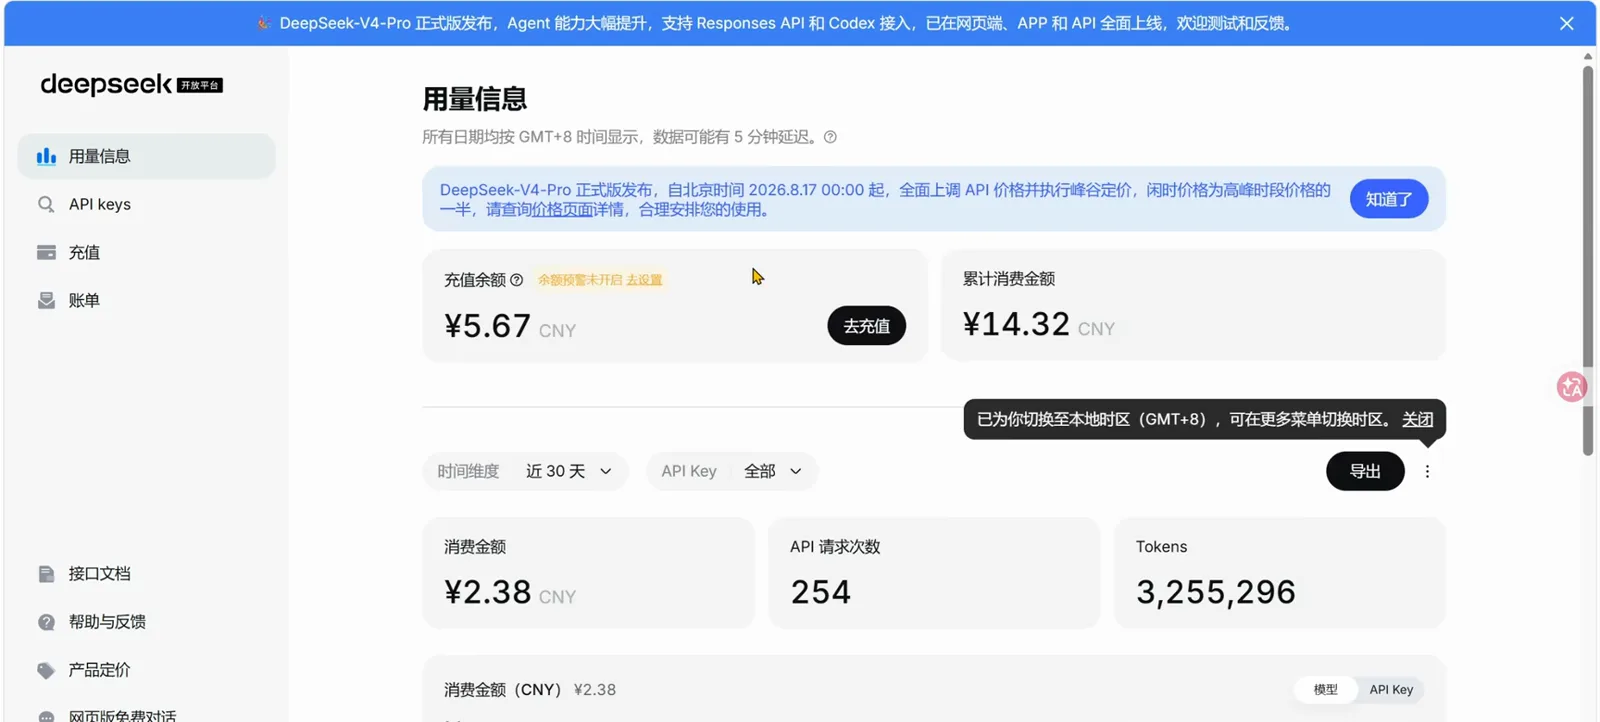
整個流程跑在你自己的 Key 上。錄影裡作者先停在開放平台用量頁——餘額 ¥5.67、累計消費 ¥14.32、此前 254 次請求 3,255,296 tokens——然後建立 Key,貼進 dsh 的「新增一個 API Key」彈窗。這頁別關:最後一步還要回來對帳。
先到 DeepSeek 開放平台拿 Key,這頁用量最後還能當對帳單看 2:45 處 - 2
選模型:V4-Flash 還是 V4-Pro
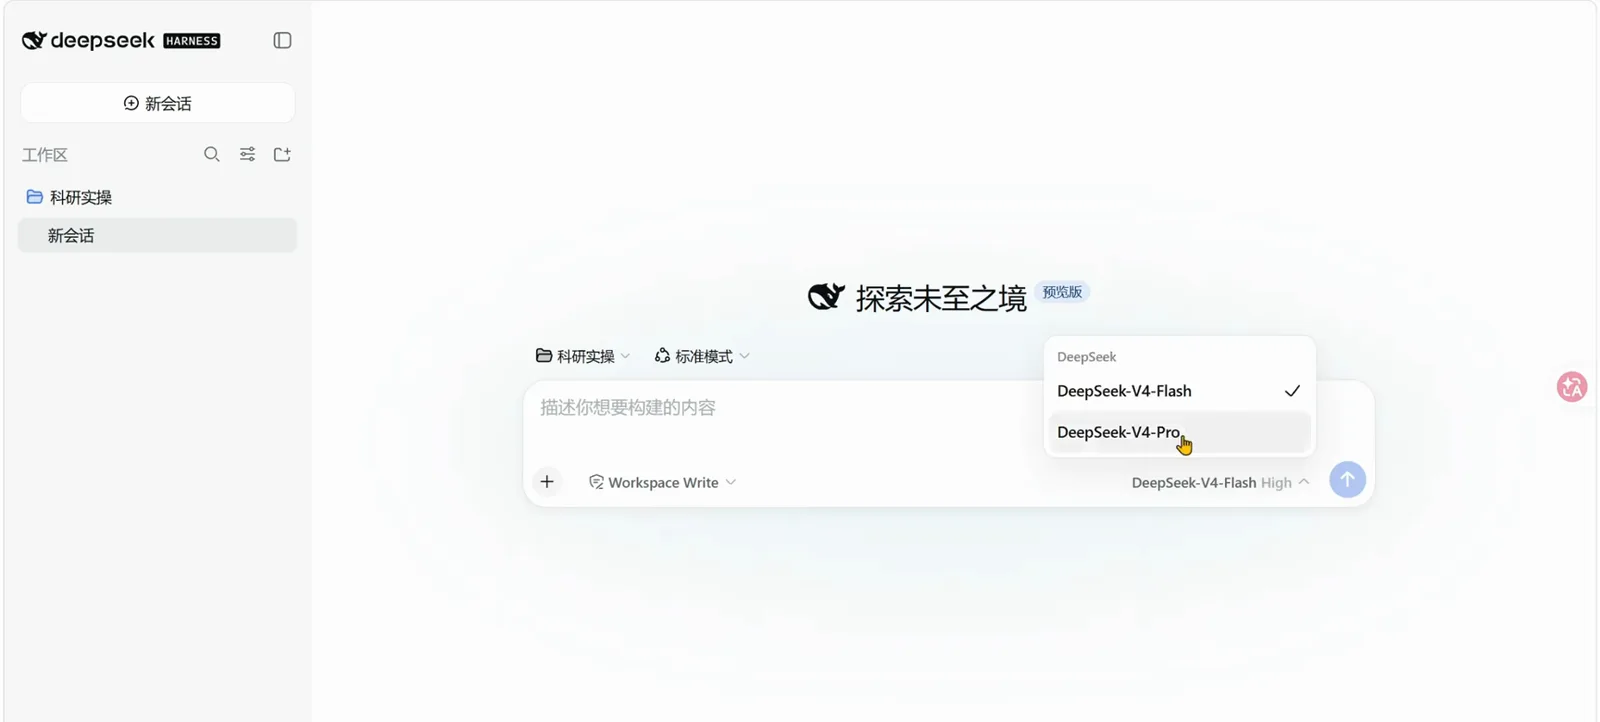
在 07_醫學與健康醫療(Medical & Health)工作區新建會話,模型選擇器只有兩顆:預設的 DeepSeek-V4-Flash(High 檔)和 DeepSeek-V4-Pro。這 22 分鐘的清洗、統計、畫圖、寫 Word 全程都跑在 V4-Flash 上,Pro 留給更重的活。
選擇器裡就兩顆模型:全程跑在 V4-Flash(High)上看 3:45 處 - 3
把 10 萬行原始表直接丟進去
示範資料是真實公開資料集 US_Hospitals_Diabetes:10 萬行 EHR 住院資料表,101,766 筆住院紀錄。Excel 裡它刻意「難看」——公式列裡是編碼過的 race 值,用藥欄位填滿 No / Steady / Down / Up,一行裡什麼型別都有。原樣丟給 dsh 就行,解碼是它的事。
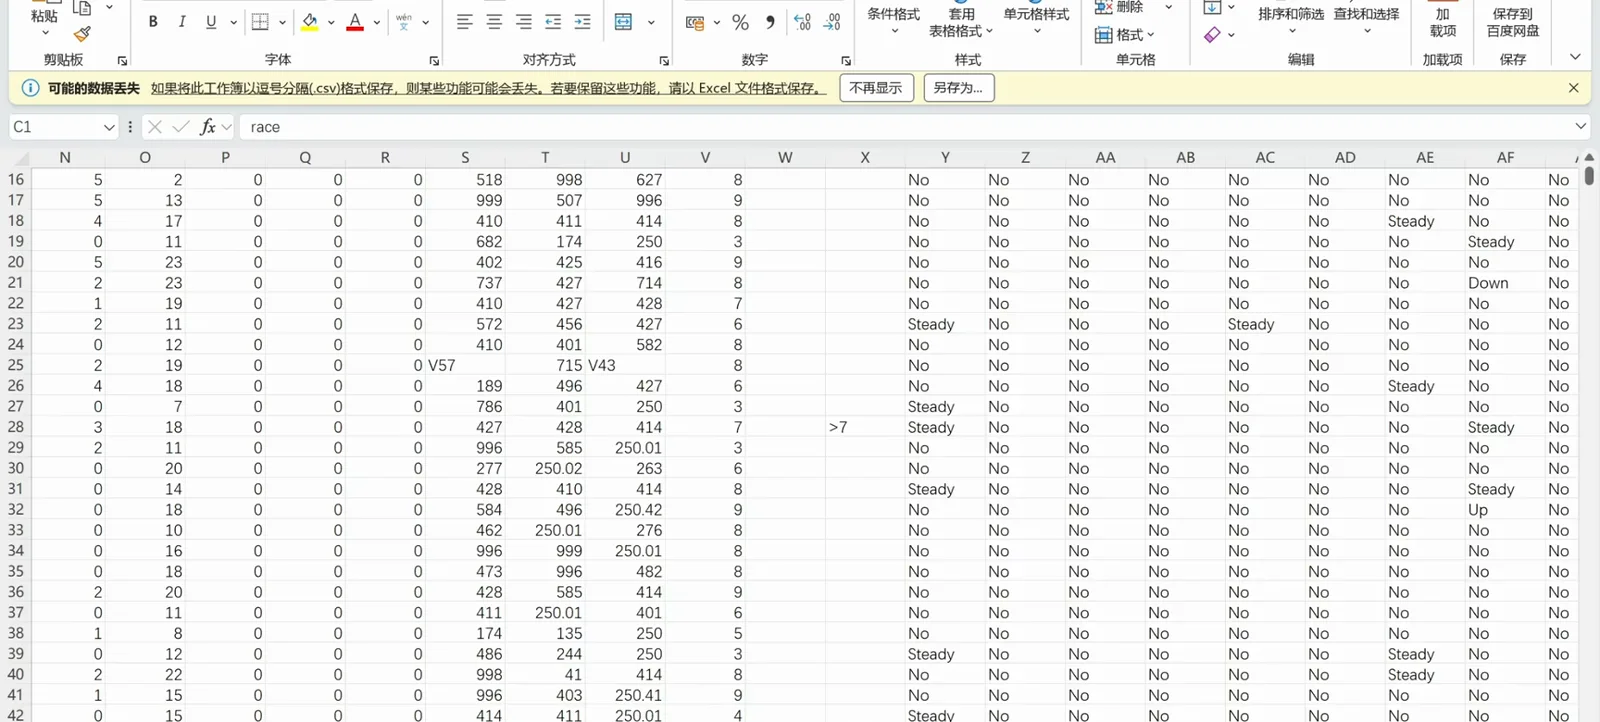
原始表長這樣:編碼值加混合型別,原樣交出去即可看 5:00 處
第二部分 · 清洗、審查、加統計
- 4
一句話啟動清洗,Agent 自己幫自己抓錯
一句中文——做資料輪廓、清洗、品質審查——流水線就開跑。會話自己寫 data_quality_audit.py,又發現自己程式碼裡兩個 bug:型別推斷順序讓 age/weight 區間欄位誤觸 to_datetime 警告、缺失字典的元組取值寫錯;連續 Edit 四次、PowerShell 重跑、讀回 01_Diabetes_EHR_data_quality_report.md——6 輪 98 步,LLM 24m7s,快取命中 99%。留下的腳本可以重複使用:
$python data_quality_audit.py 你的数据.csv # 只体检$python data_quality_audit.py 你的数据.csv --map 映射.csv # 解码编码列$python data_quality_audit.py 你的数据.csv --no-clean # 不生成清洗数据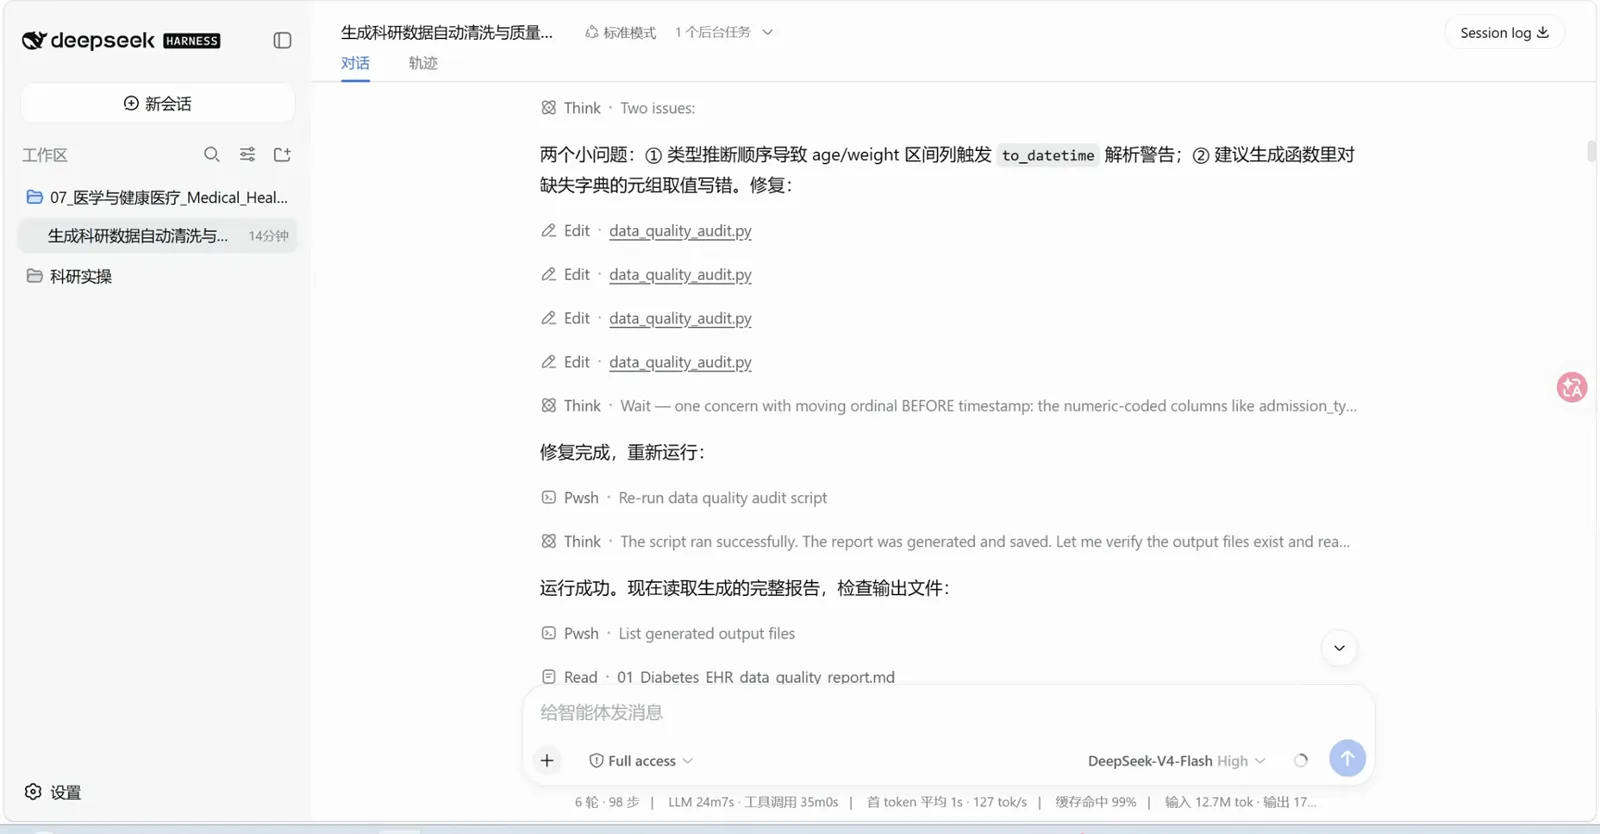
自己查自己:4 次編輯、一次重跑、讀回品質報告,全程無人工看 1:00 處 - 5
用 persona prompt 追加統計檢定
統計檢定也是一句話的事。錄影裡輸入的是生存分析統計家人設:「你是一名腫瘤與慢性病生存分析統計學家……用 Python lifelines / R survival 編寫 Cox 比例風險迴歸程式碼」,追蹤時間、終點事件、分組、協變數全部留空(「需要的變數你自行決定」),結尾再加一句「你是一名 Nature 級科研圖表視覺化大師」。此時輸入框上方,報告檢查已確認 examide 被正確剔除、清洗後 CSV 結構驗證通過。
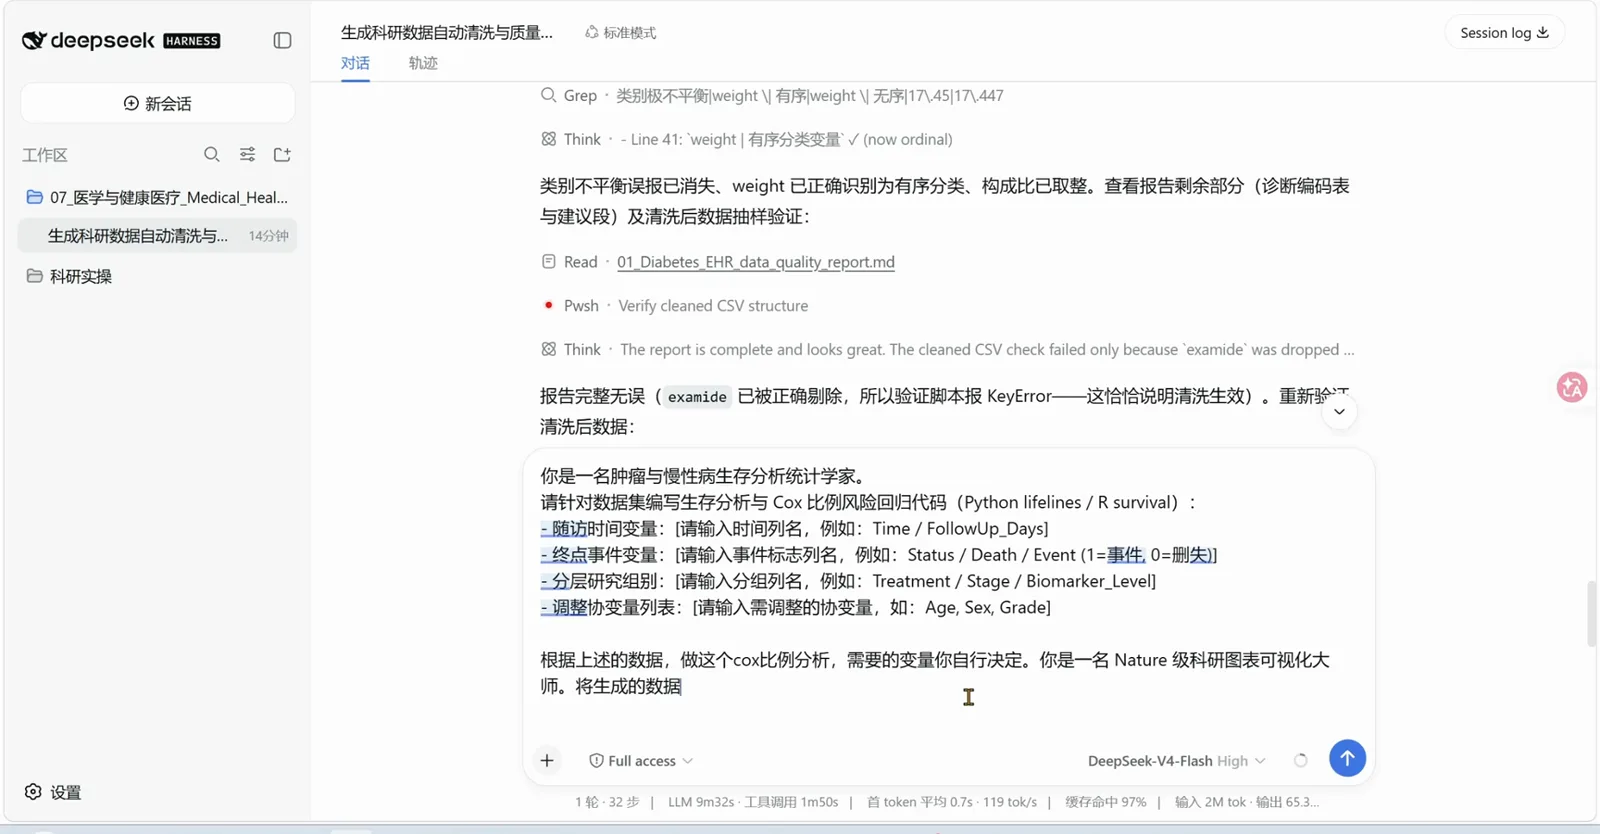
一段中文:Cox 回歸變數讓 Agent 自己定,圖表一併要看 10:15 處
第三部分 · 圖表、論文、帳單
- 6
期刊圖表按成文規範出圖
圖表好看不是運氣。作者維護一份 16 頁的 Prompt 手冊(見文末來源),第 11 頁規定 raincloud 圖配方:半邊小提琴 KDE + 箱形圖 + 抖動散點(alpha=0.6)、顯著性橫線(p<0.05 / 0.01 / 0.001)、Nature/Lancet 配色 #4DBBD5 #E64B35 #00A087 #3C5488、移除頂部與右側框線(sns.despine),並硬性要求 dpi=300 的 PNG 外加一份 SVG 供排版使用。
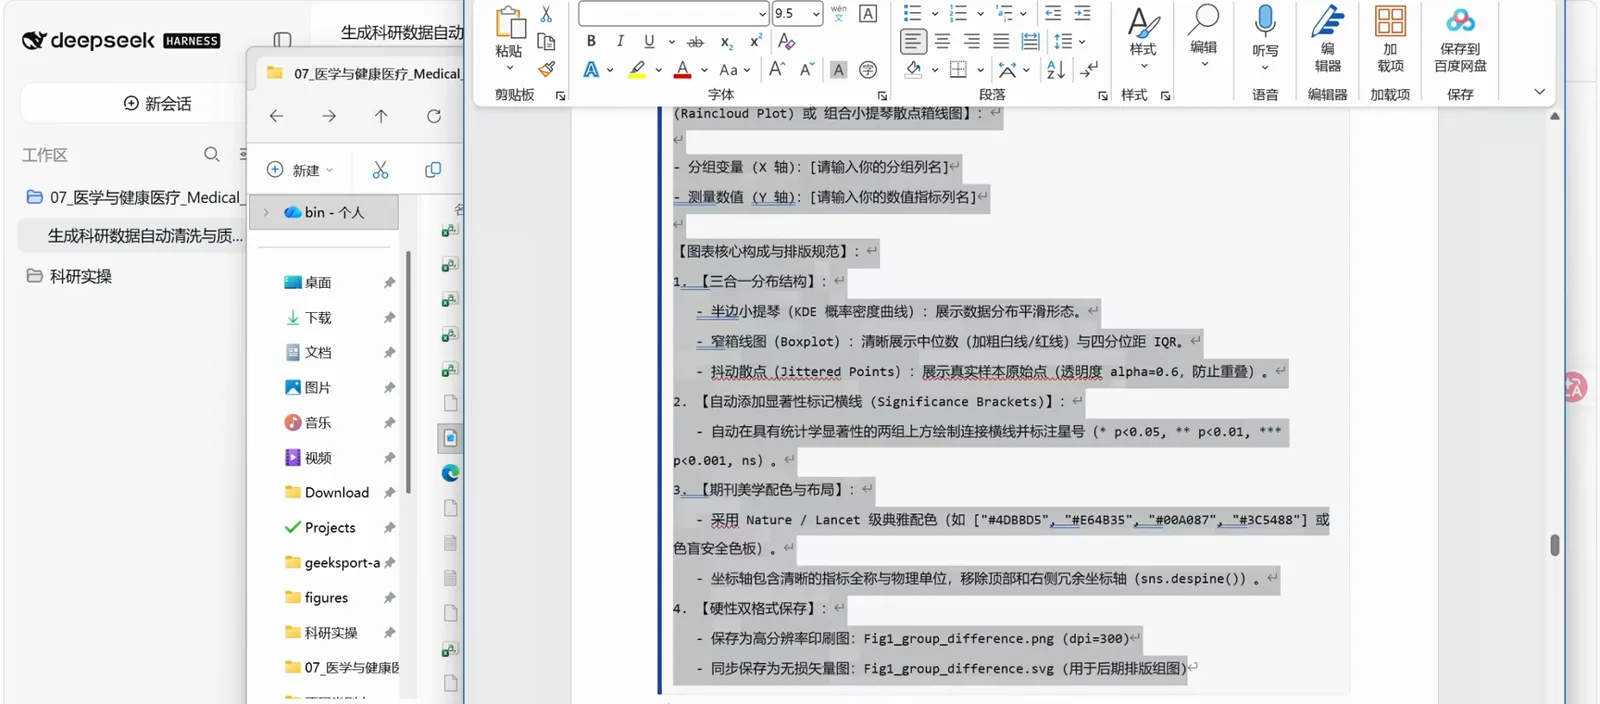
手冊第 11 頁:raincloud 配方、配色、顯著性橫線與 dpi=300 硬規矩看 15:00 處 - 7
Results 章節自動成稿,數字全部真實計算
generate_results_docx.py 產出 output_results.docx,統計量是算出來的不是編的——會話原話「統計量全部基於 1000 行資料真實計算」。示範版 Results 涵蓋 1,000 筆住院子集:用藥 796 筆 vs 未用藥 204 筆,年齡 59.86±17.54 vs 64.41±17.24(Welch t = 3.35,P < 0.001),急診入院 21.0% vs 9.8%;Table 1 排成標準三線表(頂線/底線 1.5 磅、欄頭線 0.75 磅、無豎線)。會話還做了 XML 級排版校驗:122 個 Run 字型全部合規。
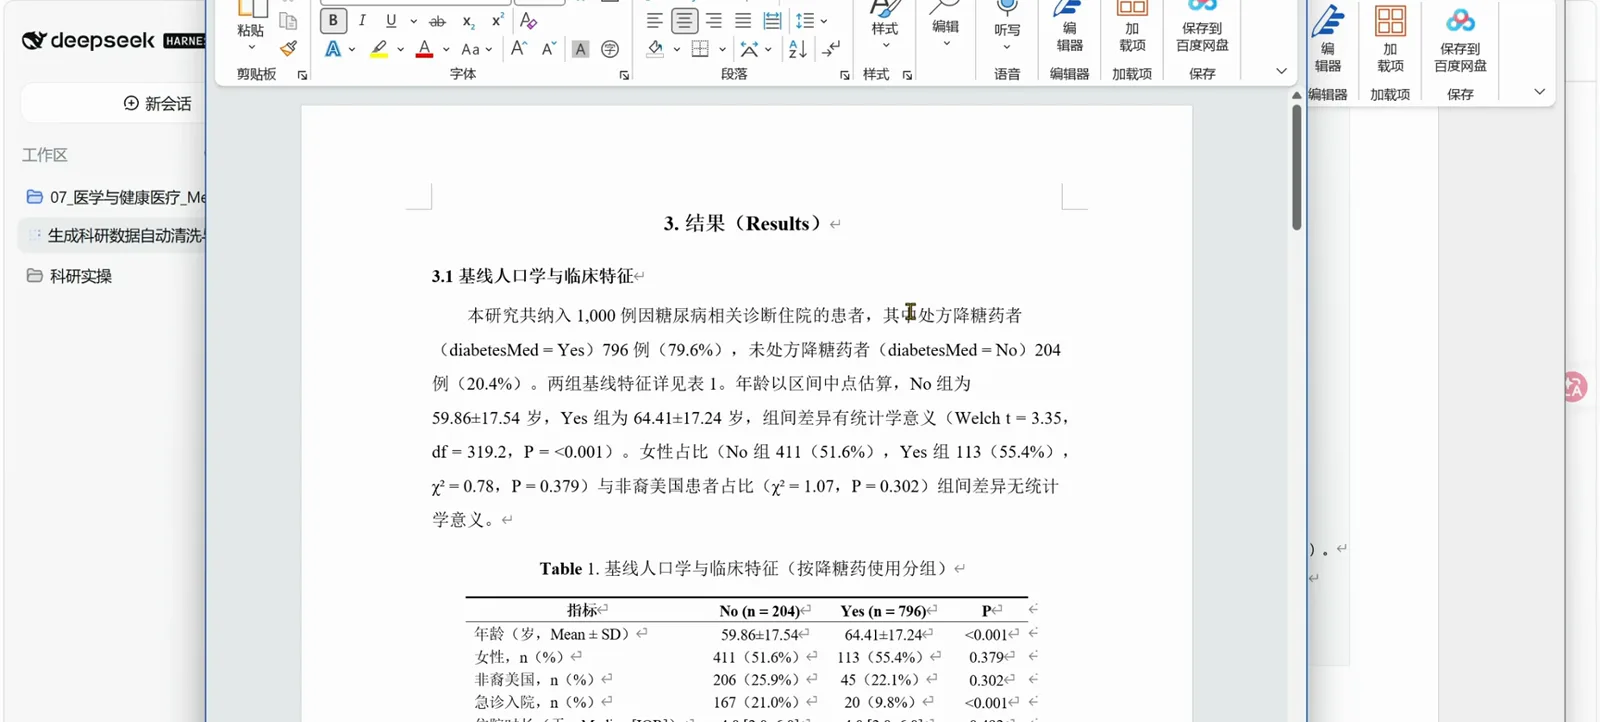
Word 版 Results 章節:數字是算出來的,Table 1 是標準三線表看 16:00 處 - 8
產出全部存成檔案,不只活在聊天紀錄裡
跑完之後,工作區資料夾裡多了 23 個項目:雙格式圖表(Fig1_group_difference.png 146 KB + .svg 204 KB)、四支腳本(raincloud_plot.py、survival_cox_analysis.py、data_quality_audit.py、verify_and_explore_medical_data.py)、survival_analysis_report.md、清洗後的 survival_dataset.csv 和 Word 報告。換資料重跑會覆蓋同名檔案,成果不鎖在會話裡。
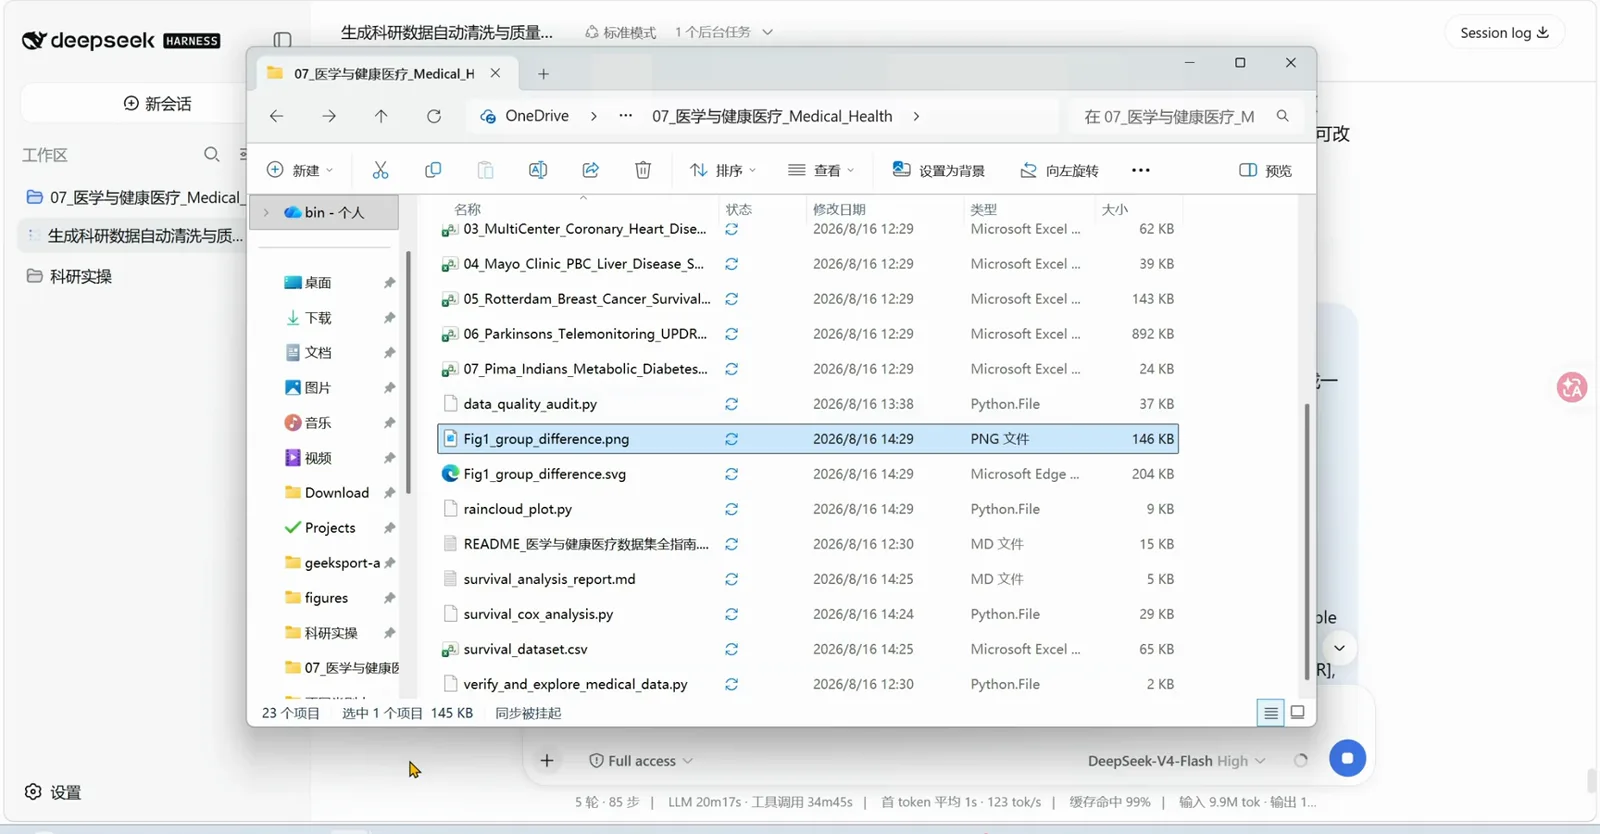
跑完之後:圖、腳本、報告、清洗資料,都是普通檔案看 15:30 處 - 9
發表之前,先看一眼帳單
影片結尾停在 DeepSeek 用量頁:清洗、統計、畫圖、寫 Word 全部跑完,可見月份內共消費 ¥3.10、353 次請求、16,137,371 tokens,8 月 16 日當天的高峰是 ¥0.73(deepseek-v4-flash)。你跑完第一次,也來這一頁對帳。
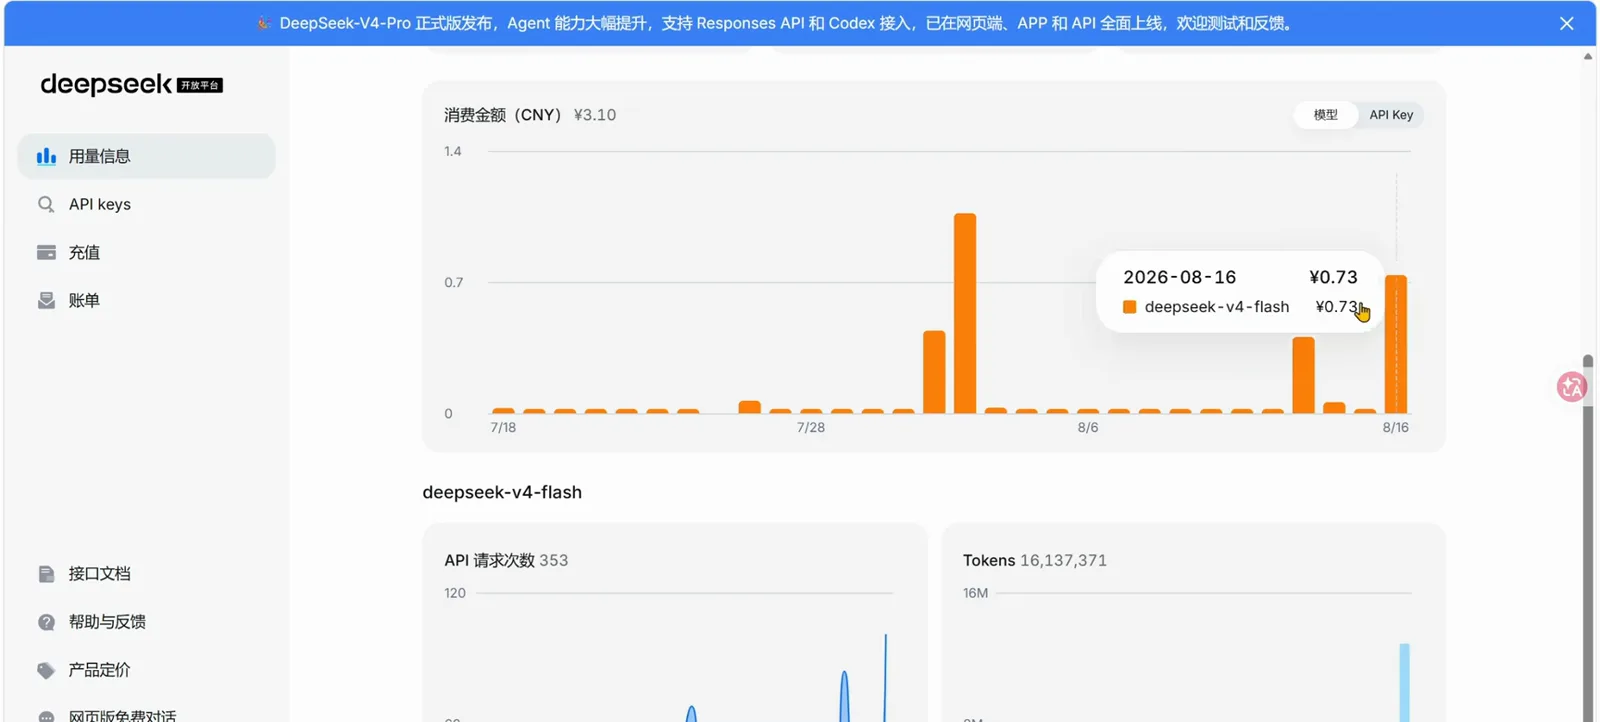
對帳單:整段錄影 ¥3.10、1,613 萬 tokens看 21:00 處
常見問題
科研族群把自己的資料交給 dsh 之前,最常問的幾件事。
不會 Python、不懂統計,能照著跑嗎?
能。錄影裡所有 prompt 都是普通中文;程式碼由 Agent 自己寫、自己除錯、自己重跑——它甚至主動修了自己審查腳本裡的兩個 bug。但發表前你得自己判斷統計對不對:影片作者最後也是親自審核生成的程式碼和表格。
只能用這個糖尿病資料集嗎?
不是。US_Hospitals_Diabetes 只是公開示範資料,錄影工作區裡還躺著冠心病、鹿特丹乳癌生存、帕金森遠距監測、Pima 印地安糖尿病等其他公開集;留下的腳本也是參數化的——data_quality_audit.py 指向任意 CSV 即可,--map 解碼編碼欄位,--no-clean 只健檢不清洗。
10 萬行的表,我的機器撐得住嗎?
錄影給出的答案是反向的:數值欄位轉 int64/float、類別欄位轉有序 category 之後,資料表記憶體從 248.7 MB 降到 21.5 MB——分析還沒開始就瘦了 91%。輪廓分析先行,動數字之前你已經看到資料的形狀。
生成的 Results 章節能直接投論文嗎?
把它當「數字可驗證的初稿」。會話從資料裡真實計算統計量(示範子集為 1,000 筆住院),還做了 docx 的 XML 級排版校驗(字型、行距、三線表磅值),但作者本人仍逐段審核程式碼與表格後才採信。請在你自己的環境裡重現數字,並請統計專業的人把關——本頁是方法示範,不構成醫療建議。
相關攻略
同一台引擎,隔壁的工作流。
一個 prompt 合併 Excel 報表
小一號的兄弟工作流:三張費用表 1,800 行,靠規則、欄位對映與驗收標準一個會話合併。
閱讀教學一句話生成 PPT 簡報
Results 章節要變成彙報投影片時,用得上 office 外掛家族。
閱讀教學長篇寫作工作台
章節規劃與文風鎖定,科研寫作的另一半流水線。
閱讀教學DeepSeek 模型按任務切換
第 2 步選擇器背後的 V4-Flash 與 V4-Pro、推理檔位——什麼時候省著用,什麼時候上強度。
閱讀教學常見錯誤與排查百科
裝不起來、啟動崩潰、更新出錯——自己跑之前先對著真實修復案例過一遍。
閱讀教學科研外掛聚合
文獻、引用、資料方向的科研外掛,給這套分析流程加裝備。
閱讀教學來源與致謝
全部截圖與螢幕數字取自第一支影片,並經全解析度逐一複核;研究外掛清單由第二支影片互證;圖表與三線表規範引自作者發布的 Prompt 手冊。資料集為作者聲明的公開資料;文中統計結果均為工作流示範,不構成醫療建議。