
README
dsh-short-video-studio

完全本地 · 免费 · 零云端依赖的短剧 / 动画画布工作室,作为 DeepSeek Harness 双面插件运行。所有生成都跑在本地 ComfyUI 上——不需要任何付费云 API、不消耗额度,装好即用,一次生成、无限出片。
画质已可达 2K / 4K 交付:生成侧有两阶段潜空间放大(hires:首遍 896×512 → latent ×1.5 → 二遍重建,交付 1344×768)与学习式 3D latent 放大(…-2k 族:×2 → 交付 2688×1536);后处理侧有独立的视频超分能力 video.upscale(逐帧 CNN ×2 / ×4,音轨原样带回)——原生片段一趟 ×4 即到 4032×2304(124 帧实测 241.3s),或 2K 再 ×2 到同样尺寸(261.6s)。三条路线怎么选见分辨率与画质(2K / 4K)。
一句话:Agent 按你定义的 skill 编排流程,把生成请求派发到本地 ComfyUI 执行,产物落进可视化画布,还能通过飞书远程操控创作。
🌟 模型无关:FLUX 2 / MiniMax H3 只是插件随附的内置默认工作流,不是产品边界。本插件是通用的 ComfyUI 工作流执行器 + 能力注册表——任何 ComfyUI 能跑的模型(SDXL / SD3.5 / Qwen-Image / Wan / CogVideoX / LTX / 本地 Kling 等,图片或视频、带不带声音都可以)都能通过导入一份工作流清单接入,skill 与工具契约无需任何改动。换模型 = 加一份 JSON。
功能亮点
🖥️ 本地化、0 成本的视频工作流
- 零云端依赖:默认图片用 FLUX 2、视频用 MiniMax H3 音视频 AV 模型(带声音、支持参考图绑定与画面内原生字幕,对白直接写进 prompt,无需后期叠加)——两者都只是内置默认,可整体替换为你自己的任何 ComfyUI 模型/工作流。
- 画质/速度三档(tier):图片与视频同一套
fast/balanced/quality——图片长边 1024 / 1344 / 2048(文生图),视频长边 832 / 1344 / 1344;图生图按档给参考图重采样预算 768 / 1056 / 2048(quality 档可出 2K 改绘)。工具面不接受workflow=:实现由配置决定(设置页的家族偏好 / 档位选择 / 钉实现)。加速不暴露到产品层——设置页每个能力只有一条内置默认策略,其余策略由你自己命名与组合(见下)。分辨率按画布比例 × 该档长边自动推导,支持 16:9 / 9:16 / 1:1 等任意画幅,snap32;显式传width/height可覆盖(只传一边时另一边按比例补出来)。 - 图片双模(文生图 / 图生图):t2i 用 FLUX 2 直接出卡(角色卡 / 场景卡 / 分镜图),i2i 用 FLUX 2 ReferenceLatent 改绘——保持主体不变、换背景 / 场景 / 画风 / 去水印;单张参考图、尺寸跟随参考图(≤1MP),
quality(20 步无 LoRA,保真)/fast(8 步 Turbo LoRA,调试快),可一次出 1–4 张。 - 同场景续接镜「续得上」:
continuity_from=上一镜节点 id⇒ 链式续接——把上一镜的服务端 latent 直接钉进本镜(画面逐帧接住它的结尾、音频从接缝继续,实测接缝画面差 2.6–7.0,无续接对照 32–68),不需要上传图片、也不吃画质。r2v 与 i2v 两侧都支持(i2v 链式实现另见下),跨形状续接(上一镜 r2v → 本镜 i2v)同样可用。链的硬约束见档位与加速策略与docs/shot-chain-continuity.md。 - 画质可上 2K / 4K:三条路线都在本地跑通——生成内两阶段放大(hires,交付 1344×768)、生成内学习式 latent ×2(
…-2k族,交付 2688×1536,可与链式续接叠用,见下)、以及独立视频超分video.upscale(画布片段 → 逐帧 CNN ×2/×4,音轨原样带回,原生一趟到 4032×2304 只需 241.3s/124 帧)。超分建议按分镜做(失败只毁一镜、可断点重跑)。详见分辨率与画质(2K / 4K)。 - 完整后处理:同场景续接(链式 latent 或末帧串联)、生成式转场镜、抽帧、拼接合成(本机有 ffmpeg 走零重编码,否则 ComfyUI 纯节点链路)、超分提分辨率——一条龙出片。
🎨 可视化画布
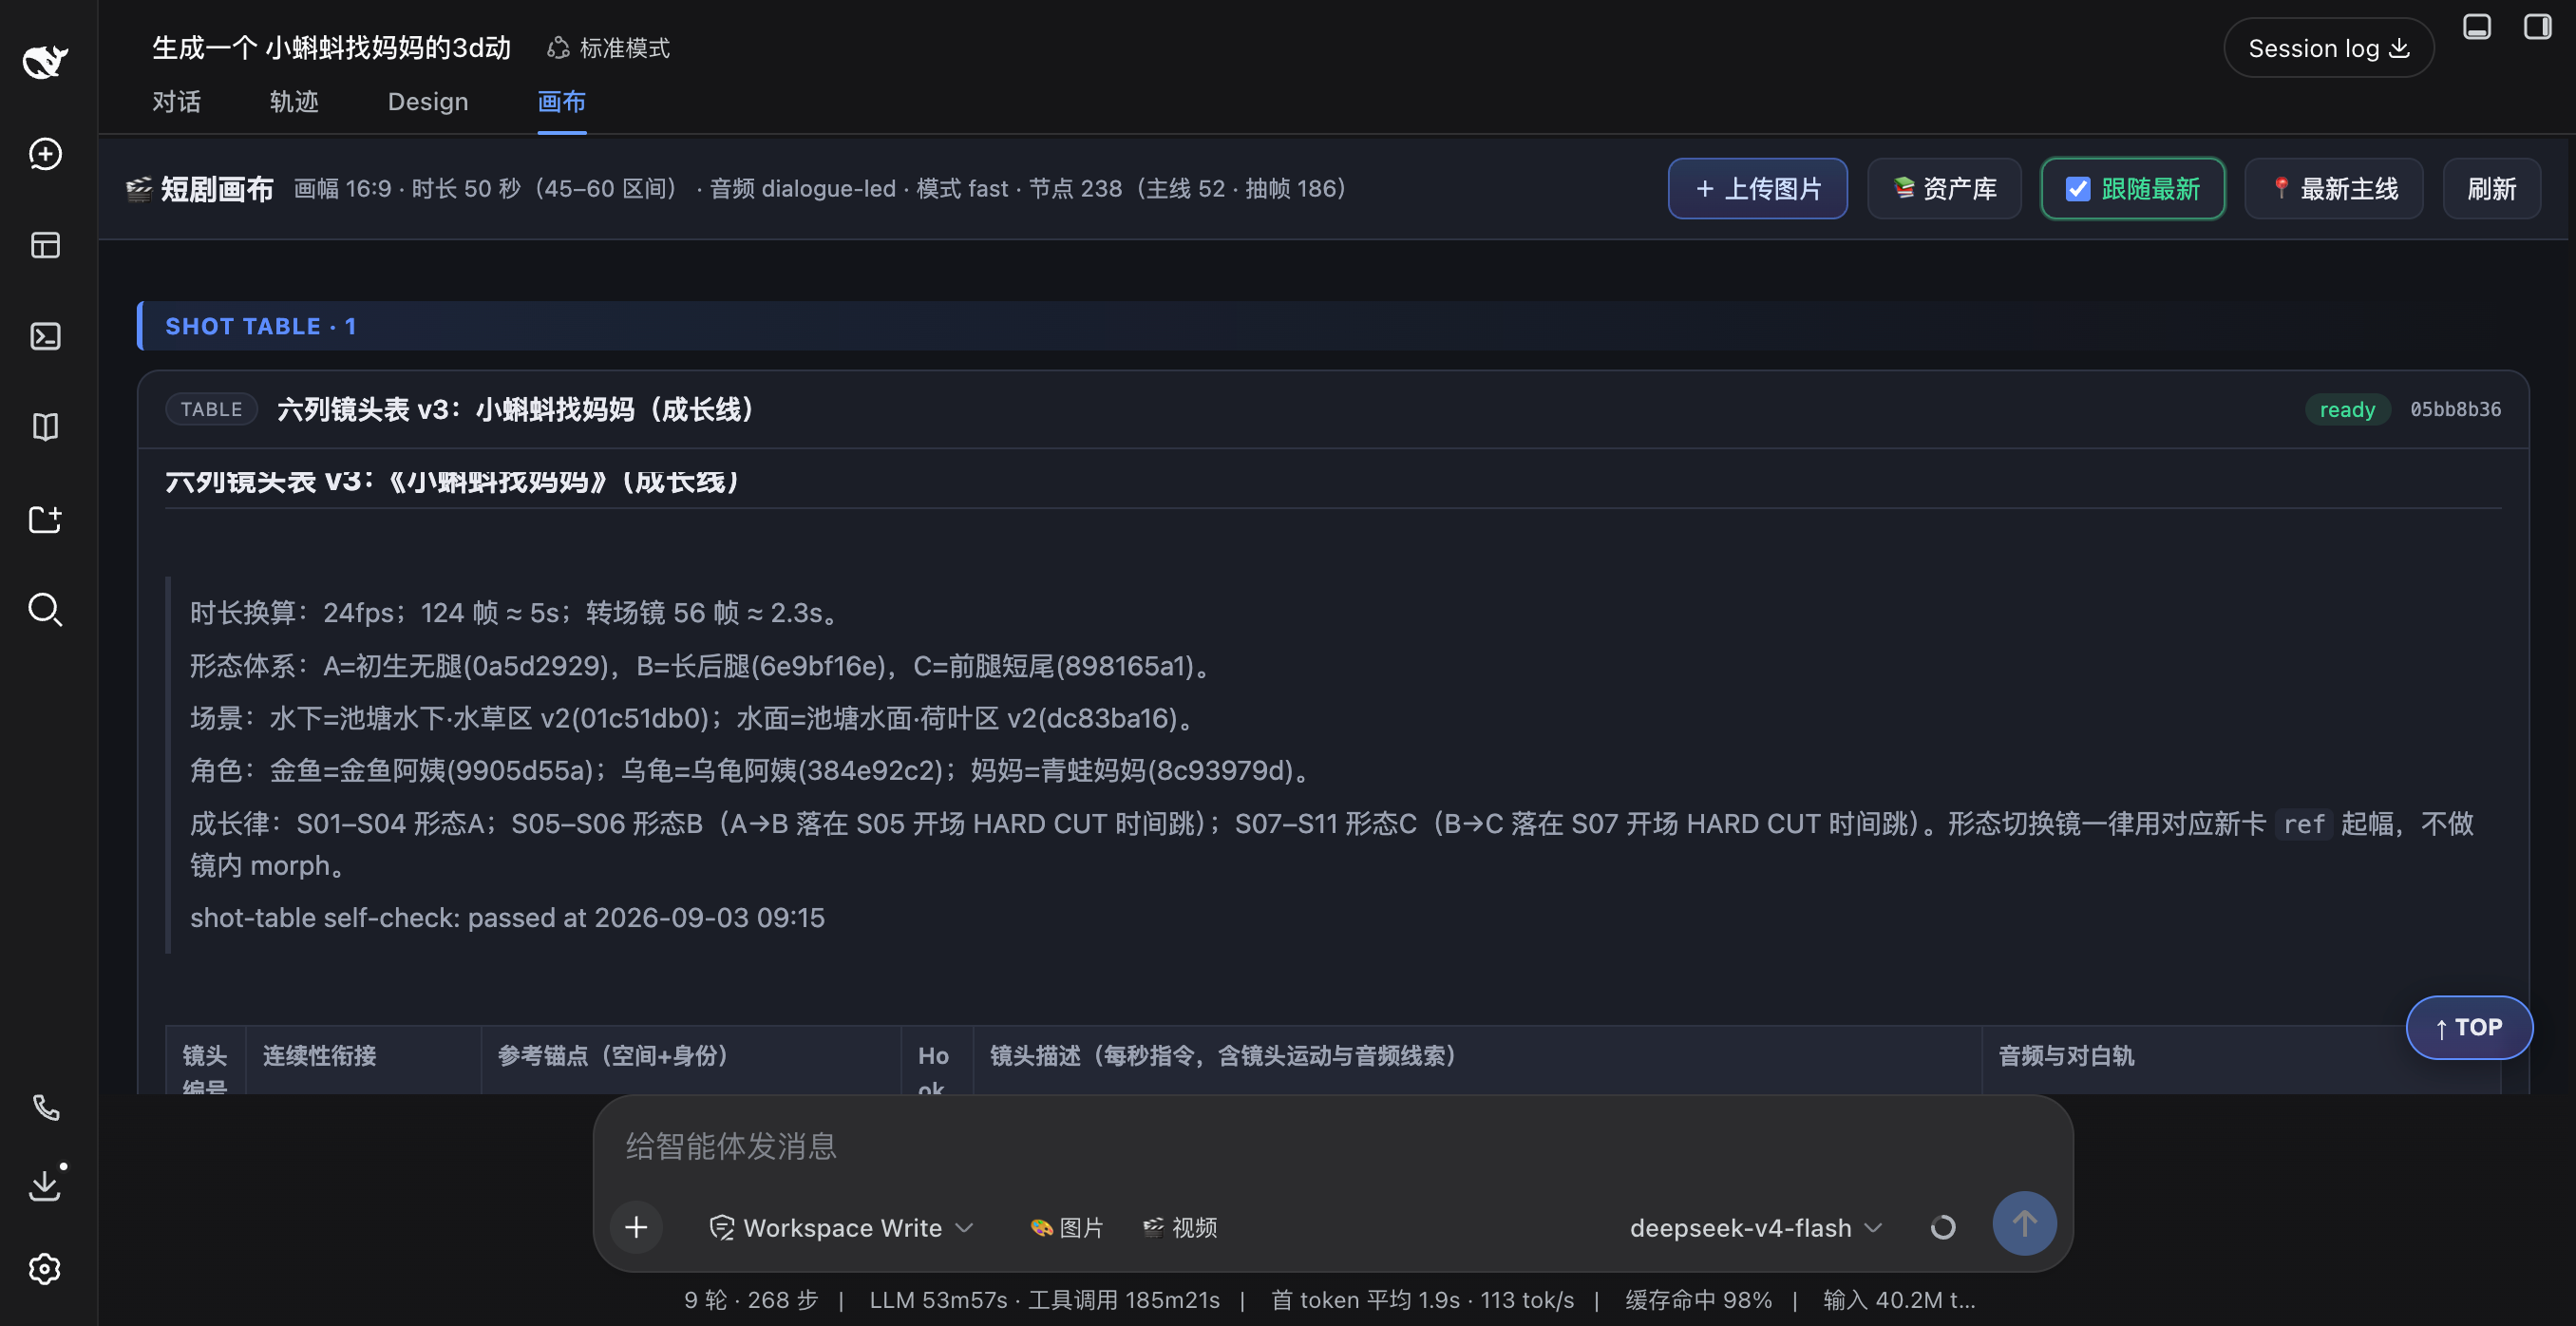
- 每个会话多一个「画布」tab,按生产顺序预览 / 编辑 / 重做每一步产物:简报、大纲、角色卡、场景卡、镜头表、分镜、逐镜片段、成片。
- 文本节点实时渲染 markdown(标题/表格/列表/代码块),媒体节点直接内嵌预览;分组、排序、删除、入库(一键登记为跨会话资产)都在画布上完成。
- 自己添加资产:画布顶栏「+ 上传图片」可直接把本地 png/jpg/webp/gif 传成角色卡/场景卡等资产节点(无需先生成);「📚 资产库」带缩略图把已入库的跨会话资产取到当前画布,图片类即可作为 ref 参考直接驱动视频生成。
- 入库覆盖三类载体:画布上的图片(角色卡 / 场景卡 / 风格锚点)、视频(镜头片段 / 成片)、文本与表格(镜头表 / 分镜文档 / 提示词)节点都能点「入库」登记进跨会话资产库;资产库对话框里可删除(连同库文件清理,画布上的副本不受影响)。载体与语义类别是两个正交维度:type 决定分组,kind(image/video/text)决定怎么存、怎么取回、以及能不能当 ref 参考图。
- 生成的卡也能编辑替换:已生成/已入库的角色卡、场景卡上点「编辑」→ 选本地图即可替换该卡图片(节点/标题/分组保留;若已入库会解除绑定,替换后按需重新「入库」登记新版本)。
- 输入框视频生成(
video-generateskill 的可视化入口):会话输入框工具行左端保留「🎨 图片 / 🎬 视频」开关。点「🎬 视频」即把/video-generate斜杠命令(内联type/tier/ratio/size/length/refs/first/last参数)写入官方输入框,用 dsh 原生 skill 加载机制加载内置video-generateskill;同时在输入卡上方弹出紧凑工具条——类型 r2v(参考图生成)/ i2v(首/末帧生成)、档位下拉(选项来自档位矩阵,带实测耗时)、比例、时长(原生下拉菜单)与「参考图 / 首帧 / 末帧」自定义上传元素(经/canvas/upload落为画布节点;dsh 原生附件无法端到端转成ref_nodes,故保留自定义图片输入)。prompt 接着写在官方输入框空行后,改参数时工具条自动重写命令行、保留 prompt;发送直接点 dsh 默认发送键(提交整条草稿,不额外做发送按钮、不劫持 Enter),Agent 按对应 skill 解析命令行参数并调用生成工具出片,产物回进对话并落画布。图片生成(🎨image-generate)同机制:工具条切换 文生图(t2i)/ 图生图(i2i)——t2i 选比例与张数(默认 1344×768,可 1–4 张);i2i 上传单张参考图(图 chip + ➕ 新增格,与 dsh 原生上传同款 64px 样式)、选 quality / fast 档与张数,命令头自动写/image-generate type=… tier=… refs=<画布节点id>。档位按模式独立记忆:视频默认fast(调试快)、图生图默认quality(保真优先),手动选过后各自记住;上传的参考图即画布节点(删除/切型/清空草稿都会同步清理,画布不残留)。 - 跟随 DSH 的浅色 / 深色:画布页自带两套调色板,跟着宿主的主题服务走(含「跟随系统」与自定义主题的
colorScheme)。首屏由?theme=定,避免先闪一下另一种底色;运行中你在设置里一切换,画布立刻跟着换。原生控件(下拉、滚动条、复选框)也跟着color-scheme变。 - Agent 工具与画布页读写同一份持久状态,对话推进的每一步产物都实时可见。
🧩 自由扩展:skill 与 workflow
- skill 可扩展 + 随插件升级自动更新:生产流程完全由 skill 定义(安装时复制到
~/.dsh/skills/,带版本戳:内容没被你改过就随插件升级自动刷新,你改过就只提示、不覆盖)。写一个SKILL.md就能定义你自己的片型流程——插件本体不认识任何流程、任何片型词汇。 - workflow 可扩展:插件退化为「通用 ComfyUI 工作流执行器 + 能力注册表」。换模型、换工作流 = 增删一份 JSON,不动 JS、不动工具、不动系统提示。FLUX 2 / MiniMax H3 只是内置默认,你的任何 ComfyUI 工作流(SDXL / Qwen-Image / Wan / CogVideoX / LTX…)都可以直接导入并设为默认(见导入你的 workflow)。
🎬 多场景创作:一套引擎,任意场景
- 默认内置 3D 动画短片场景(故事创意 → 角色/场景/镜头/分镜/逐镜/合成),但场景不是插件边界。
- 电商宣传视频(商品/卖点 → 展示分镜 + 口播)、教育课件讲解(知识点 → 图解 + 讲解)、品牌故事、纪念短片、Vlog 解说……任何「输入 X → 产出视频」的创作场景,都通过扩展一个 skill 覆盖——复用同一套画布、生成工具、资产库与飞书交付,只换编排规则(见开发你自己的场景 skill)。
- 场景与模型双解耦:场景由 skill 定义、模型由注册表定义,两者互不绑定——电商场景也可以随时切换到你想用的任何 ComfyUI 模型。
📱 飞书集成:远程操控工作台创作
- 会话可以跑在飞书聊天里(配合 dsh-lark 飞书渠道)——你在飞书里说一句话,Agent 就在本地工作台上按 skill 走完整条流水线。
- 每次提问前,插件自动把画布产物送达飞书:图片/视频直接发原文件,简报/大纲/镜头表/分镜等文本自动导出为 PDF(飞书可直接预览)——无需登录任何后台,聊天里就能收片、审片、下指令重做。
安装说明:dsh-lark 飞书渠道是 web profile 的插件,安装时必须带 --profile web;若希望飞书与 dsh web 共用同一个 profile(同一份插件、会话与工作区,Web 画布与飞书聊天看到同一块画布):
dsh plugin --profile web add dsh-lark-channel@latest
装好后在飞书里把 bot 拉进群即可开始远程创作;群聊会先弹审批卡、再出选项卡。
快速开始
前置条件:本机或者远程主机已运行 ComfyUI,并已下载你计划使用的模型——内置默认(FLUX 2 / MiniMax H3)或你自己导入的模型(见配置与导入 workflow)。
# 安装插件(三种来源任选其一;npm 为正式发布渠道,推荐)

# ① npm(正式发布,随版本自动更新安装源)
dsh plugin --profile web add dsh-short-video-studio
# ② GitHub(最新源码)
# dsh plugin --profile web add github:fengyungithub/dsh-short-video-studio
# ③ 本地源码(开发用)
# dsh plugin --profile web add file:/path/to/dsh-short-video-studio

dsh web   # 重启后会话出现「画布」tab;自带 skill 已自动装到 ~/.dsh/skills/
安装后自动完成三件事:skills/ 下 skill 复制到 ~/.dsh/skills/(版本戳刷新:每个副本的 .dsh-studio-manifest 记下插件版本 + 内容哈希,内容被你改过就只提示、绝不覆盖,没改过才随插件升级刷新;DSH_SVS_SKILL_REFRESH=off 关掉刷新、=force 连改过的也覆盖);Web 设置页新增 ComfyUI 配置菜单;会话多出「画布」视图 tab。
开始创作:在会话里说
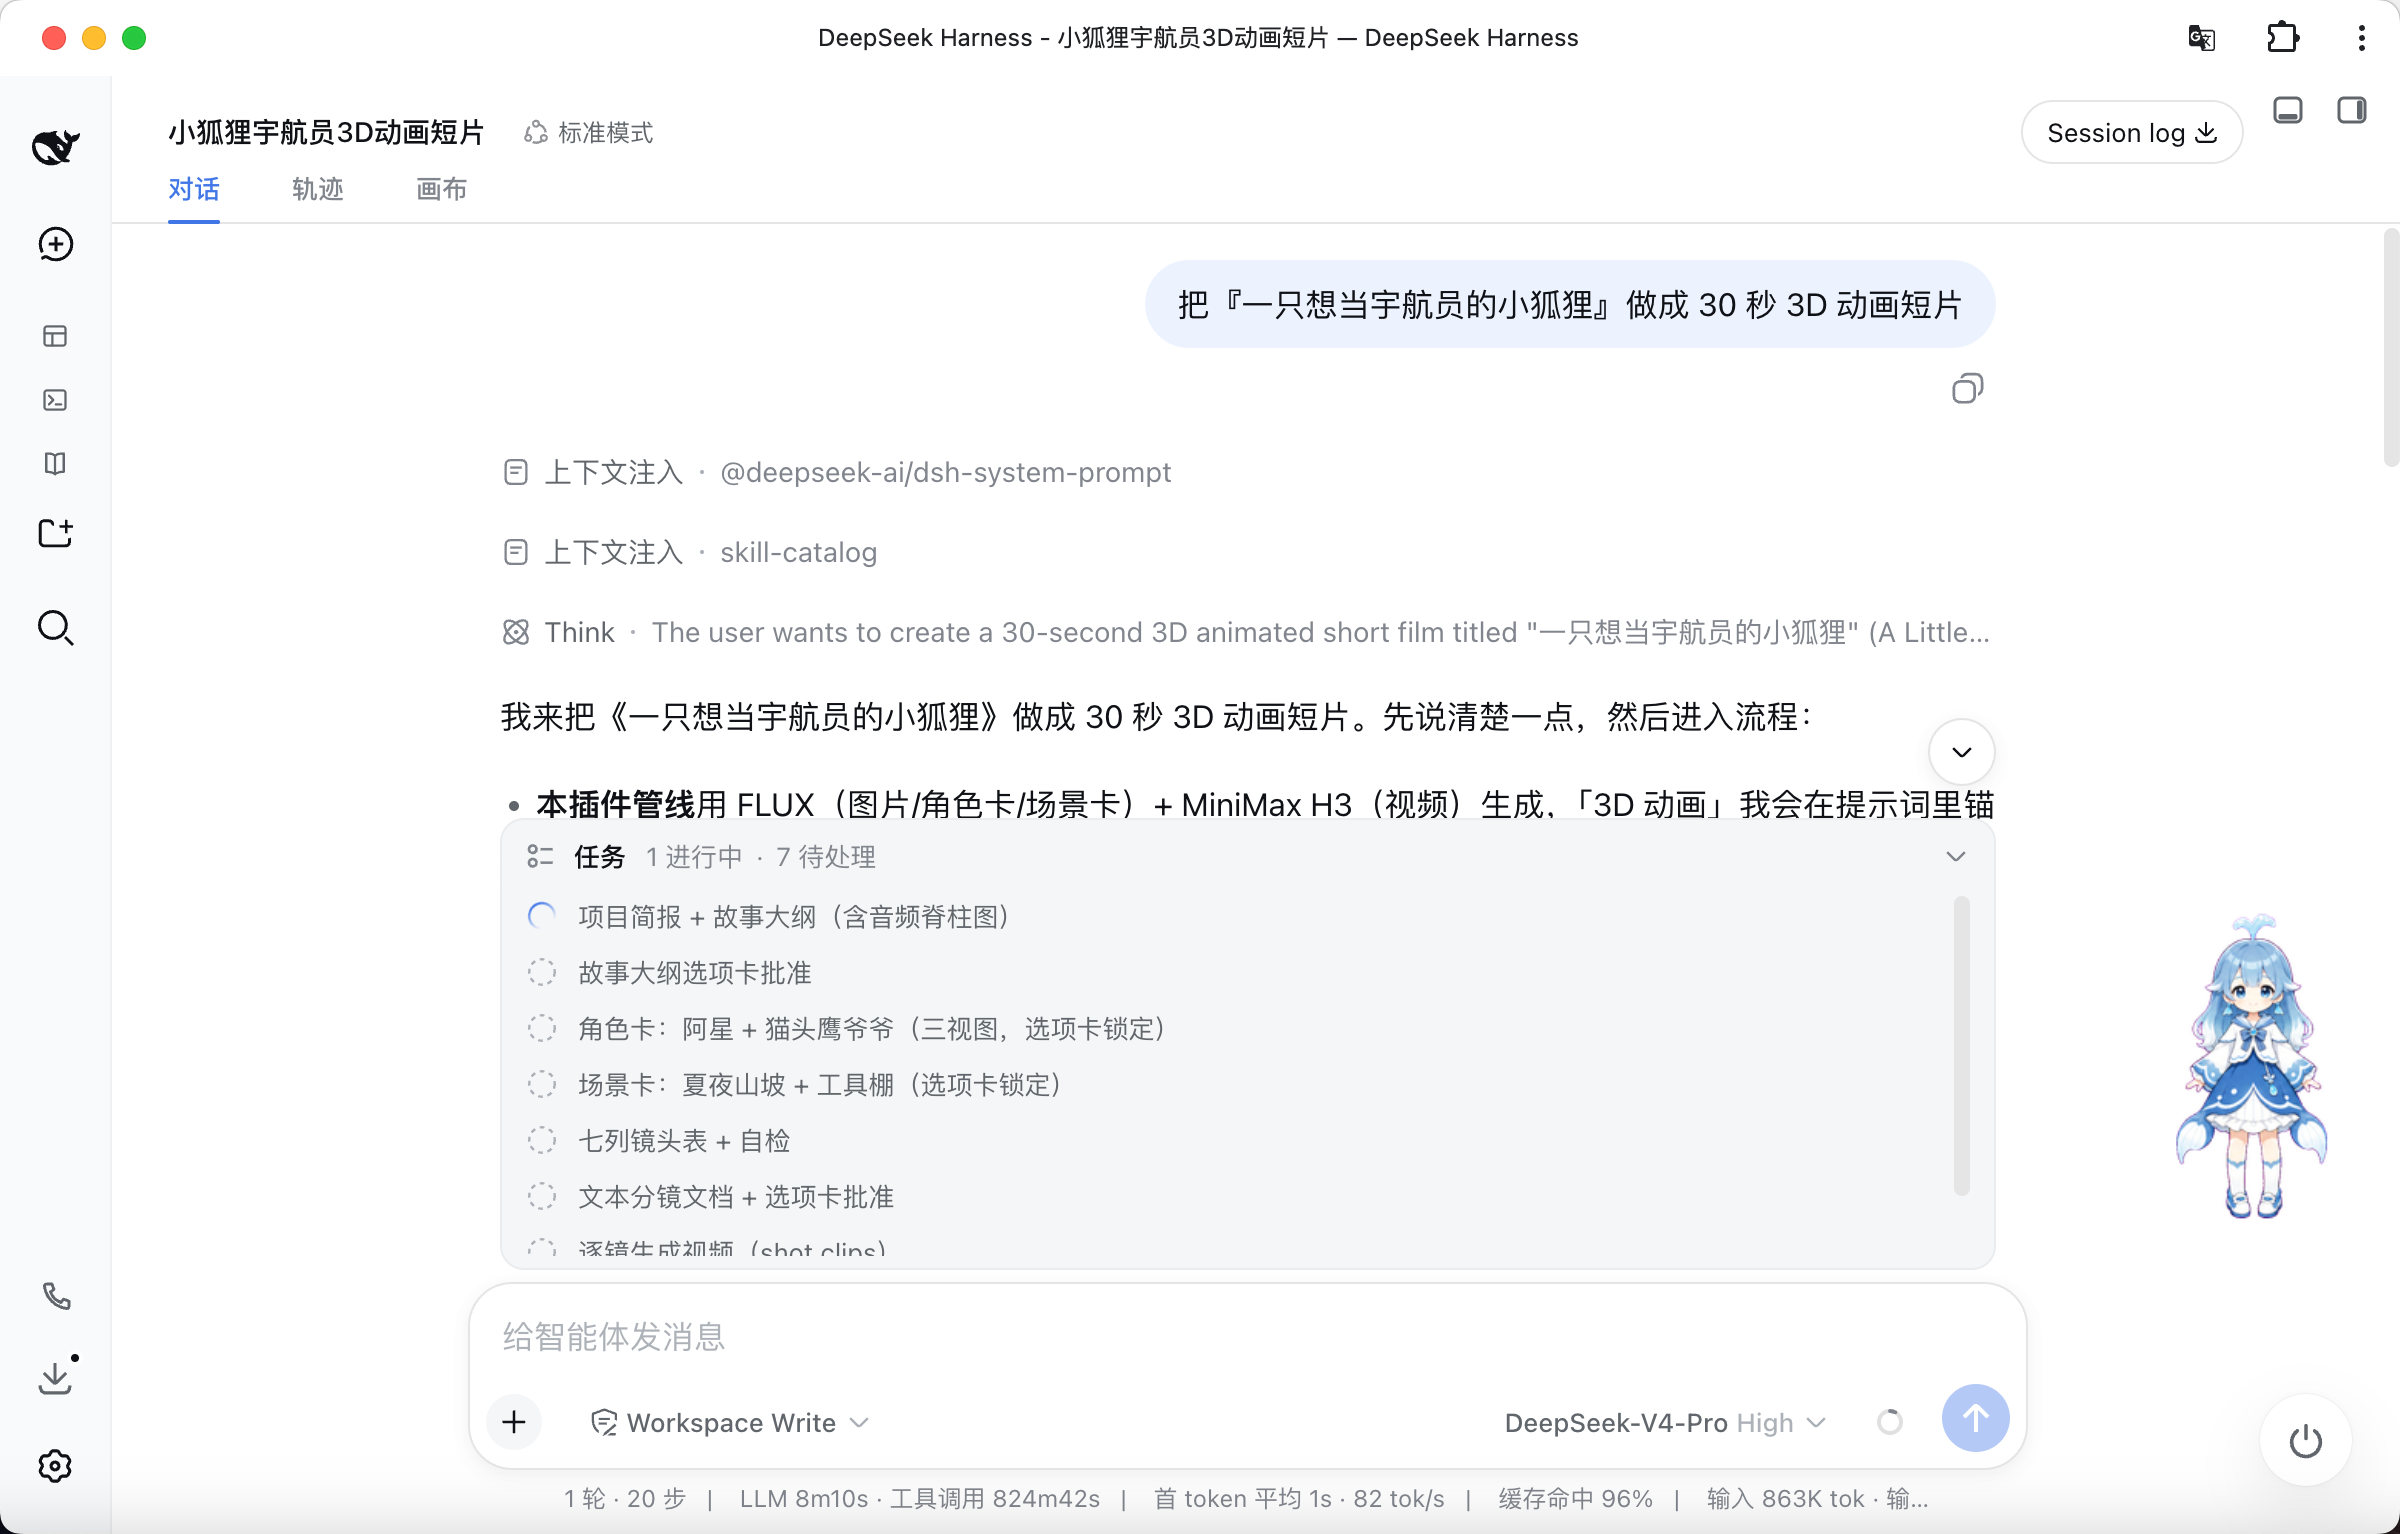
把「一只想当宇航员的小狐狸」做成 30 秒 3D 动画短片
Agent 会按 skill 定义的流程推进:项目简报 → 故事大纲 → 角色卡 → 场景卡 → 镜头表 → 分镜 → 逐镜生成 → 拼接合成,关键节点用选项卡确认。产品界面(真实会话截图):
| 对话体验:流程叙述 + 任务看板 | 对话体验:可视化画布 |
|---|---|
 |
 |
输入框生成条(真实 UI 截图)
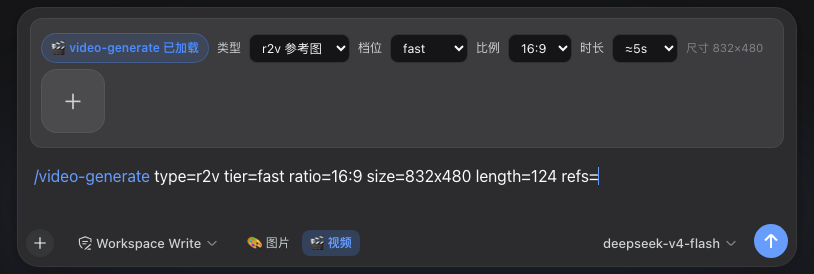
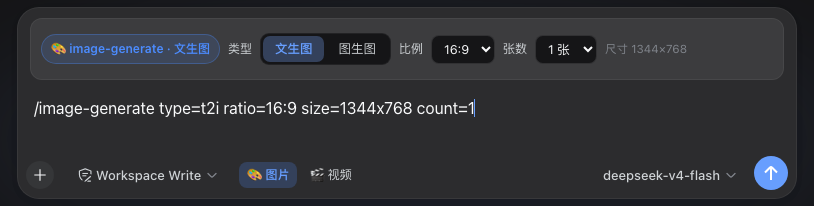
会话输入框工具行左端「🎨 图片 / 🎬 视频」开关,点开后即在官方输入卡内弹出紧凑参数条,命令头自动写入草稿首行、prompt 写在空行后,直接走 dsh 原生发送键提交(截图均为真实会话):
| 🎬 视频生成(r2v · 默认 fast 档) | 🎨 图片 · 文生图(t2i) | 🎨 图片 · 图生图(i2i · 参考图 chip) |
|---|---|---|
 |
 |
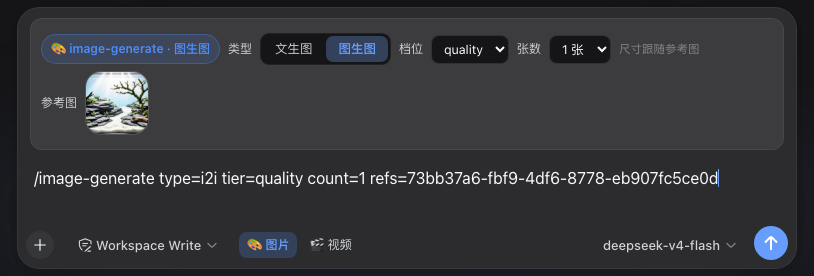 |
视频条:类型 r2v(参考图)/ i2v(首/末帧) · 档位 来自档位矩阵(能力有几个档、每档长边与耗时全部读注册表 —— UI 不预设档位数量与名称,默认取该能力首个可用档)——矩阵未加载时不猜档位,命令行也不拼 tier=(交给服务端按清单解析),并显示解析到的实现 id、加速标记与缺节点告警 · 比例 · 时长,参考图/首帧/末帧可上传画布节点。图片条:类型 文生图 / 图生图——t2i 选比例(1344 长边)+ 张数;i2i 传单张参考图(尺寸跟随参考图)、档位默认 quality、可出 1–4 张。
架构概览
完整设计文档见 docs/ARCHITECTURE.md 与 docs/workflow-contract.md。核心分层:
┌──────────────────────────────────────────────────────────────┐
│ 展示层(浏览器半)  lib/client.js + studio/                     │
│  「画布」会话 tab + 「ComfyUI」设置页(配置 / 注册表 / 导入)      │
├──────────────────────────────────────────────────────────────┤
│ 契约层(纯数据 + 校验)  workflows/*.json + lib/manifest.js      │
│  能力词汇表 · 注入原语 · $assets 占位 · $model 哨兵 · 强校验     │
├──────────────────────────────────────────────────────────────┤
│ 执行层(宿主半)  lib/index.js                                 │
│  ComfyUI 客户端 · 渲染编排 · 分辨率策略 · 注册表解析 · 画布存储  │
├──────────────────────────────────────────────────────────────┤
│ 集成层                                                        │
│  Agent 工具注册 · GUIDANCE · HTTP 路由 · skill 安装 · 渠道送达  │
└──────────────────────────────────────────────────────────────┘
设计主张:插件不认识「FLUX」「H3」这些名字,只认识能力(capability)与工作流清单(manifest,数据而非代码)——FLUX 2 / MiniMax H3 只是注册表里「恰好是默认」的两条记录,任何模型接入后享有同等地位。三层正交契约:
| 层 | 内容 | 载体 |
|---|---|---|
| ① 任务契约 | Agent 只描述「要什么」:capability + 类型化输入 | Agent 工具参数 |
| ② 能力契约 | 抽象作业词汇表:image.text2image / video.reference2video / video.upscale / audio.tts…(开放集合) |
CAPABILITIES |
| ③ 工作流绑定契约 | 一份清单 = 一个 capability → 一个 ComfyUI 图 + 注入点 + 资产 + 质量档(JSON 数据) | workflows/*.json |
清单里的 $assets.<key> 占位让「换模型文件只改配置」;["$model", 0] 哨兵让「按质量档插 LoRA 链」由编译期自动完成。注册表来源优先级:内置 workflows/ < 用户 ~/.dsh/dsh-short-video-studio/workflows/(同名遮蔽)< assetOverrides / 环境变量(换模型文件名,不动图结构)。
分辨率与画质(2K / 4K)
现在的方案可以做到 2K 与 4K 交付。 但要分清一件事:开源版 H3 的原生采样上限就是 768p(1344×768),往更高分辨率直接采样会出复制伪影——所以 1344×768 以上的每一个像素都是放大路线合成出来的。下面三条都是本机实测跑通的路径:
| 路线 | 能力 / 档位 | 机制 | 交付尺寸 | 代价(124 帧,本机 A800 实测) |
|---|---|---|---|---|
| 生成内两阶段(hires) | image2video / reference2video 的该档实现 |
首遍 896×512 解运动/构图/声音 → 视频 latent 插值 ×1.5 → 二遍重建 | 1344×768(把放大后的画面拉回原生 768p) | 分钟级 |
| 生成内学习式放大(>2K) | …-2k 族的档位实现 |
原生 1344×768 → 学习式 3D latent ×2 → 低 σ 精修 | 2688×1536(fast 档 1664×960) |
二遍精修在 ≈500k token 上超线性:620–2700s(分档) |
| 独立视频超分(U3) | video.upscale 能力 + video_upscale 工具 |
画布上已有视频 → 逐帧 CNN ×2 / ×4 → 收敛到交付尺寸 | 2K:2688×1536(原生 ×2) 4K 级:4032×2304(原生 ×4,或 2K 再 ×2) |
逐帧线性、最便宜:2K 155.7s(比生成内两阶段便宜 10.7×);4K 241.3s(原生 ×4)/ 261.6s(2K ×2) |
怎么选(产品口径):要让已生成的片段提分辨率,默认用 video_upscale(U3)——同交付尺寸下它比生成内两阶段便宜 6–10×,且在唯一「干净可比」的格子(2K、同网格、无二次缩放)里有效细节更高(有效宽 ×1.65 vs ×1.425)。生成内两阶段放大(U1)的价值在别处:能与链式续接叠用(链上流动的是首遍 latent,交付尺寸不参与续接),且放大后的 latent 还能被第二次采样消费——但不要再把它当成「上 2K 的手段」,那条路由已被 U3 取代。超分建议按分镜做、不要对成片做:分镜 ≤124 帧落在已验证的显存包线内,失败只毁一镜、可断点重跑。
诚实边界(必读):2K/4K 的像素尺寸是真的、容器元数据可验(MP4 vide 轨实测 2688×1536),但**「交付 2K」≠「细节等于 2K 渲染」。U3 是逐帧 CNN、没有跨帧先验,它造出来的高频不等于真实细节:实测 2K 交付的有效细节约 1.9K**,即比原生 1344 多约 1.4× 线性(面积 ≈2×)的真细节,但没到 2048、更远没到 2688。所以:倍数放大适合交付规格与观感,不适合「找回本来没有的细节」;两条 4K 路线哪个更好必须眼判(本机提供了 1:1 裁切对照图,见文档)。另外,极高分辨率下 h264 默认档会出现可见块效应,要更干净可先收敛到 4032 或分两步 ×2。
怎么用:超分不写提示词,输入是画布上的一个视频节点——
// 最便宜的真 2K:原生片段 ×2 → 2688×1536
video_upscale({ video_node: '<S01 画布视频节点 id>' })                 // 倍率取该实现的自然尺寸

// 4K 级:显式选 ×4 实现并收敛到 4032 宽(高度按比例、32 对齐)
video_upscale({ video_node: '<S01 节点 id>', workflow: 'video-upscale-x4', target_width: 4032 })

// 长素材:手动指定每块帧数(缺省按像素-帧预算自动分块)
video_upscale({ video_node: '<长片节点 id>', target_width: 4032, chunk_frames: 120 })
产物写回画布(kind: video),记 width/height/length/fps(拼接与续接的兼容性判据要用)、upscaleFrom(溯源)、factor/naturalWidth(倍率)与 assets(用了哪个权重);输出的音轨是原样带回的。生成内两阶段那条路则在配置页把某一档指向带放大的实现即可——不用改 prompt、不用改调用。
选型取舍的完整实测见 docs/video-upscale.md(U1 × U3 取舍、诚实边界、复现命令)、docs/learned-latent-upscale-2k.md(2K 有效性测量)与 docs/hires-two-pass-upscale.md(两阶段放大图结构)。
目录结构
├── lib/
│   ├── index.js          # 宿主半:ComfyUI 客户端、渲染编排、画布存储、路由、Agent 工具、GUIDANCE
│   ├── manifest.js       # 契约引擎:能力词汇、manifest 校验、图编译、注册表加载
│   ├── concat.js         # 视频拼接(ffmpeg 优先 / ComfyUI 纯节点退化)
│   ├── upscale.js        # 视频超分的纯逻辑(MP4 自解析探尺寸、两种尺寸来源的规划、分块决策与切片)
│   ├── convert.js        # ComfyUI「导出 API」JSON → workflow manifest 转换器
│   ├── assets.js         # 跨会话资产库(type=角色/场景/风格锚点/片段/文本 × kind=image/video/text)
│   ├── pdf.js            # 文本节点 → PDF(puppeteer-core 优先,CLI 兜底)
│   └── client.js         # 浏览器半:画布 tab + ComfyUI 设置页
├── studio/               # 画布页(自包含 HTML/CSS/JS,无构建)
├── workflows/            # 内置工作流清单(数据,非代码)
├── schemas/              # workflow-manifest 权威 JSON Schema
├── skills/               # 自带 skill(安装时复制到 ~/.dsh/skills/)
├── docs/                 # 架构 / 契约 / 实验报告
└── scripts/              # 冒烟 / e2e / 导入转换 / 模板生成(h3-templates → workflows)与实测(bench-h3)脚本
内置工作流清单(默认,可替换)
下表是插件随附的内置默认。导入你自己的清单后即可通过
preferred把它设为某能力的默认工作流——内置清单可以不用、可以遮蔽、可以删除。
| 清单 | 能力 | 说明 |
|---|---|---|
flux-text2image-{fast,balanced,quality} |
image.text2image |
FLUX 2 文生图(角色卡 / 场景卡 / 分镜图)。已分档(一档一清单,group=flux-text2image):长边 1024 / 1344 / 2048,步数 20 / 20 / 25 |
flux2-img2img-{fast,balanced,quality} |
image.image2image |
FLUX 2 参考图改绘(ReferenceLatent,尺寸跟随参考图)。已分档:参考图预算 0.5 / 1 / 2 MP,步数 8(+Turbo LoRA)/ 20 / 30 |
qwen-image-21-t2i-{fast,balanced,quality} |
image.text2image |
Qwen-Image 2.1 文生图(7B MMDiT:原生 2K、可出 RGBA 透明背景、中文提示词强)。图结构 = ComfyUI 官方模板 image_qwen_image_2_1_t2i:UNETLoader → TextEncodeQwenImage21 → KSampler(euler/simple, cfg=1) → VAEDecode,latent 由 EmptyLatentImage 给 ⇒ 任意画幅(含 9:16)。已分档(一档一清单,group=qwen-image-21-t2i):长边 1024 / 1344 / 2048,步数 20 / 30 / 40(官方 pipeline 40–50 步,官方模板从 25 步起)。前置:ComfyUI ≥ v0.37.0(TextEncodeQwenImage21 是 0.37 起的新节点)+ 三个权重(assets:qwen_image_2.1_int8_convrot / qwen3vl_8b_int8_convrot / qwen_image_2.1_vae_bf16,共 ≈16.1 GiB)。requiresNodes 预检会让旧版 ComfyUI 显式显示「缺节点」而不是跑失败 |
qwen-image-21-i2i-{fast,balanced,quality} |
image.image2image |
Qwen-Image 2.1 参考图改绘(换装 / 改背景 / 风格迁移 / 构图微调)。参考图同时进文本编码器的视觉塔与 VAE 潜空间(reference_latents),输出尺寸跟随第一张参考图(与 flux2-img2img 同口径,显式 width/height 不参与)。ref_nodes 最多 10 张(prompt 里用 <image1>…<image10> 指代,image_1 是编辑目标)——槽位名是 images.image_1…image_16(1 起),故清单里用内嵌算术 "images.image_${i+1}" 映射 0 起的 refs 下标。参考图重采样预算按档注入(reference_pixels:fast 768 / balanced 1056 / quality 2048 ⇒ quality 档可出 2K 改绘);1056 一档是规避官方起步值 0 与 1024/1536 网格上锐化噪点/指令失效的已知 issue(ComfyUI #16435,未修复),512 与 1056 干净。QwenImage21Cache(dtype=int8) 把「文本+参考图前缀」的 KV cache 减半。同样已分档(长边由参考图决定,步数 20 / 30 / 40);前置同上一行 + QwenImage21Cache。权重现在只有 int8_convrot 一份 ⇒ 服务端 comfy-kitchen 版本必须与 ComfyUI 对齐(旧 kernel 会在首个采样步报 int8_linear() got an unexpected keyword argument 'input_act_weight') |
minimax-h3-ref2v-fast · -balanced · -balanced-sol · -quality · -quality-sol |
video.reference2video |
组「MiniMax H3 参考生成视频」:H3 参考绑定,ref_nodes 绑定身份/环境,带声音。一个 json = 一个档位实现;fast 长边 832,balanced/quality 长边 1344 |
minimax-h3-i2v-fast · -balanced · -balanced-sol · -quality · -quality-sol |
video.image2video |
组「MiniMax H3 首末帧生成视频」:H3 首/末帧串联(同场景续接镜 / 转场镜),带声音,base = FL2VA 变体。一个 json = 一个档位实现;fast 长边 832,balanced/quality 长边 1344(balanced = 8 步 + fl2v 768p LoRA,shift 6/3) |
minimax-h3-ref2v-ctx-fast · -balanced · -balanced-pdd · -quality |
video.reference2video |
组「MiniMax H3 参考视频·链式续接」:与同档标准实现同一批权重,只多挂 Motion Context 四节点 ⇒ 传 continuity_from 时继承上一镜尾部(22 帧画面 + 1.000s 音频),采样多 22 帧后裁掉。priority: -100:只被「续接路径」(传 continuity_from)选中,或由配置面 pins 钉选;不做隐式默认 |
minimax-h3-i2v-ctx-fast · -balanced · -balanced-pdd · -quality |
video.image2video |
组「MiniMax H3 首末帧·链式续接」:i2v 版链式实现(模板由 scripts/make-h3-ctx-templates.mjs 从普通 i2v 模板派生)。实测行为:链式 i2v 里 first_frame_node 会被丢弃(钉住的 head 已决定开头约 22 帧)、last_frame_node 保留 ⇒ 转场镜「续接上一场景尾镜 + 末帧锚定下一场景首镜」是当前最优解。同样 priority: -100 |
minimax-h3-ref2v-balanced-pdd · -balanced-pdd-sol |
video.reference2video |
PDD 8 步蒸馏(nfe=8):8 步拿到成片档以上细节(ref2v 184.7s / 叠 Sol 137.3s)。就是普通清单,归在同一家族组里;不做隐式默认(priority<0,依赖第三方节点),要在配置页「新增策略」里组合并自己命名 |
minimax-h3-i2v-balanced-pdd · -balanced-pdd-sol |
video.image2video |
同上(FL2VA 权重,base 必须 fl2va)。i2v 侧 178.8s / 叠 Sol 134.1s,定位是成片档的廉价替代(392.4s → 178.8s) |
minimax-h3-ref2v-hires |
video.reference2video |
组「两阶段放大」:开源版 H3 原生上限就是 768p(1344×768),往更高直接采样会出复制伪影 ⇒ 首遍 896×512 解运动/构图/声音 → 视频 latent ×1.5 → 二遍 denoise 0.35 重建细节,交付 1344×768 带声音(音频 latent 全程未被放大、二遍不进音频分支)。图分辨率被 resolutionLock 锁死:显式 width/height 与画布比例都不生效,并带 warning 如实说明。只提供 quality 档、priority: -50(不做隐式默认),要在配置页「新增策略」里显式选中。详见 docs/hires-two-pass-upscale.md |
minimax-h3-i2v-hires |
video.image2video |
同上(走 FL2VA 权重)。模板由 scripts/make-hires-template.mjs 从 ref2v/i2v 两个 base 各自派生,两阶段尾段逐字节一致 |
minimax-h3-{ref2v,i2v}-ctx-{quality,balanced-pdd,fast}-2k |
video.reference2video / video.image2video |
组「链式续接 + 学习式放大(>2K)」:ctx 图 + 学习式 latent ×2 放大器(minimax_h3_latent_upscaler_3d_conv_v1_bf16)+ denoise 0.3 精修,交付 2688×1536 带声音(fast 档 1664×960 —— 各档保留自己的首遍尺寸:quality/pdd 首遍 1344×768、fast 首遍 832×480)。关键结论:放大发生在链式存档之后(MiniMaxH3MotionContextSaveLatent 读的是首遍采样器输出)⇒ 交付尺寸不参与续接,同一条链内只要首遍尺寸一致就能续——甚至能和「非放大」的同档实现互接;首遍不同则显式拒跑。priority: -60(不做隐式默认)、三档各有自己的清单:fast 首遍 832×480 → 交付 1664×960、balanced-pdd 与 quality 首遍 1344×768 → 交付 2688×1536(本族唯一的非 2688 交付是 fast)。每份清单都带 aspectRatios: ["16:9"] + maxDurationFrames: 124(精修在 ≈500k token 上超线性,不支持竖版 / 长片)。实测(fast 档 56 帧):起链 114.0s / 续接 246.3s;接缝画面差 13.33 vs 同实现不续接 79.57,响度台阶 +0.68 dB vs −6.34 dB。有效分辨率(自校准频谱):2688 网格 ≈1949px。模板 scripts/make-2k-template.mjs 从 ctx base 派生,见 docs/shot-chain-continuity.md 附 F |
video-upscale-x2 · video-upscale-x4 |
video.upscale |
视频超分(像素空间,U3):输入是画布上已有的视频节点(不是提示词),逐帧 CNN ×2 / ×4,音轨原样带回(全程不经过模型)。交付尺寸 = 源尺寸 × 倍率,可用 target_width 收敛(按 32 对齐);比例永远跟源片——H3 族是 1.75:1,所以 4032 宽对应 4032×2304(不是 16:9 的 3840×2160)。逐帧独立 ⇒ 代价线性、天然可分块(超预算的长片按 ImageFromBatch + TrimAudioDuration 切块再拼回,不需要 ffmpeg)。实测 124 帧:原生 →×4→ 4032 241.3s;U1 的 2K →×2→ 4032 261.6s;U1 的 2K →×2→ 5376 317.5s;248 帧 5376 一次过 551.4s(无 OOM)。工具入口 video_upscale;模型走资产槽 upscale_x2/upscale_x4(换权重必须换成同倍率的);x4 priority: -10 需显式选中。有效分辨率(自校准尺子,同时看闪烁与平坦区锐度才敢下判断):同网格 + 无二次缩放的「原生→×2→2688」读到 ×1.65,优于 U1 单独 2K 的 ×1.45,而耗时只有 1/10.7;4032 上两臂读数接近(×1.96 / ×1.67),但原生×4 那臂平坦区锐度 362 vs 197(输入 68)提示过锐/振铃,所以那一格的读数不能当作"细节更多"。眼判对照图见 e2e-out/4k/compare-4arms-1to1.png。详见 docs/video-upscale.md |
extract-frame |
image.from_video |
抽帧(末帧 / 首帧 → 图片节点) |
minimax-h3-ref2v-sol-stats |
video.reference2video |
内部诊断清单(internal: true):跑 Sol 时输出统计用于复核。不参与档位解析、不进 UI 与技能选项,只能由配置面 pins 钉选(工具面不接受 workflow=) |
档位(tier)与加速策略
- 视频形状
type必填:comfy_generate_video(type='r2v', …)(参考绑定,配ref_nodes)或type='i2v'(首末帧串联,配first_frame_node)。形状与参数冲突直接报错并给修法(此前是静默丢弃参数);形状与续接(continuity_from)正交,详见docs/video-shape-contract.md。 - 产品层档位是受控三档
fast/balanced/quality,图片与视频同一套(长边按能力不同:图片 1024 / 1344 / 2048,视频 832 / 1344 / 1344)。呼叫comfy_generate_image(tier=…)/comfy_generate_video(tier=…)/comfy_render(tier=…)。缺省是quality—— 成本最高(图片 2048 档单张约 45s 量级),抽卡迭代建议显式传tier=fast(~4s)或balanced。 - 工具面不接受
workflow=:实现由配置决定(preferred家族序 /tiers档位选择 /pins钉实现,设置页可改);传workflow=会报错并指路。comfy_list_workflows主输出只给「能力 → 档位(可用性 / 交付尺寸 / 耗时)」,实现 id 收在诊断字段里。 - 请求了不存在的档位不会静默换档:如 i2v 请求
tier=balanced→ 工具显式报错并列出可用档位,改请求可用档位即可(不要原样重试)。 - 分辨率读清单(长边)+ 画布比例推导:
fast长边 832、balanced/quality长边 1344;工具条会显式传size=WxH(显式优先)。长边由清单声明,UI 不按档位名硬编码。 resolutionLock:有些实现的尺寸不能被调用方改写。两阶段放大类清单(…-hires/…-2k)的首遍尺寸是图结构的一部分(放大倍率写死在节点上),所以它们声明resolutionLock: { graph, scale }:显式width/height与画布aspectRatio都不生效,交付尺寸 =graph × scale,并且一定带一条warnings如实说明尺寸被改写。这不是"忽略参数",是清单在保护自己的底片——从错的尺寸起放大,交付尺寸会与调用方以为的静默不一致。校验node scripts/smoke-hires-lock.mjs;契约见docs/tier-strategy-design.md§2、docs/hires-two-pass-upscale.md。video.upscale是另一条尺寸语义:超分不进采样器、不占 H3 的 token,尺寸跟着输入视频走,所以它必须声明尺寸来源(upscale.sizing+factor/shortSide)且不得声明resolutionLock(两者互斥,校验器会拒)。尺寸来源两种形态:sizing='factor'(交付 = 源 × 倍率,像素空间 CNN;target_width只是事后收敛)与sizing='short-side'(交付由实现的目标短边推导,扩散/恢复类模型用;此时不得再声明factor,且必须声明params.out_short_side让 runner 把短边回注实现——target_width因此变成「让模型按目标渲染」而不是先渲染再降采样)。另有一个维度upscale.chunking:caller(缺省,逐帧独立 ⇒ runner 可按像素-帧预算自动分块)或internal(自带跨帧时间先验 ⇒ 外层不切,显存交给实现自己管)。想要固定比例/尺寸的生成用生成类能力,想给已有片段提分辨率用video.upscale。- 策略与档位的关系:策略就是把「哪些档用哪份清单」存成一套并起个名;点选后写入配置
tiers(快照语义)。策略声明了它提供哪些档位——只挑了 balanced 的策略就没有 fast/quality,工具条不显示、请求会显式报错。设置页默认只列策略与名称,档位表单点该策略的「编辑档位」才展开:内置默认那条=把逐档实现一次配齐(保存为逐档显式选择),自建策略=就地改它的档位快照。两者都随时可改,技能侧始终只传tier。 - 链式续接(
continuity_from)怎么用:同场景后续镜传continuity_from=上一镜的视频节点 id;该镜必须用声明了chain的实现渲染(各能力的…-ctx-*清单,或由配置面pins指到它们)——上一镜没有链式序号时会显式报错,不会悄悄退化成"另起一镜"。硬约束:① 一条链内首遍尺寸必须一致(= 采样器实际跑的尺寸,不是交付尺寸——链上传递的是首遍 latent,latent 不能缩放;交付尺寸可以不同,所以放大档与同首遍的非放大档能互接,首遍不同则显式报错);② 首镜(起链)也得用链式实现,否则下一镜接不上;③length填交付帧数(续接实现自己多采 22 帧再裁掉);④ 跨场景不要续接,直接换镜。成本:续接镜比同档标准实现慢约 1.3–1.5×(i2vfast实测 40.4s vs 30.5s,多采 22 帧 + 多一组上下文 conditioning)。 - 加速不暴露到产品层:设置页每个能力默认只放一条内置默认策略(跟随注册表首选 = 各档非加速首选实现)。技能与文档只写
tier,不写加速实现 id 或节点名。 - 策略由你自己命名与组合:点「+ 新增策略(命名 + 逐档组合)」→ 起名 + 逐档从现有清单里挑(可按家族跨清单组合,例如 balanced 用 PDD+Sol、quality 用标准),保存即选用;之后可重命名/删除。只挑一个或两个档位也行(≥1 即可)——没挑的档位不属于这条策略:配置页的策略行与工具条档位下拉都会跟着收敛(没这个档位就连行都不显示),显式请求那个档位会报错(不会回退到别的实现),不写档位时则按这条策略提供的最靠前那档走(并给提示)——所以「只把 balanced 换成 PDD」得到的是一条"只有 balanced"的策略,想三档都能出就用策略行的「编辑档位」把三档都挑上。Sol / PDD 都只是可选清单,不会被自动包装成"官方策略"。逐档下拉也随时可用(不保存为策略时显示为「自定义」)。
- ⚠️ Sol 清单需自装第三方节点 ComfyUI-SolAttn-Ampere(注册名
SolAttnMiniMaxH3,没装会报 node type not found);缺节点时该实现置灰不可用(不静默回退到标准实现)。 - 同 seed 关/开对照实测:成片档 20 步 768p 收益最大——ref2v 396.6s→311.2s(1.27×)、i2v 394.8s→314.7s(1.25×),高频细节持平(±2.5%);
balanced8 步 166.3s→136.3s(1.23×);480p / fast 档只有 1.03× 且高频细节 −13.8%,不要开。⚠️ 本插件栈必须dense_first_percent: 0(默认 0.2 会让节点把每次调用判为"去噪早期"而完全不稀疏);诊断清单可复核sol_attn>0。⚠️ 同 seed 不再复现同像素(注意力内核换了,即使不稀疏也差 15.1/255)→ 一部片子里要一致地全用或全不用,不能逐镜混用。由node scripts/make-h3-variants.mjs从scripts/h3-templates/生成,详见docs/minimax-h3-acceleration-lora.md§9.8 与docs/tier-strategy-design.md。
- ⚠️ Sol 清单需自装第三方节点 ComfyUI-SolAttn-Ampere(注册名
实测耗时(16:9 · 124 帧 ≈ 5.17s)
| 能力 | fast |
balanced |
balanced 带加速 |
quality |
quality 带加速 |
|---|---|---|---|---|---|
| ref2v(832×480 / 1344×768) | 24.6s | 166.3s | 136.3s | 396.6s | 311.2s |
| i2v(832×480 / 1344×768) | 26.1s | 177.3s | 130.5s | 394.8s | 314.7s |
耗时随硬件、驱动、模型文件版本而变,上表只作量级参考(决定选哪一档、加速值不值得开)。
续接镜(…-ctx-*):同一档位下比标准实现慢约 1.3–1.5×(多采 22 帧 + 一组 Motion Context 条件)。i2v fast 实测:起链 36.4s / 续接 40.4s(同档标准 i2v fast 对照 30.5s)。
PDD 清单(长边 1344,需自己在设置页组进策略):ref2v 184.7s / 叠加 Sol 137.3s;i2v 178.8s / 叠加 Sol 134.1s。同条件下的 20 步成片档为 394.4s / 392.4s(PDD 的锐度还高 +10.3% / +7.9%)→ PDD 相当于用 8 步的钱买 20 步的画质。
画质:balanced(8 步)帧锐度比 quality(20 步)高约 13%;fast 档细节最弱、适合调构图 / 走位;PDD 8 步则高于成片档。
⚠️ 版本兼容(v0.1.x → 现在):组
minimax-h3-i2v(拆分后是多份单档清单,见上表)的 base 已从minimax_h3_ref2va_pruned_int8_convrot换成minimax_h3_fl2va_pruned_int8_convrot(+21GB 下载),LoRA 换成minimax_h3_fl2v_lightx2v_turbo_4step_v0.1_comfy(+2GB)。原因是原先 i2v 用 Ref2VA base 跑MiniMaxH3ImageToVideo属跨变体错配(拿不到 fl2v 系迭代红利)。这两个资产现在由独立配置键驱动(models.h3FlUnet/models.h3FlFastLora,或 envDSH_SVS_H3_MODEL_FL/DSH_SVS_H3_LORA_FL_FAST)——旧键h3RefUnet/h3FastLora只作用于 ref2v 档,不再被 i2v 复用。若不想多下 21GB,用配置把它按旧组合钉回去即可(i2v 会退回旧行为):"assetOverrides": { "minimax-h3-i2v-quality": { "unet": "minimax_h3_ref2va_pruned_int8_convrot.safetensors", "fast_lora": "minimax_h3_ref2v_turbo_4step_v0.1_comfyui_bf16.safetensors" } }旧 id 的配置无需改写(P2 迁移已内置):
assetOverrides按族继承——新 id 会同时读旧 id 的覆盖(minimax-h3-ref2v-*继承minimax-h3-ref2v,*-balanced*额外继承minimax-h3-ref2v-8step,minimax-h3-i2v-*继承minimax-h3-i2v),且精确匹配新 id 的覆盖优先级更高;旧models.*键也按族映射到各档清单。所以你不必逐档重写配置。⚠️ LoRA 与 shift 必须配对(硬约束):544p 系 LoRA(
ref2v/fl2v 4step v0.1)= shift 12/3;768p 系 LoRA(*_8step_v1.0_768p、fl2v v1.1/v1.2 768p)= shift 6/3,且分辨率必须进 768p 训练域(本插件用 1344×768)。错配不是"略糊"而是结构性崩坏。shift 写在清单graph里(modes不支持按档改标量),所以换档位 pairing 的正确做法是加一份新清单。
Agent 工具契约
| 组 | 工具 |
|---|---|
| 生成 | comfy_generate_image · comfy_generate_video · comfy_render(通用入口,模型无关)· comfy_list_workflows(查能力/工作流) |
| 后处理 | extract_frame(抽帧)· video_concat(拼接成片)· video_upscale(超分:画布视频节点 → 像素空间 ×2/×4,可换模型与工作流) |
| 画布 | canvas_list_nodes · canvas_write_node · canvas_get_node · canvas_group_nodes · canvas_reorder · canvas_get_state · canvas_set_state |
| 资产 | asset_list(列出跨会话资产,含 kind)· asset_to_canvas(物化回画布:图片/视频→媒体节点,文本→text/table 节点) |
全部工具模型无关:capability 由注册表
preferred解析到具体工作流,prompt 与流程里不硬编码模型名。
扩展:开发你自己的场景 skill
适配场景:插件默认内置两种场景 skill——3D 动画短片(故事创意 → 角色/场景/镜头/分镜/逐镜/合成)与品牌宣传短片(品牌素材 → 事实核验/创意方向/镜头表/逐镜/合成)。但场景不是插件边界——任何「输入 X → 产出视频内容」的创作场景,都能通过扩展 skill 覆盖,复用同一套执行层工具(生成 / 画布 / 资产 / 拼接 / 飞书交付),只换编排规则:
更多「设计、媒体与视觉」插件
modlens
作者 liustack
The first vision plugin for DeepSeek Harness, and the vision bridge for every text-only coding agent. Paste an image, get structured JSON evidence (OCR, layout, semantics). | 全网最强 DeepSeek Harness 外挂视觉插件,为 DeepSeek、GLM 等纯文本模型外挂视觉能力,粘贴图片即得结构化 JSON 证据(OCR、版面、语义)。
agent-vision-toolkit
作者 anionex
为纯文本模型"看图“设计更好的视觉工具箱和技能,支持多图理解,图片问答,前端UI还原、GUI 自动化等,并可选无缝接入多个主流agent,直接识别粘贴图片| A vision toolkit and skill designed for text-only llms — image Q&A, long-screenshot OCR, frontend UI restoration, and GUI automation, with optional seamless integration for Codex, Claude Code, Pi, Oh My Pi, and OpenCode
dsh-vision-router
作者 ysr666
为纯文本 DeepSeek Harness 智能体提供「视觉」能力,内置免密钥视觉链路与像素级视觉工具,一条命令安装,无需 Python。
dsh-vision-toolkit
作者 anionex
[dsh]为纯文本模型设计更强大的视觉工具箱:一行安装使用、粘贴图片直接识别、多张图片问答、截图到前端UI 还原等|DeepSeek Harness-native integration for agent-vision-toolkit: image Q&A, long-screenshot OCR, UI restoration, grounding, pixel diff, Artifacts, and Web UI.