DeepSeek Harness 项目实战:从需求到交付做完一个真实项目
完整还原一次 dsh 真实项目开发:新建工作区、需求拷问、PRD、任务拆分、TDD 开发,直到代码推上 GitHub,每一步都有真机截图。
最近更新: 2026-09-16
装好 DeepSeek Harness 之后,大家最关心的其实不是它有什么功能,而是它能不能真正拿来干活。这篇攻略完整还原了一次真实项目:从一句「做一个命令行待办清单」,到拷问需求、落 PRD、拆任务、TDD 开发,最后代码合进 GitHub——全程没打开过一行编辑器。
下面的 8 个步骤与源视频的画面一一对应,命令和文件名都以视频里实际出现的为准(CONTEXT.md、ADR、todo-cli-v1.md……)。每张截图都能点回源视频对应的秒数,建议先通读一遍再照着做。
从需求到交付的 8 个步骤
- 1
新建工作区,先做工程初始化配置
项目开始前先新建一个工作区,然后让 Agent 把工程底座搭好:本地用 git 维护、远程推到 GitHub、issue 跟踪约定写进 AGENTS.md 和 docs/agents/。它每一步调了什么工具,「轨迹」面板里都能查到——这也是后面出了问题能回溯的底气。
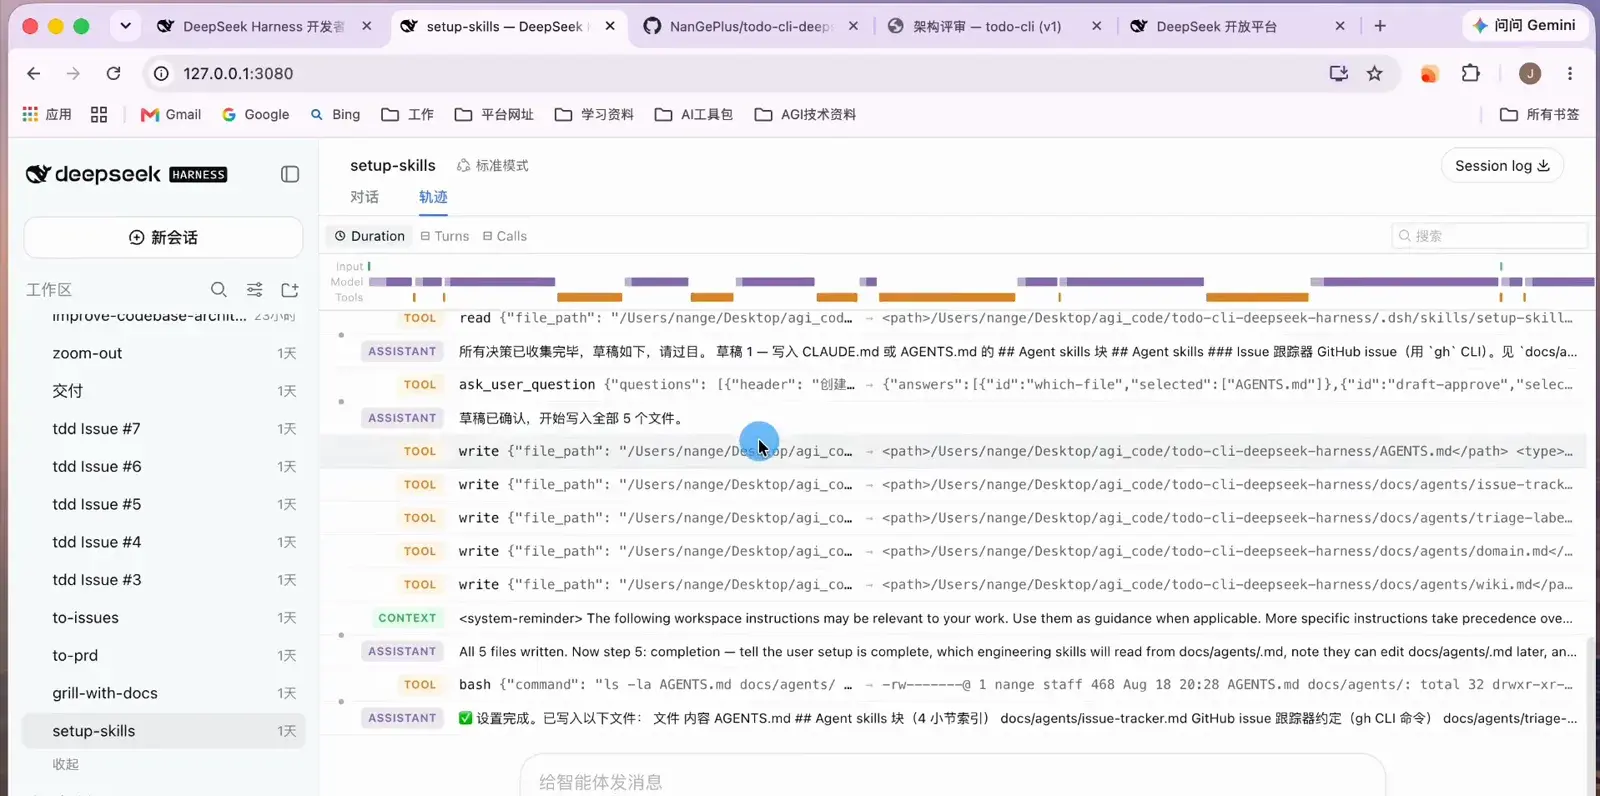
轨迹面板把初始化会话的每次工具调用都摊开给你看。跳到视频 2:46 处 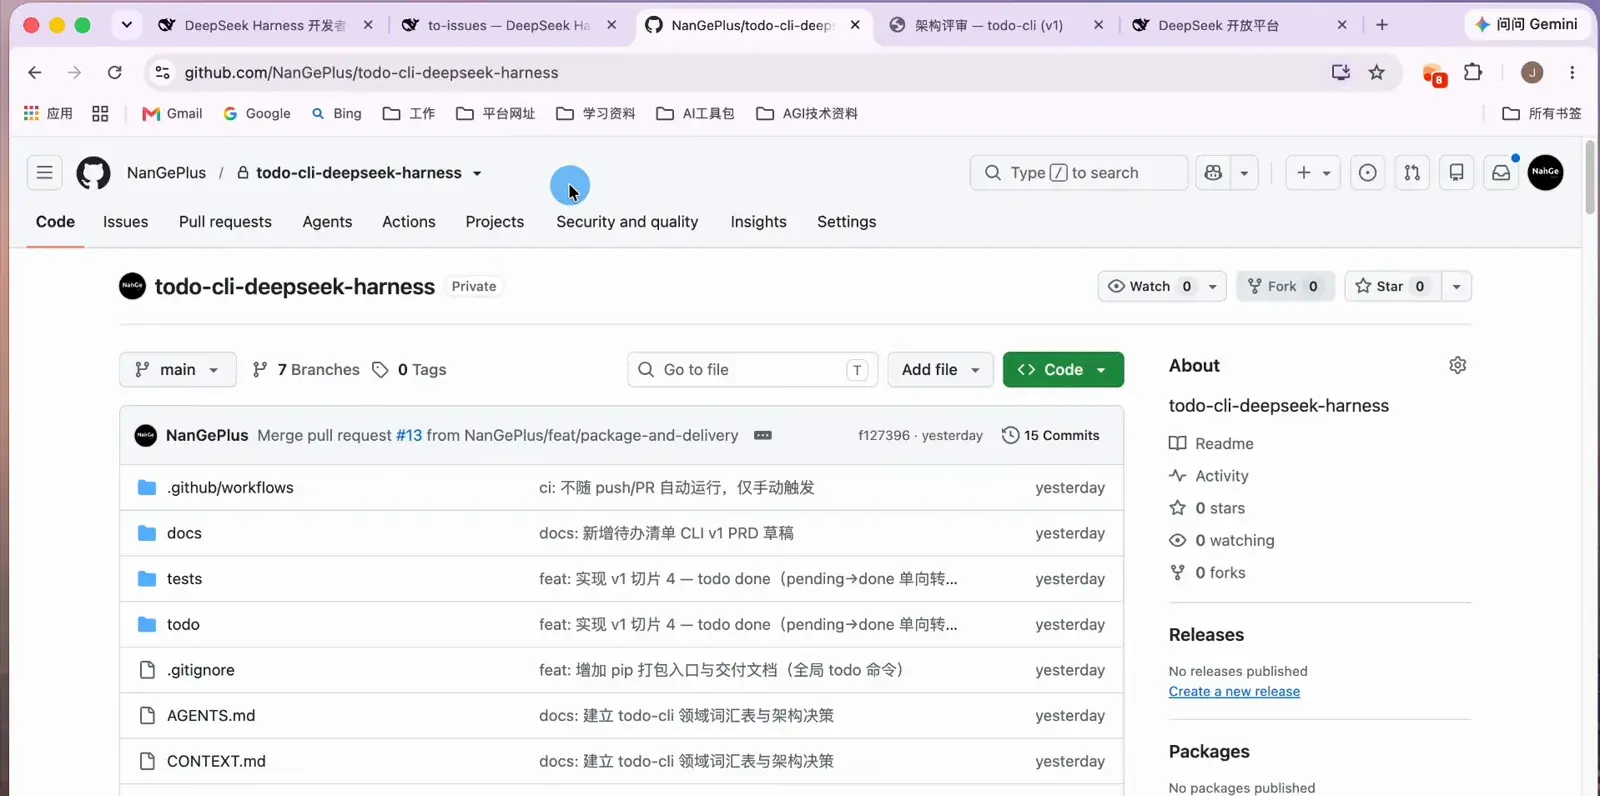
从第一天起,全部工程代码就住在 GitHub 仓库里。跳到视频 5:42 处 - 2
在设置里接上大模型
打开「设置 → 模型」,把在 DeepSeek 开放平台申请的 API Key 贴进去,点保存就能用。想用别的模型也行:同一个页面支持添加其他模型和自定义提供方,后面整个流程不锁任何一家。
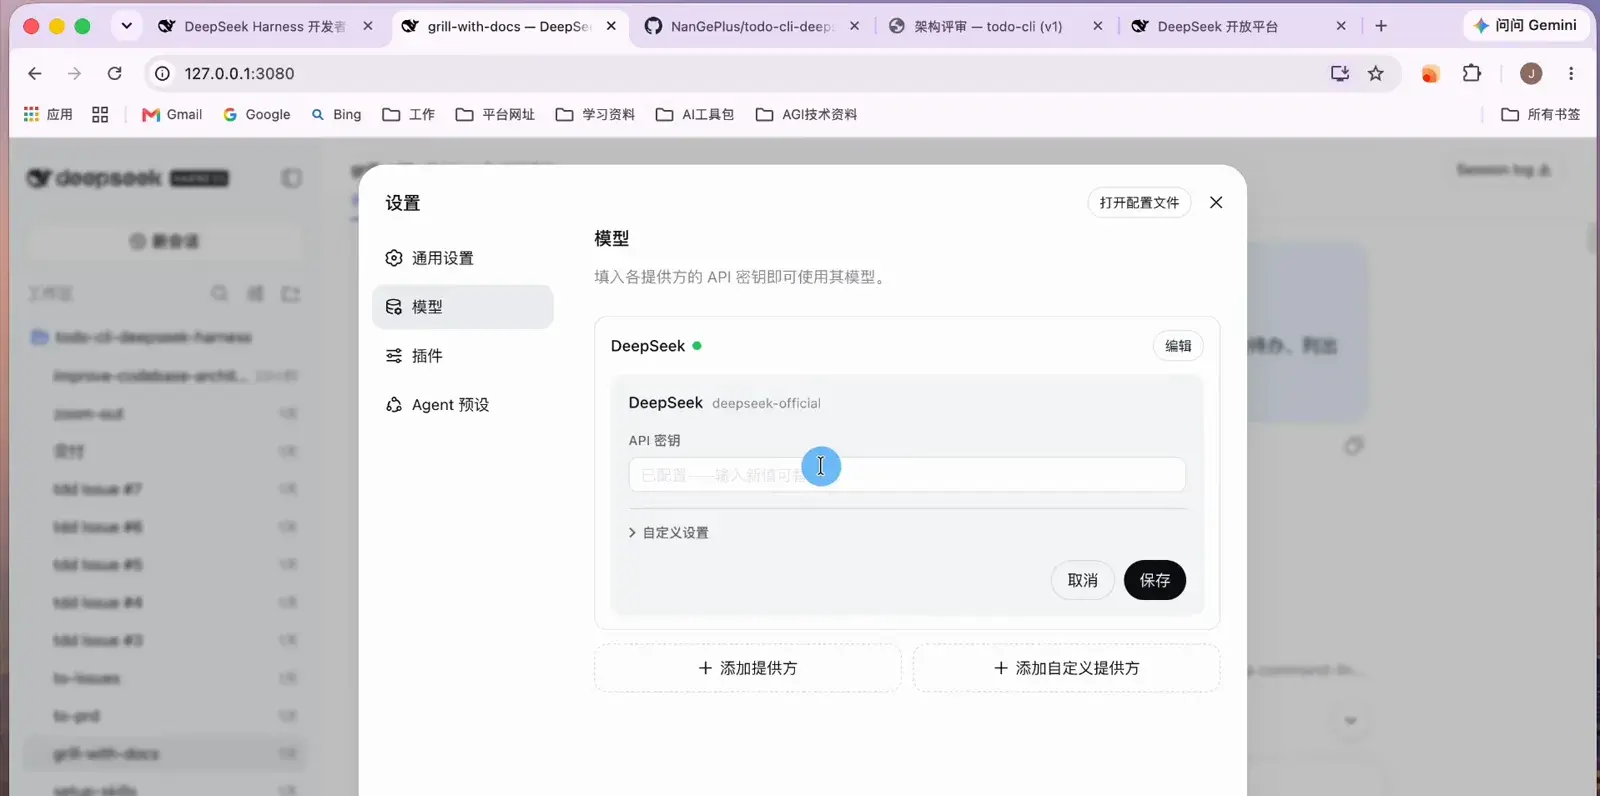
设置里贴一个 Key,项目就能开跑。跳到视频 1:02 处 - 3
写下需求,让 Agent 拷问到方案清晰
用 /grill-with-docs 这个 skill 开场,需求一句话就够:从零做一个 todo 命令行工具,v1 只做添加、列出、标记完成,数据存本地 JSON,「请拷问我,直到方案清晰」。Agent 会从领域规格、技术规格、UI 规格三个方面轮番盘问,你答得越实在,后面的返工越少。
$我想从零做一个命令行待办清单 todo-cli,v1 只要:添加待办、列出待办、标记完成。数据先存在本地 JSON 文件。请拷问我直到方案清晰。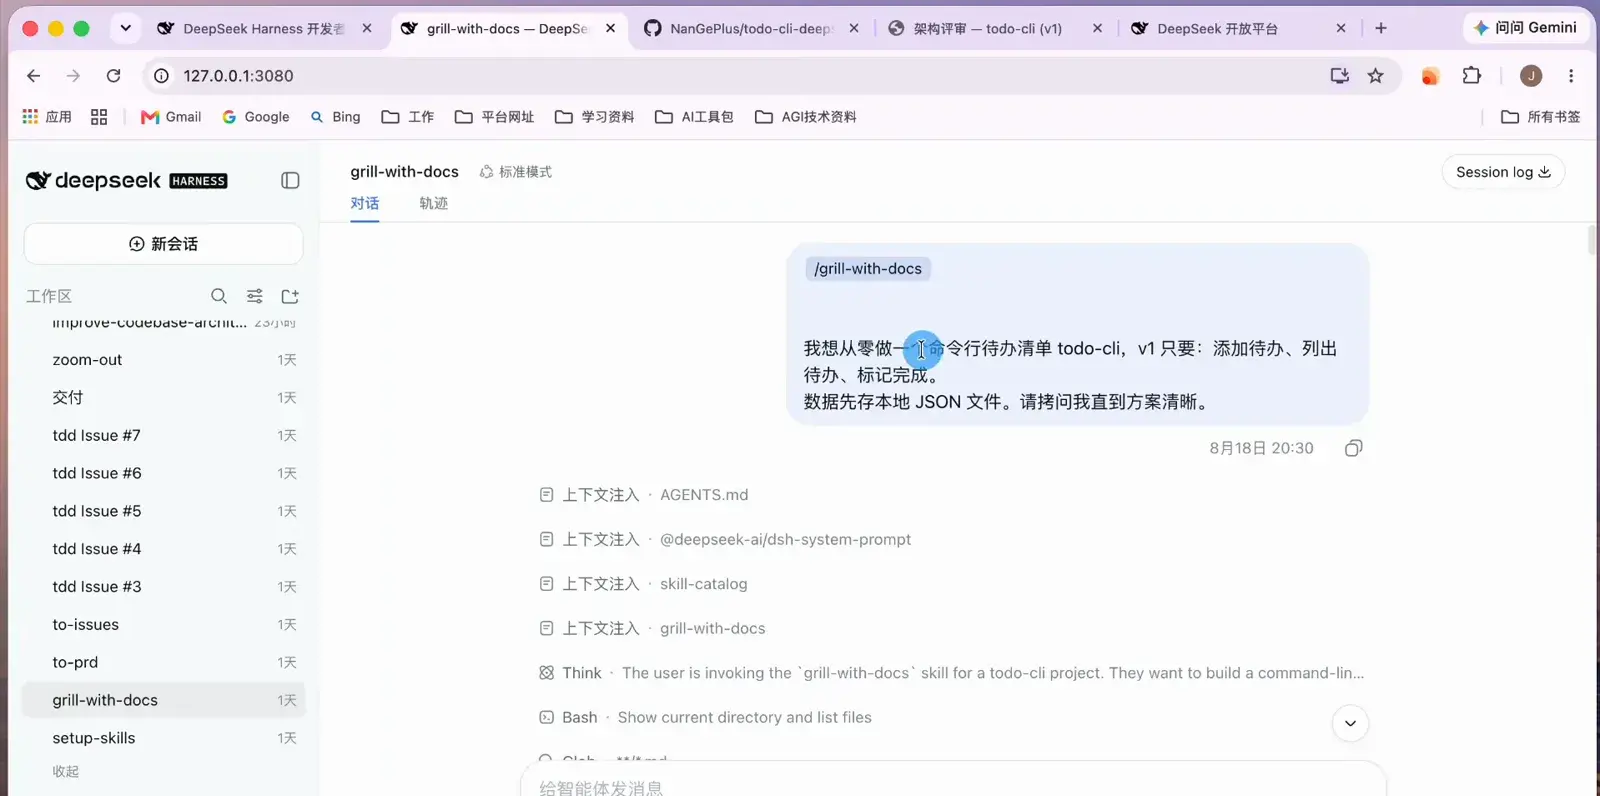
一切从这句「请拷问我,直到方案清晰」开始。跳到视频 3:06 处 - 4
拷问结果落成 CONTEXT.md 和技术栈 ADR
拷问下来的结论会写成两份人机共用的文档:领域术语(「待办」到底指什么、哪些词不许用)写进 CONTEXT.md;技术栈决策(只用 Python 3 标准库,并给出否决 Go 和 Node.js 的理由)写进 docs/adr/。命令行项目确认走 headless 模式后,UI 拷问直接结束,不生成多余文件。
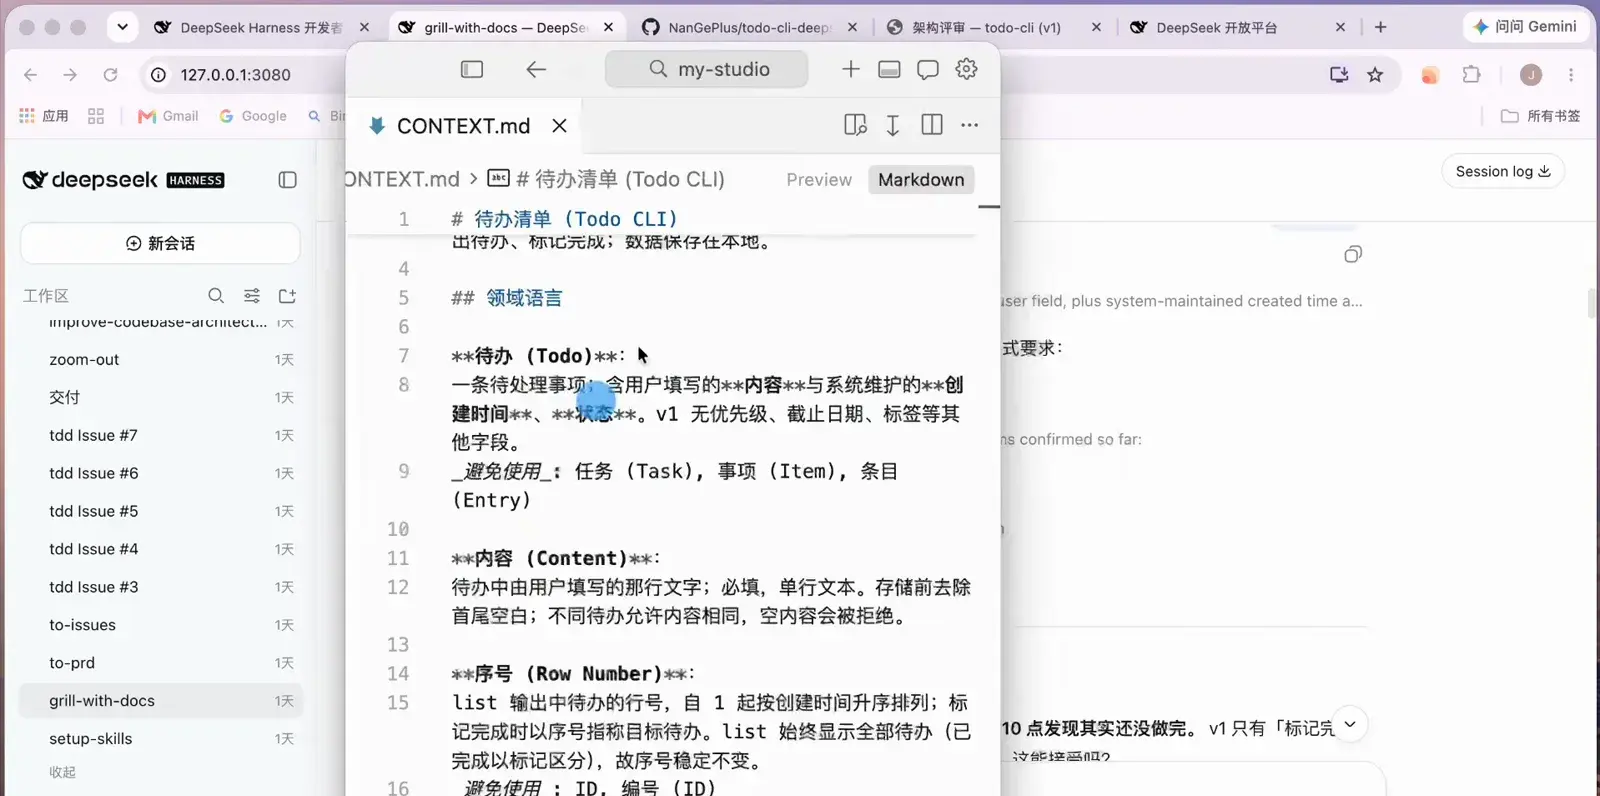
「待办」到底是什么,人和 Agent 看的是同一份定义。跳到视频 3:42 处 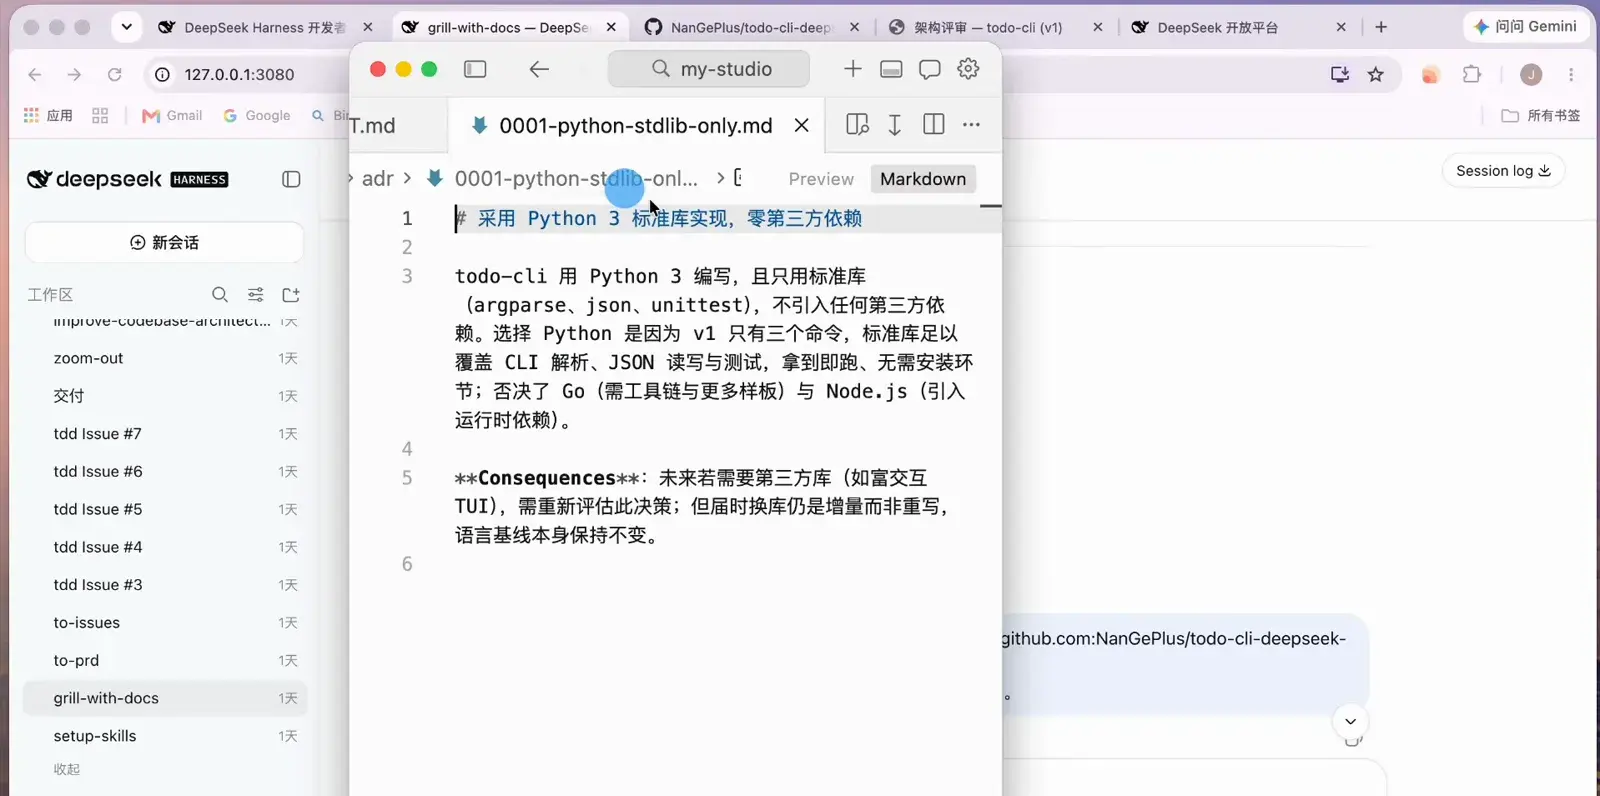
技术栈怎么定的、为什么,都落在 ADR 文件里。跳到视频 4:34 处 - 5
把定稿需求整理成 PRD
新开一个会话,让 Agent 把前面所有讨论整理成 docs/prd/todo-cli-v1.md:问题陈述、解决方案、验收标准,每一条都能回溯到 CONTEXT.md 的术语和 ADR 的决策。
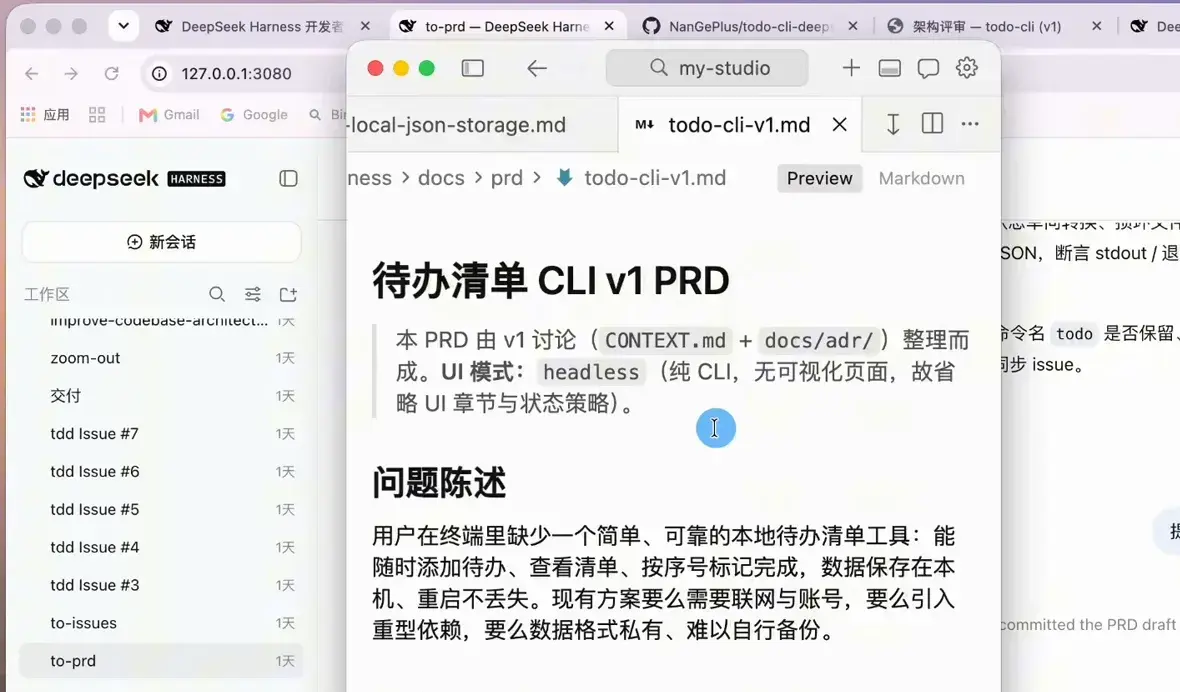
拷问定稿的东西,落成一份可以评审的 PRD。跳到视频 5:16 处 - 6
PRD 拆成任务单,推上 GitHub 统一管理
下一个会话把 PRD 切成 6 个互相独立的任务切片,以 issue 形式推到 GitHub:每个都带 ready-for-agent 标签、验收标准和依赖项;需要人来拍板的切片 6 则打上 ready-for-human。
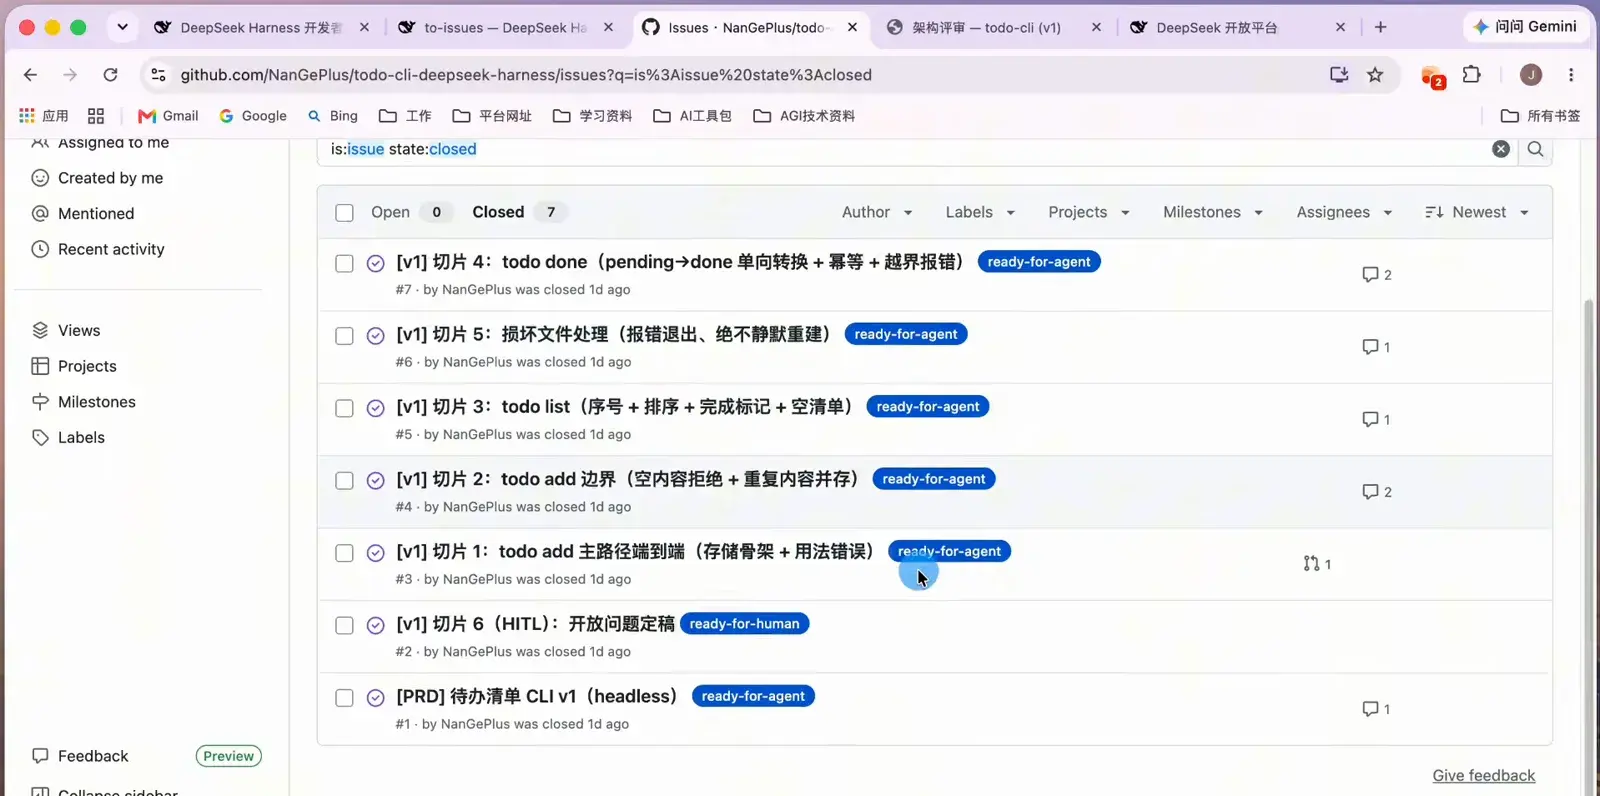
6 张任务单,验收标准和依赖项写得明明白白。跳到视频 5:52 处 - 7
逐单开发:领单、拉分支、TDD 红绿循环
每个任务单单独开一个会话,先从最新 main 拉分支,然后按 TDD 走:先写 RED 测试、跑出预期失败,再写最小实现变 GREEN,循环推进。单个切片完成后,Agent 会汇报交付了哪些文件、手工验证了什么,然后开 PR 等合并。
$从最新 main 拉取分支,准备实现 todo-cli 的 GitHub issue #3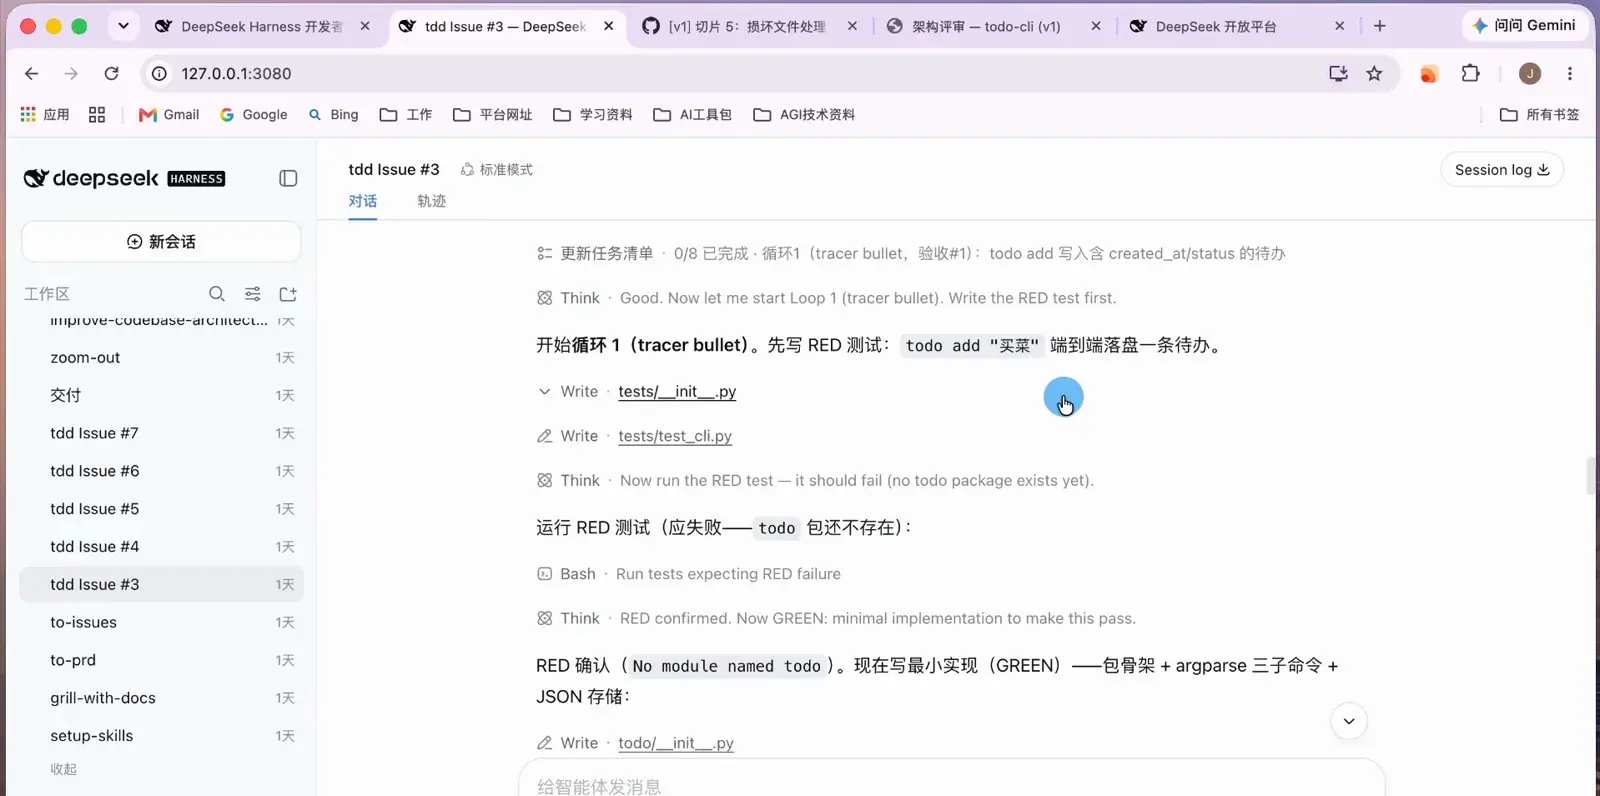
RED、预期失败、最小 GREEN——每个切片都这么滚出来。跳到视频 7:26 处 - 8
合进 main、写 README、真机验收
PR 合并后,只要验收标准全部通过,对应的 issue 会自动关闭。交付前让 Agent 写一份 README——安装、快速上手、命令参考——并用 pip 打包出全局 todo 命令。最后一步自己来:装上它,把 add、list、done 真正跑一遍。
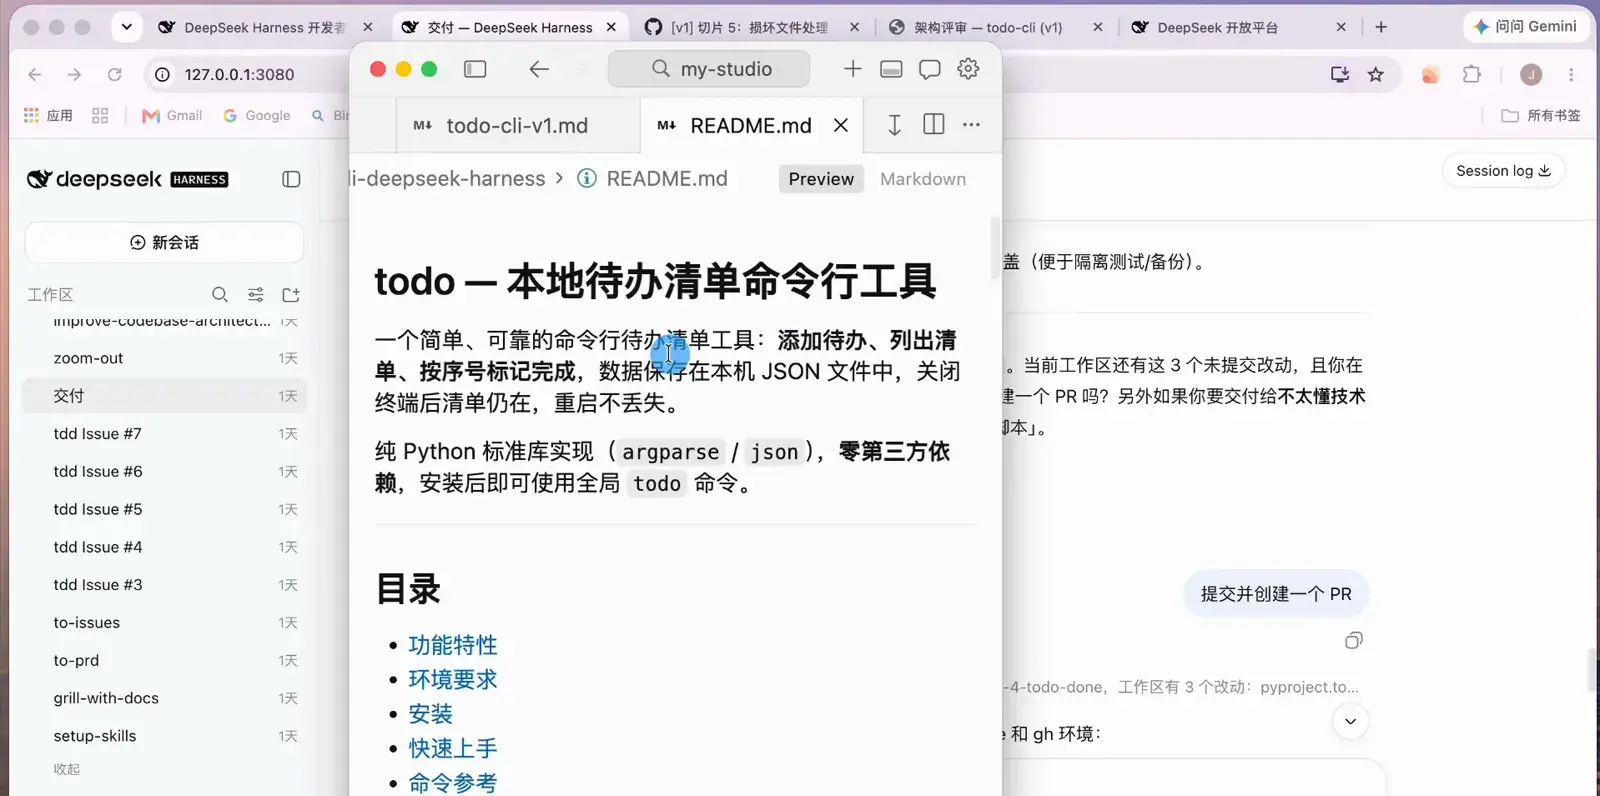
PR 一合,issue 自己关——验收标准全过才算数。跳到视频 9:18 处 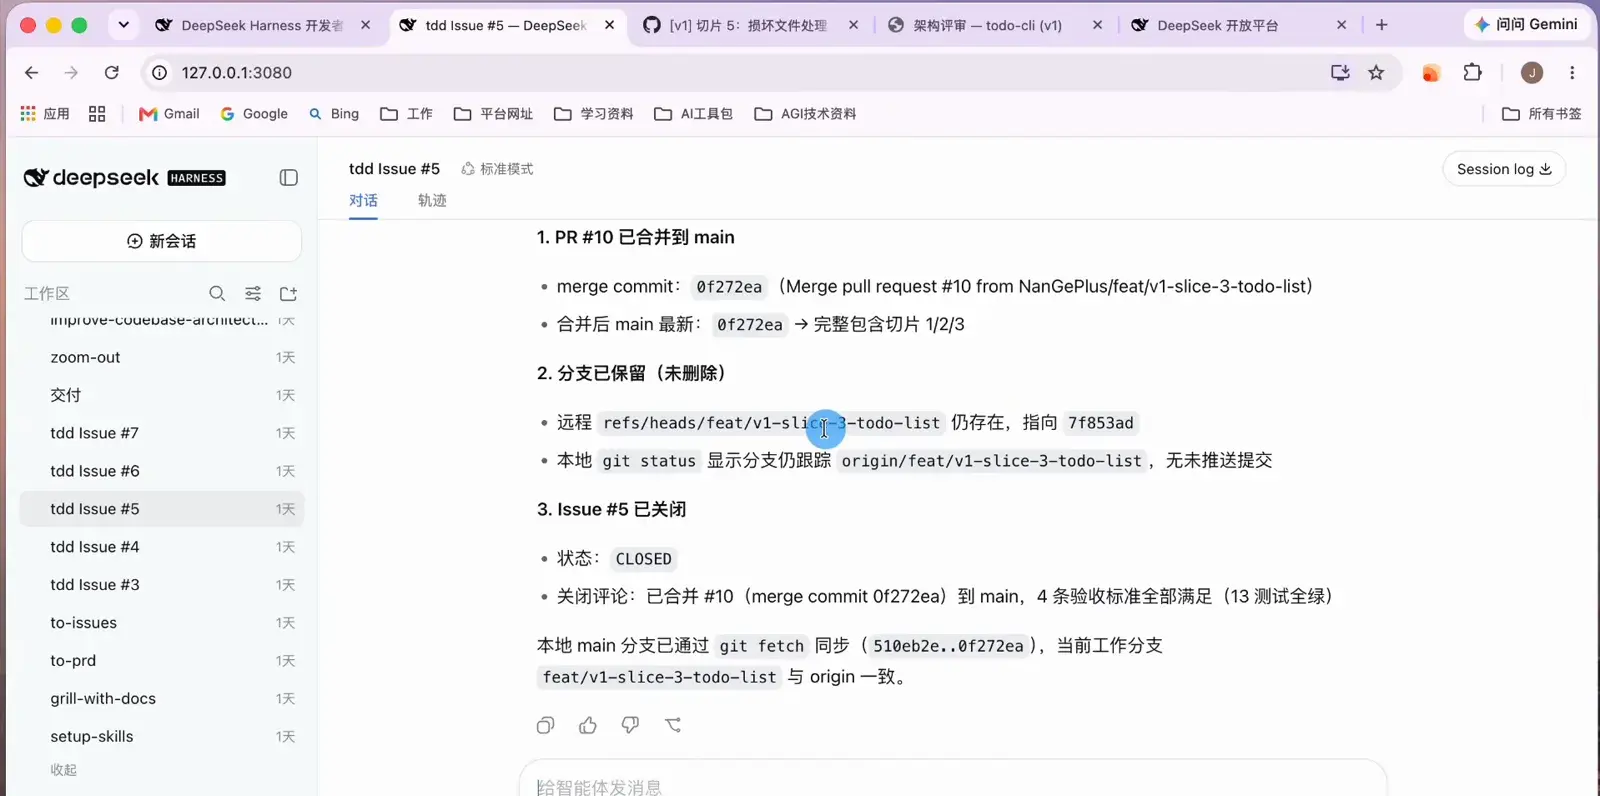
交付文档也交给 Agent 起草,你只需要把关。跳到视频 9:02 处 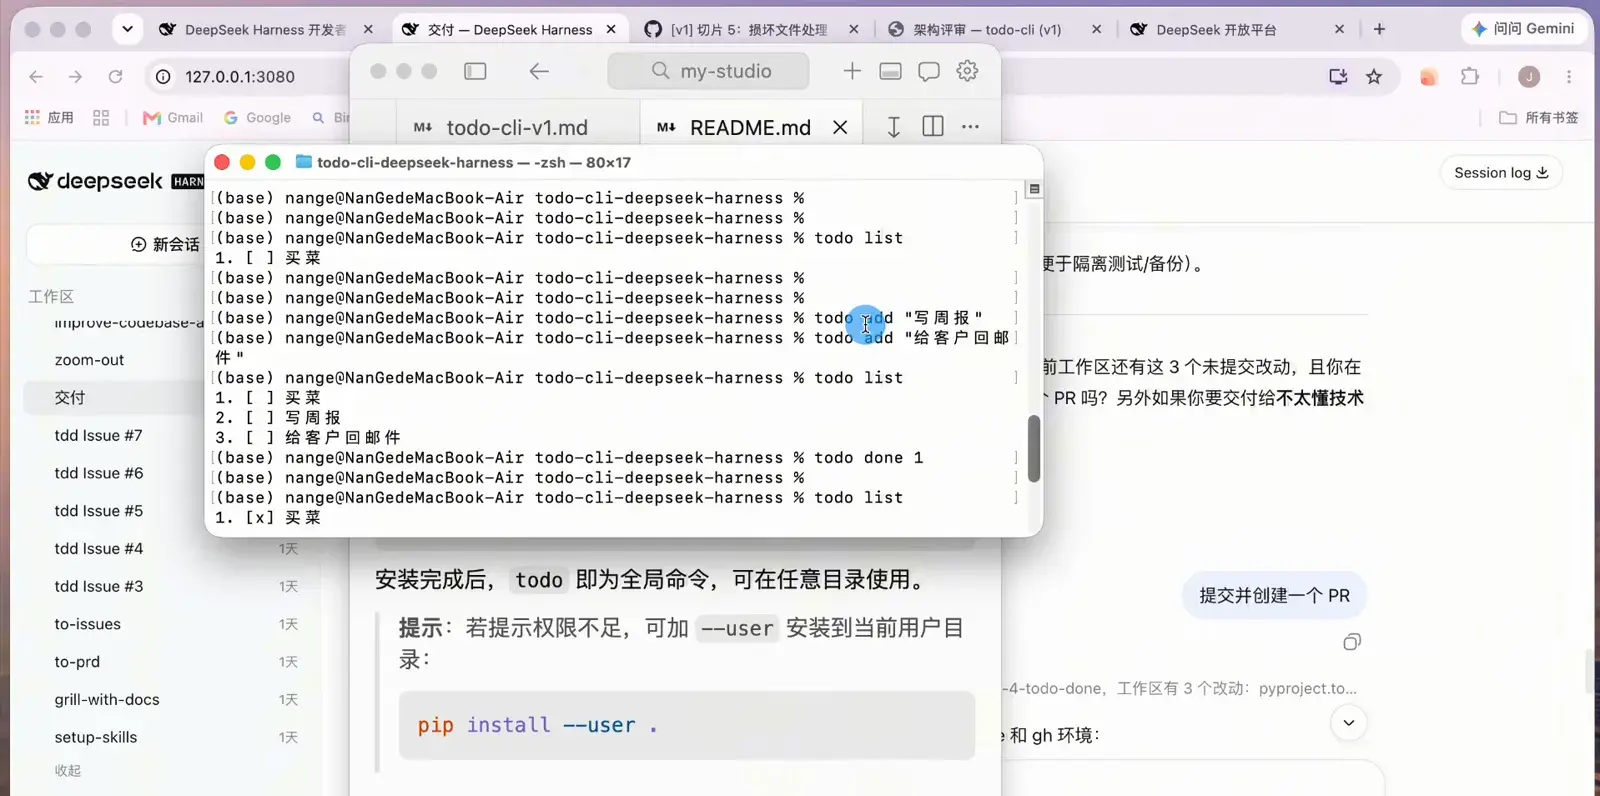
最后一关:对着真二进制把三条命令跑通。跳到视频 9:36 处
常见问题
关于用 DeepSeek Harness 做真实项目的高频疑问,一次说清。
不会写代码,也能照这个流程做项目吗?
可以。源视频的作者全程没打开过编辑器,需求、验收、合并都靠回答问题和看 PR。拷问环节和验收标准存在的意义,就是让你不需要懂语法、只需要懂业务。
CONTEXT.md 是什么?为什么这么重要?
它是拷问环节产出的领域词汇表:项目里每个关键术语(「待办」是什么、哪些词不许用)都有一份人和 Agent 共用的定义。没有它,「待办」在你的脑子里和 Agent 生成的代码里可能是两个东西——这是 AI 编码最常见的翻车点。
需求拷问可以跳过吗?
能跳,但别跳。跳过拷问等于让 Agent 自己脑补所有空白,而这些假设会在开发阶段变成返工。领域、技术、UI 三个方向的盘问,是整个流程里纠错最便宜的地方。
中途做错了怎么办?怎么回退?
三道保险:轨迹面板记录了每一次工具调用,能定位到哪一步开始跑偏;每个切片都在自己的 git 分支上做,坏的切片碰不到 main;PR 必须过验收标准才能合并,main 随时是可交付状态。
项目数据存在哪里?会上传吗?
代码和文档都存在你本地的工作区目录,由 git 管理并推到你自己的 GitHub 仓库(演示项目是私有仓库);待办数据按需求约定存在本地 JSON 文件。外发的只有你自己配置的模型 API 调用——Key 换成哪家,数据就走哪家。
一定要用 DeepSeek 官方模型吗?
不必。设置 → 模型里可以添加其他模型和自定义提供方,兼容 OpenAI 接口的第三方代理也能接。视频演示用的是 DeepSeek 官方 API Key,但流程本身不绑定任何一家模型。
相关攻略
这个流程用到的每一块能力,都有更深入的拆解。
来源与致谢
所有画面均取自一次在 DeepSeek Harness Web 端完整录下的实战过程。命令与文件名以视频画面为准;每张图都可跳回来源视频的对应秒数。