
dsh-tab-complete
精選清單收錄維護狀態: 活躍dingchenhui0618-arch/dsh-tab-complete
Tab 補全:用模型預測你在 DeepSeek Harness 輸入框裡接下來要打的字,灰色幽靈文本 + Tab 一鍵填入(Codex Pro 那套輸入預測的 DSH 版)
$ dsh plugin add dsh-tab-complete1
星數
0
Fork
JavaScript
語言
MIT
授權條款
2026-10-21
建立於
2026-11-09
最近推送
README
dsh-tab-complete


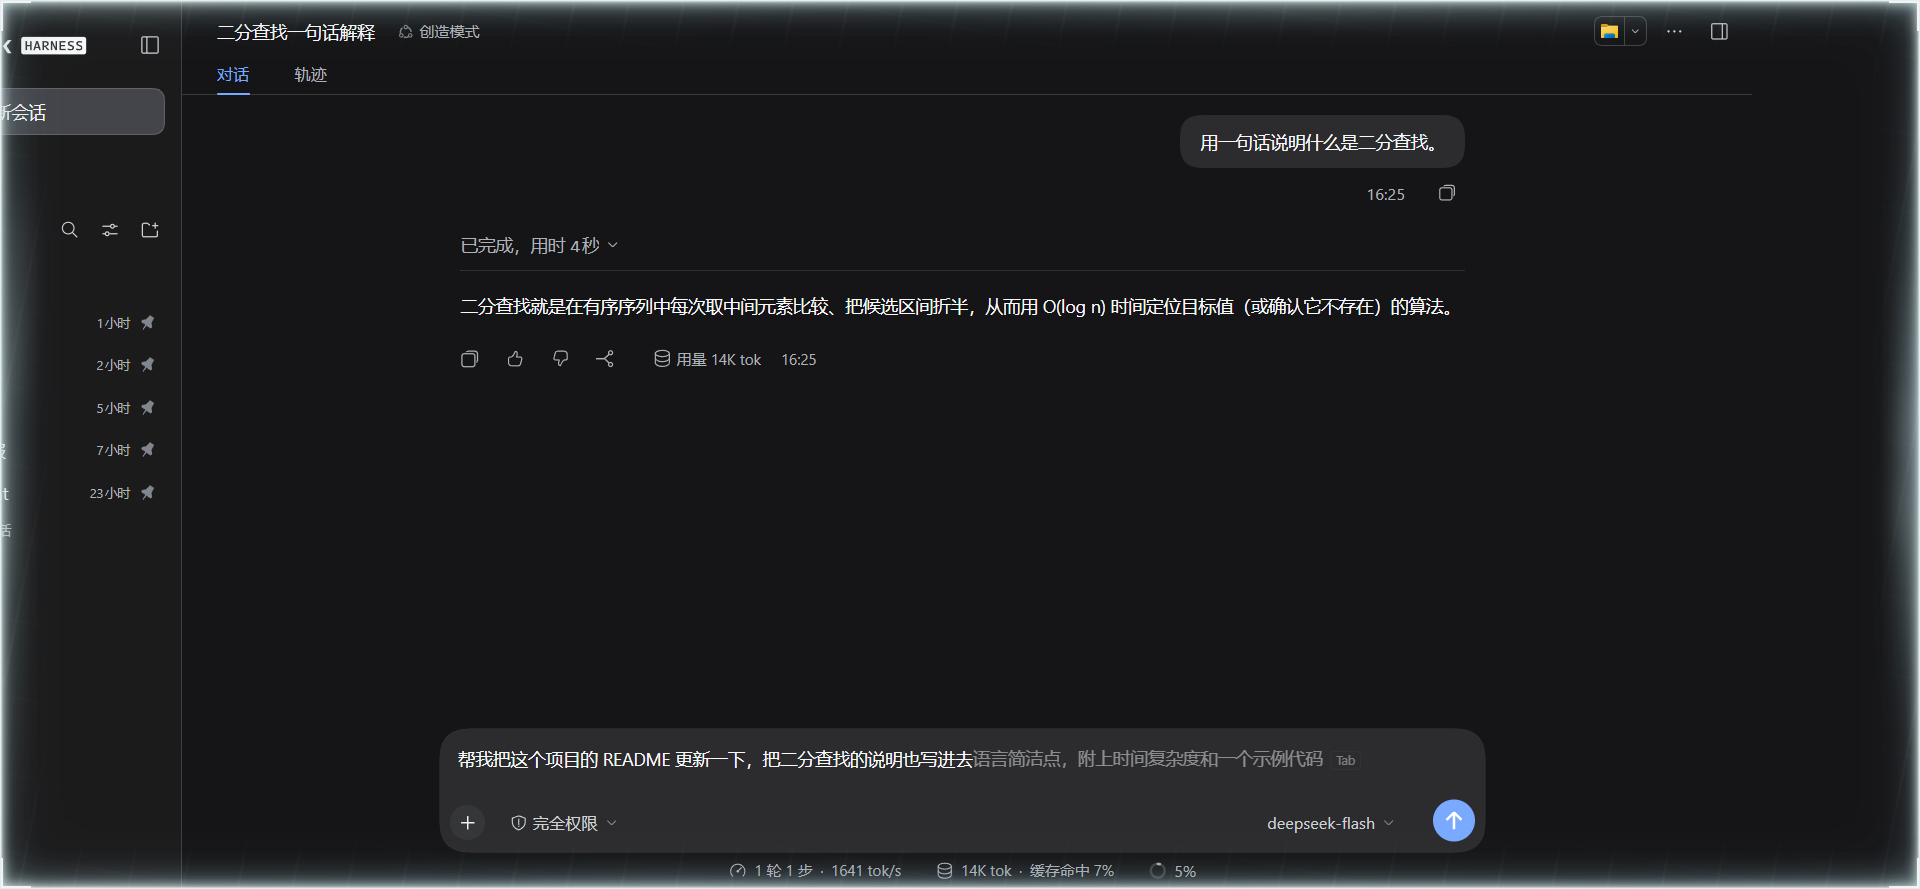
在 DeepSeek Harness 的输入框里,用当前对话和你已经打的字,预测你接下来要输入的内容:灰色幽灵文本贴在光标后面,按 Tab 一键填入,按 Alt+→ 只收第一句,按 Esc 忽略。
这是 Codex Pro「下一步输入预测」的 DeepSeek Harness 版本。区别只有一处:预测走你自己的模型路由,不吃订阅额度。
用着还行的话,点个 ⭐ 就够了——插件市场的「搜插件」按 GitHub star 排序,star 是这个插件能被人翻到的唯一杠杆。
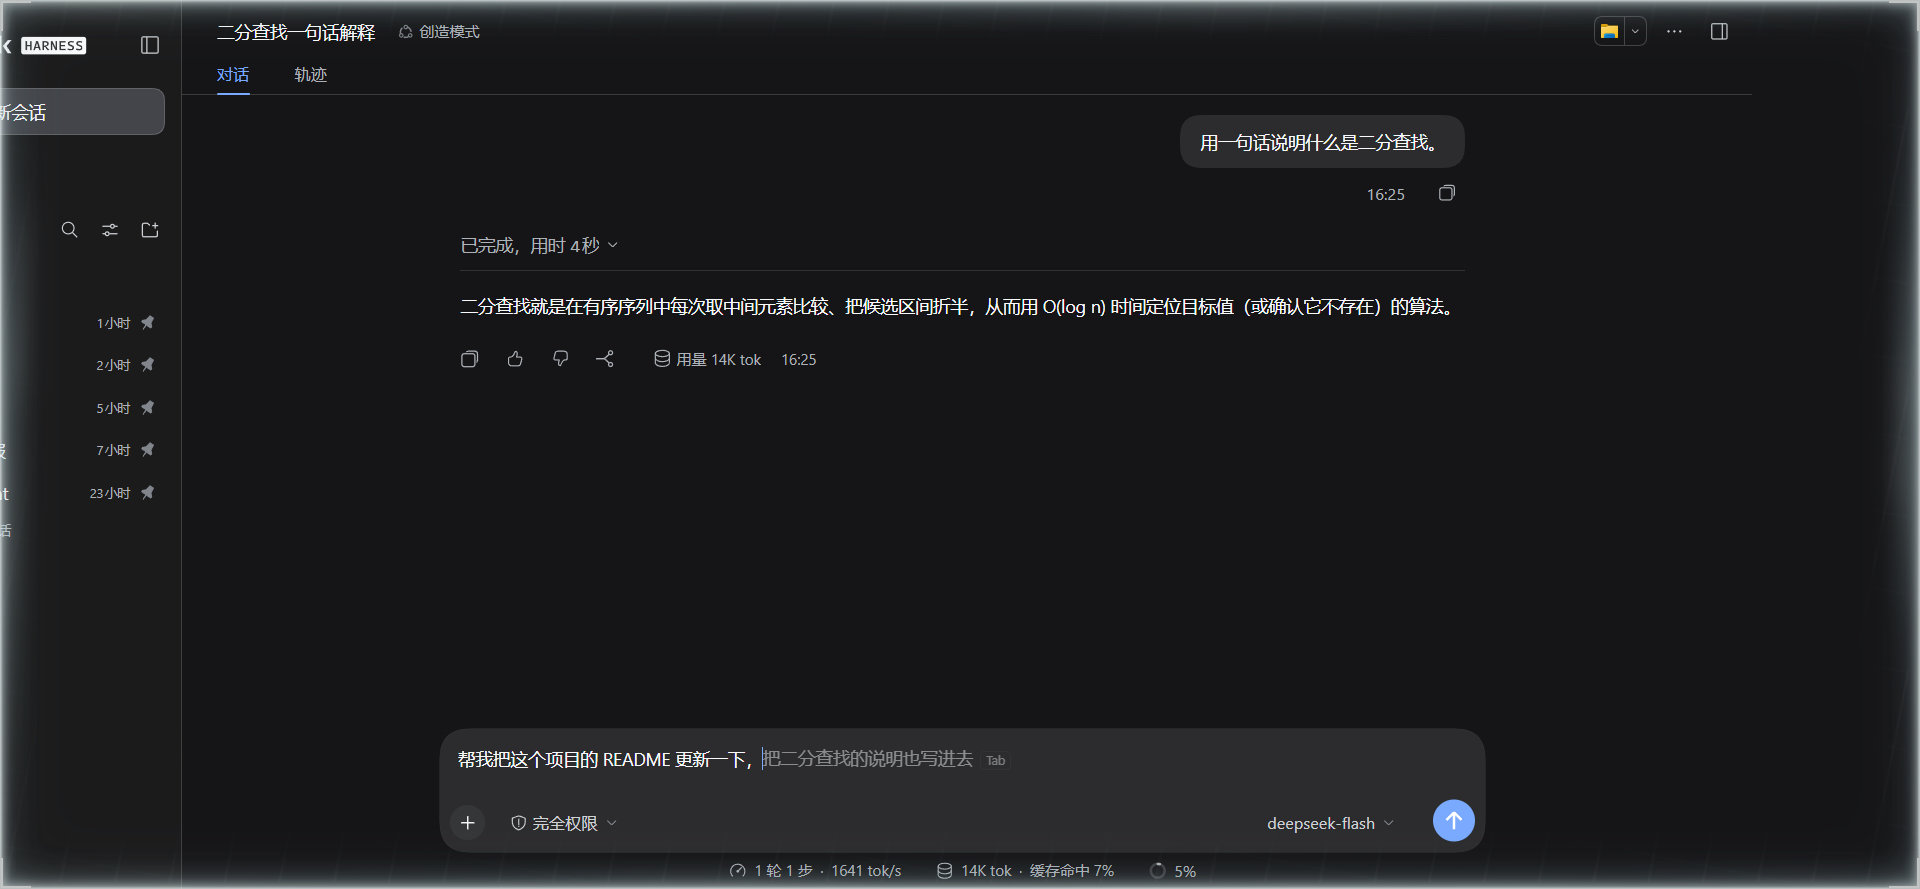
三个键
| 键 | 作用 |
|---|---|
| Tab | 整句收下(最快的路径:一次按键,直接可发) |
| Alt+→ | 只收第一句,剩下的继续当幽灵;一句一句往下收,改起来比整段删掉轻松 |
| Esc | 丢掉这条,本轮不再问 |
Alt+→ 只在建议里确实还有第二句时才提示(幽灵后面会多一个 Alt+→ 小标签),单句建议按了等同于 Tab,不会误伤。
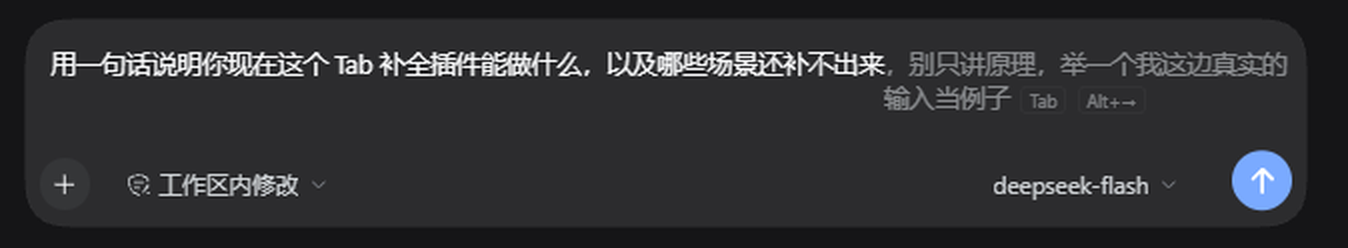
它什么时候会给建议
| 时机 | 行为 |
|---|---|
| 你在输入框里打字 | 停手约 0.28 秒后,把这句话补完 |
| 你刚发完一条消息、输入框是空的 | 基于这段对话,预测你的下一句(用户口吻,不是助手口吻) |
| 候选是助手刚说过的话的复述 | 直接丢弃,不显示 |
| 候选是「先查日志,再跑测试」这类执行步骤 | 直接丢弃——那是助手该干的事,不是你会说的话 |
| 你在用输入法(IME)拼字 | 不预测,避免和候选栏打架 |
输入框以 / 开头 |
不预测,那是命令面板 |
给的是整句而不是半句:一次 Tab 就能直接发出去,不需要你接着往下想。对话里的文件、函数、版本号会被沿用;模型编不存在的路径(src/plugins、index.ts 这种)会被提示词按住。
只把「你和助手说过的话」喂给模型——技能目录、运行时上下文这类框架注入会被 isScaffolding() 挡掉。这很关键:它们一旦混进去就会吃光上下文预算,让预测变成对着技能列表瞎猜。
它会越用越像你。 每次你按 Tab 收下建议,那句话就被记进 ~/.dsh/tab-complete-style.json(最多 40 条,只在本机),之后作为「他以前收下过的写法」参与提示词。同一句话收下第二次、只是尾巴更长时,会替换旧的那条而不是占两个槽位(实测 40 条里有 5 对是这种重复,占掉 25% 预算)。看不顺眼可以清空:
curl.exe "http://127.0.0.1:3080/dsh-tab-complete/style"                       # 看记了什么
curl.exe -X POST "http://127.0.0.1:3080/dsh-tab-complete/style" -d '{"clear":true}'   # 清空
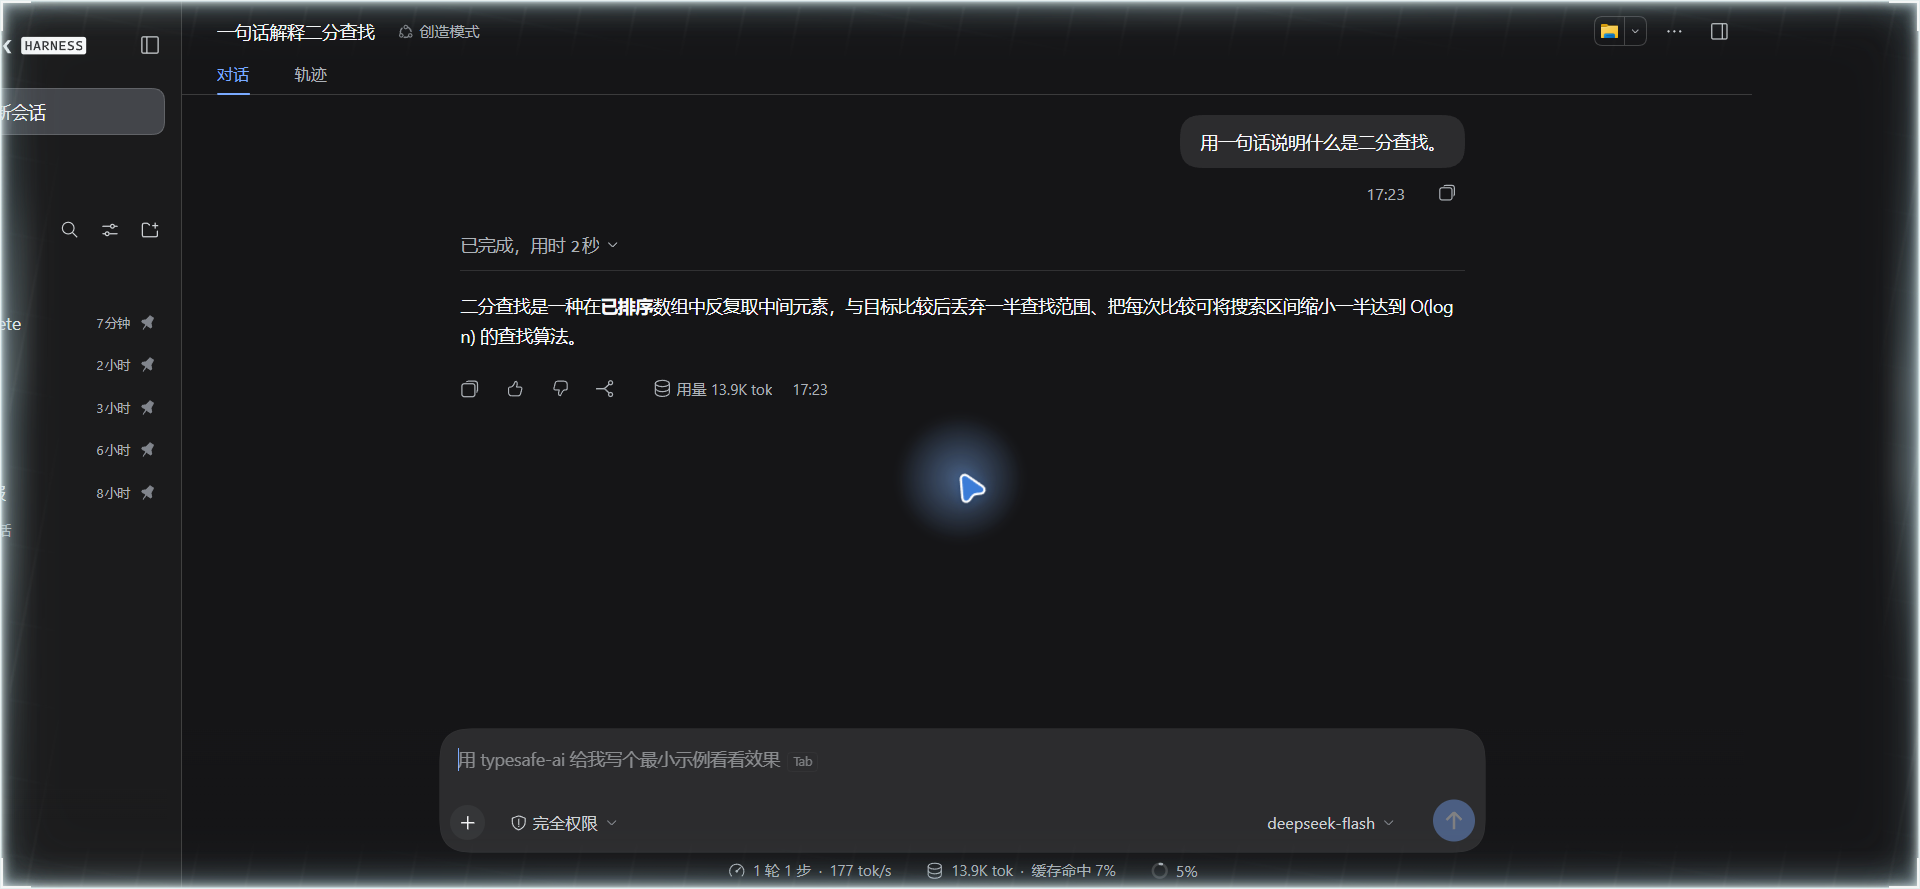
按 Tab 之后:幽灵文本变成真正的文字,光标停在末尾,接着就能改。
和同类比,数字说话
这个品类在 DSH 市场里已经很挤:截至 2026-11,公开的「预测下一句 + 幽灵文本 + Tab 收下」插件至少有 16 个。挑几个最能打的:
| 插件 | 星 | 它的长处 |
|---|---|---|
| Lphehe/dsh-composer-assist | 17 | 设置面板:自动/逐词/两者/仅手动、建议栏或行内、置信度门槛、接受学习(默认关) |
| Xiaofei-fei/dsh-prompt-history | 10 | 终端式输入框:↑/↓ 历史、前缀搜索、Ctrl+R,外带预测 |
| studyzy/dsh-suggest-prompt | 7 | 工程最完整:脱敏、语义过滤(助手口吻直接丢弃)、负缓存、快捷键录制 |
| Stijnus/dsh-composer-predictions | 2 | Alt+↑/↓ 换候选 + 草稿内联补全 |
它们都比这个插件功能多。这个插件只在三件事上不一样:
- 给数字,而不是给形容词。 同类 README 里几乎找不到效果数据(一家的 README 直接写
not_evaluated:「60 条质量集尚未跑完,不能证明优于同类」)。下面这张表是本插件在真实会话上跑出来的,方法在「它是怎么被调的」一节,可复跑。 - 会主动闭嘴。 开头是执行动词、又带技术对象(日志/配置/测试/文件…)或「先…,再…」计划的预测不显示——那是助手该干的活。实测这类占 13%,平均 2.21 分,且没有误伤任何一条高分预测。
- 空输入框也能一次 Tab 发出去,而且和「打了一半」共用同一条链路(部分同类只做其中一种)。
实测(真实会话样本,另一模型当评审打 0–10 分,判据是「这句话像不像你本人会紧接着发出来」):
| 场景 | 平均分 | 及格(≥7) | 说明 |
|---|---|---|---|
| 空输入框,猜你下一句 | ≈3 | 0 / 15 | 收到结果后你往往直接换话题,模型没有依据 |
| 你已经打了几个字 | ≈4.7 | 2 / 15 | 方向被你限定住了,这才是它擅长的 |
| 0.2.0 旧版(不分场景) | 3.6 | 1–2 / 20 | 提示词里混进了框架注入,在对着技能目录瞎猜 |
也测了「多给几条候选、挑最好的」这条路:3 条候选里最好那条平均只有 3.33 分,36 个候选 0 个及格。所以这个插件没做候选轮换——方向错不是多给几次机会能救的,不如用 Alt+→ 让你改得轻松。
安装
插件是标准的 DSH bundle:宿主半边注册一条 HTTP 路由,客户端半边挂在 conversation.input.overlay 插槽上。
在 profile 目录(~/.dsh/profiles/<profile>/)里加两处:
// package.json
{
  "dependencies": {
    "dsh-tab-complete": "link:D:/Projects/dsh-tab-complete"  // 或 npm 版本号
  },
  "dsh": {
    "profile": {
      "bundles": ["...", "dsh-tab-complete"]
    }
  }
}
然后安装并重启 Harness:
cd $env:USERPROFILE\.dsh\profiles\desktop
pnpm install
重启后窗口里的输入框就有这个能力;已经在跑的会话不会丢,会话记录是落盘的。
配置
宿主侧配置写在 bundle 的 cordis.patch.yml 对应条目下,全部可省略:
- id: dsh-tab-complete
  config:
    enabled: true
    debounceMs: 280        # 停手多久后请求
    maxTokens: 64          # 生成上限(一句话够用;调大只会更慢)
    maxCompletionChars: 180
    contextMessages: 6     # 送给模型的历史消息条数
    contextChars: 2200
    minDraftChars: 0       # 空输入框也预测,设成 2 就要求先打两个字
    suppressSteps: true    # 丢弃「先查日志,再跑测试」这类助手口吻的执行步骤
    provider: ""           # 留空则用当前会话的默认模型路由
    model: ""
运行时可查状态、可临时开关(内存态,重启复位):
curl.exe http://127.0.0.1:3080/dsh-tab-complete/state       # 需要浏览器同款 cookie
curl.exe -X POST http://127.0.0.1:3080/dsh-tab-complete/enabled -d '{\"enabled\":false}'
curl.exe "http://127.0.0.1:3080/dsh-tab-complete/transcript?sessionId=<id>"   # 这次补全真正会发给模型的对话
curl.exe "http://127.0.0.1:3080/dsh-tab-complete/prompt?sessionId=<id>&draft=<草稿>"   # 完整 system + user 提示词
速度
一次建议 = 静默时间(默认 280ms)+ 模型首 token 延迟。第二段来自模型本身,插件替不了它;所以补全走流式:第一个 token 到达就把幽灵画出来,之后逐字长出来,而不是等整句生成完再一次性出现。
如果仍然嫌慢,可以给补全单独指定路由(不影响主会话):
- id: dsh-tab-complete
  config:
    provider: <provider>
    model: <model>
别用推理型模型。 它们会先把 token 花在思考上,maxTokens: 64 全部被吃掉,流里一个可显示的字都没有——表现是「一次都不出幽灵」,不是慢。实测 glm-5.3-flash、qwen3.7-plus 就是这样,deepseek-flash 这类直出模型的 p50 约 2.4 秒。要换模型,先跑一次:
curl.exe -X POST "http://127.0.0.1:3080/dsh-tab-complete/replay" -H "content-type: application/json" -d "{\"messages\":[{\"role\":\"user\",\"text\":\"你好\"}],\"draft\":\"\",\"provider\":\"<provider>\",\"model\":\"<model>\"}"
返回里 completion 为空就说明这个模型不能用。
同一「会话 + 草稿」在缓存里命中是 0 延迟;GET /dsh-tab-complete/state 里的 lastMs 就是上一次真实耗时。
成本与隐私
- 每次预测是一次独立的小模型调用(
maxTokens: 64,一句话),不写进会话记录,也不消耗 Harness 的上下文。 - 只接受来自 loopback 的请求;请求体上限 64 KB。
- 同样的「会话 + 草稿」结果缓存 2 分钟;"模型也没想出来"缓存 20 秒,避免空输入框反复花钱。
- 同一会话同时只保留一个在飞请求,新请求会中断旧的。
- 采纳记忆只写在
~/.dsh/tab-complete-style.json,不联网、不进 git,{clear:true}一键清空。 - 使用计数只在
~/.dsh/tab-complete-stats.json:收了 / 收一句 / 按 Esc 各多少次,没有别的。
它到底有没有用:线上计数
离线评测回答「改得对不对」,线上计数回答「这几天值不值」。所有幽灵被怎么处理都会被记下来,跨重启保留:
curl.exe http://127.0.0.1:3080/dsh-tab-complete/state
更多「語音」外掛
dsh-plugin-tts
作者 1624318455
Edge TTS 語音朗讀外掛:朗讀回覆、自動朗讀開關,免費無需 API key
dsh-voice-scribe
作者 pensivefei
語音輸入外掛:按 Alt 說話,文字直接進輸入框;預設 Web Speech 零配置,可選相容 OpenAI 的 ASR。
dsh-voice-ai-girlfriend
作者 beiyege-01
語音 AI 女友(Voice AI girlfriend for DeepSeek Harness):Whisper 語音輸入 + Qwen3-TTS 聲音克隆 + 句子級流式朗讀 + 數字人動畫窗。插話/排隊雙模式,說話即打斷。
dsh-localtts
作者 abbccdd
DeepSeek Harness 的本地 IndexTTS 2.5 與 GPT-SoVITS 語音合成與播放。